你是几B的模型·复盘
几百粉丝、零投放,3 天约 4 万人来测。从 4 条消息的原型,到 237 条消息做成产品,再到按数据改了几十个版本:一次人和 AI 协作整活的完整记录。
从 4 条消息到上线,我和 AI 的一天
这是一个三篇的复盘。上篇讲从一个念头到上线;中篇讲上线后 36 小时里怎么按数据改产品;下篇讲它怎么传出去,以及 1.27 万份答卷里挖出来的好玩的东西。
9 月 27 日下午 3 点,我发了一条推,放出一个小网页:你是几B的模型?
76 道题,你扮演一个大模型答题:数 strawberry 里有几个 r,比 9.11 和 9.9 谁大,被用户越狱,在“1 美元买车”“转人工”这些名场面里选你怎么回。答完之后,网页给你开一场“模型发布会”:参数量、MoE 还是 Dense、跑分表、AI 智能指数排第几、已知问题,以及你是什么型的 AI 人格。
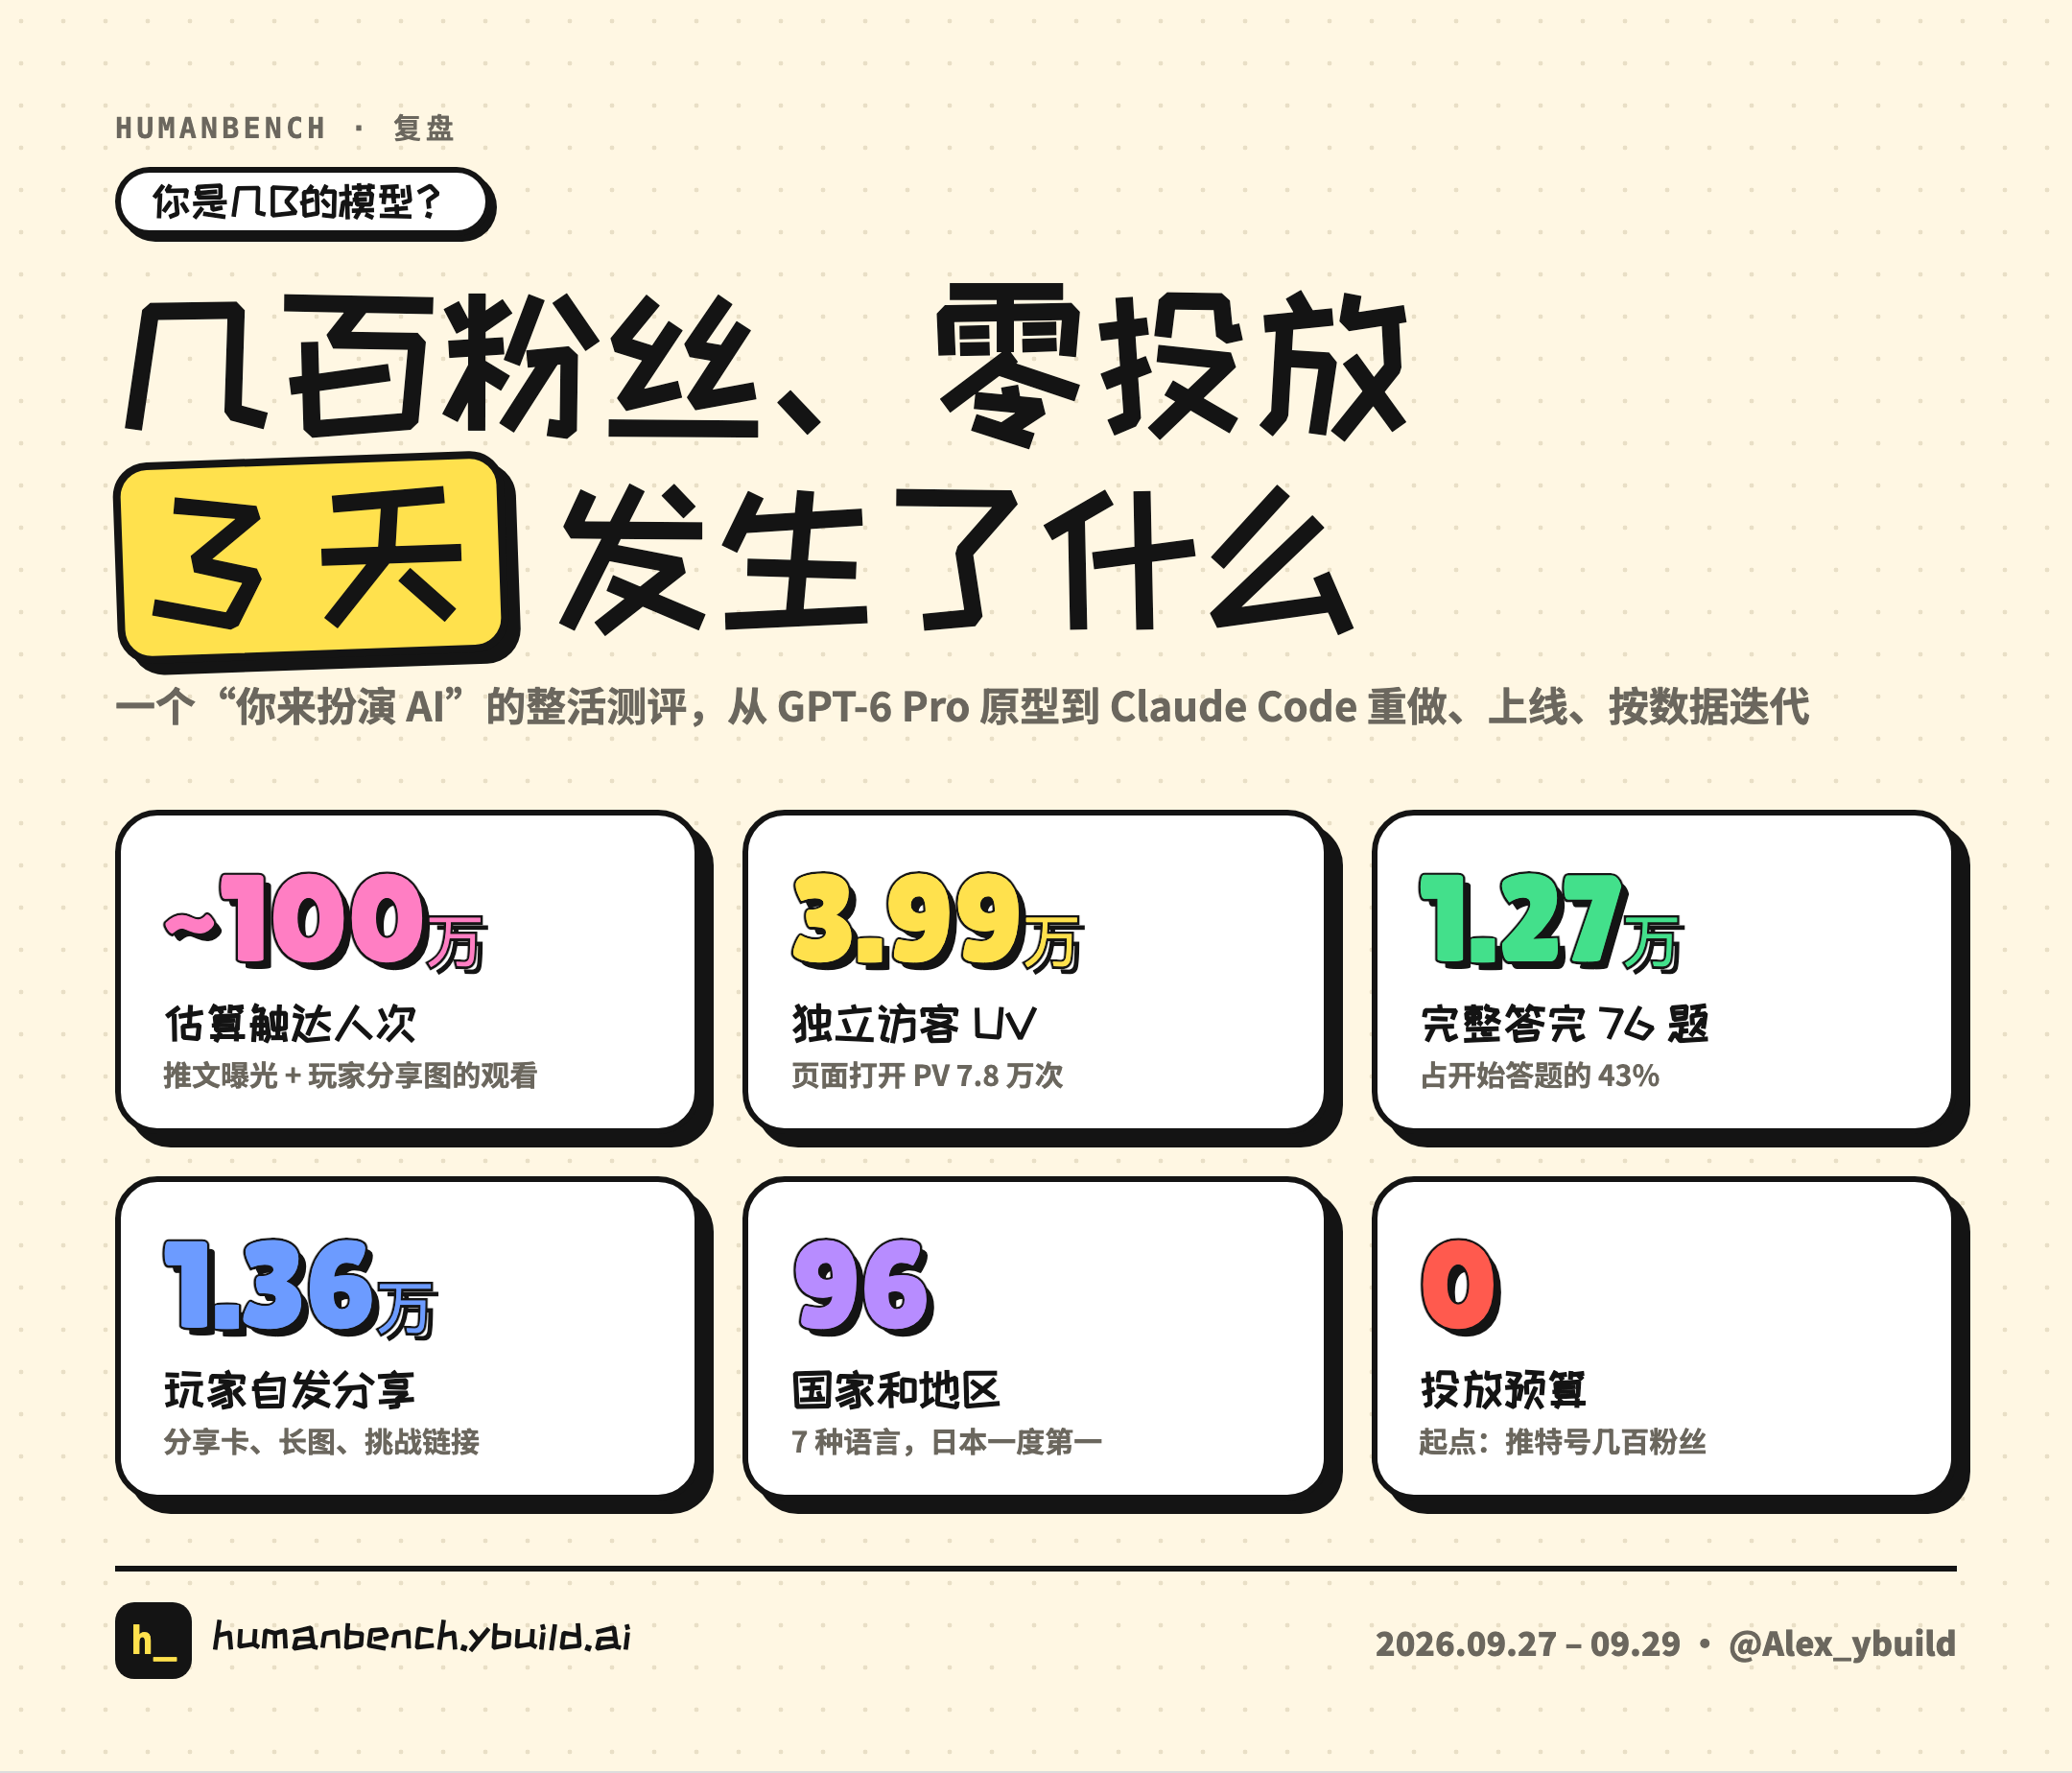
三天下来:约 4 万独立访客、7.8 万次打开,1.27 万人完整答完 76 题,自发分享 1.36 万次,来自 96 个国家和地区。起点是一个只有几百粉丝的推特号,没有投放。
我从 GPT-2 时代就开始折腾各种模型,用得很深,也用了很多年。这次给自己定了个规矩:不亲手写代码,全部交给 AI,我只做判断,看看它能把一个产品做到什么程度。先是在 ChatGPT 里和 GPT-6 Pro 发了 4 条消息做出原型,然后在 Claude Code 里和 Claude 一起重做、上线、迭代。到上线那一刻,我在 Claude Code 里发了 86 条消息。
这篇尽量贴着原话写,包括我打错的字,以及 Claude 跑偏、我拍错板的地方。
关于素材:我的原话全部来自开源仓库里的 prompts/ 目录(已脱敏);Claude 的回复从会话记录里摘录,其中有两段它用英文回的,这里是中文意译。时间都是当地时间。
一、GPT-6 Pro 的一个半小时:一个“学术版”
9 月 26 日下午两点半,我在 ChatGPT 里随手打了一句:
想到一个有意思的小app:测测你的参数。就是模拟用户各种输入,来看你相当于什么参数的模型 告诉你在artificial index上排名是什么百分位
然后又补了三条:
要混合了科学依据➕有梗 要有题库 要自适应……严肃活泼
第三条加了 strawberry、50 米洗车这些经典陷阱题,要能分享、能自填 ID,要有发布会表格、AA 柱状图、参数,还要告诉你“你是什么模型人格(比如豆包型人格)”。第四条是:“不对 你把整体的完整包打包给我”。
GPT-6 Pro 前后回复了 110 次,调用了 78 次工具,一个半小时后交出一个压缩包:
- 单文件网页,528 道题:六个能力维度各 56 道,加上陷阱题、人格题、开放表达;
- 六维自适应测评,能力和人格两条轨道,输出带置信区间的报告;
- 玩家要先选轻量、标准、深度三档题量,还要勾选“我理解:这是未标定的实验测评”;
- 7 种自创的人格,导出一张 1200×2530 的长图;
- 产品文档、QA 截图、测试脚本,一应俱全。
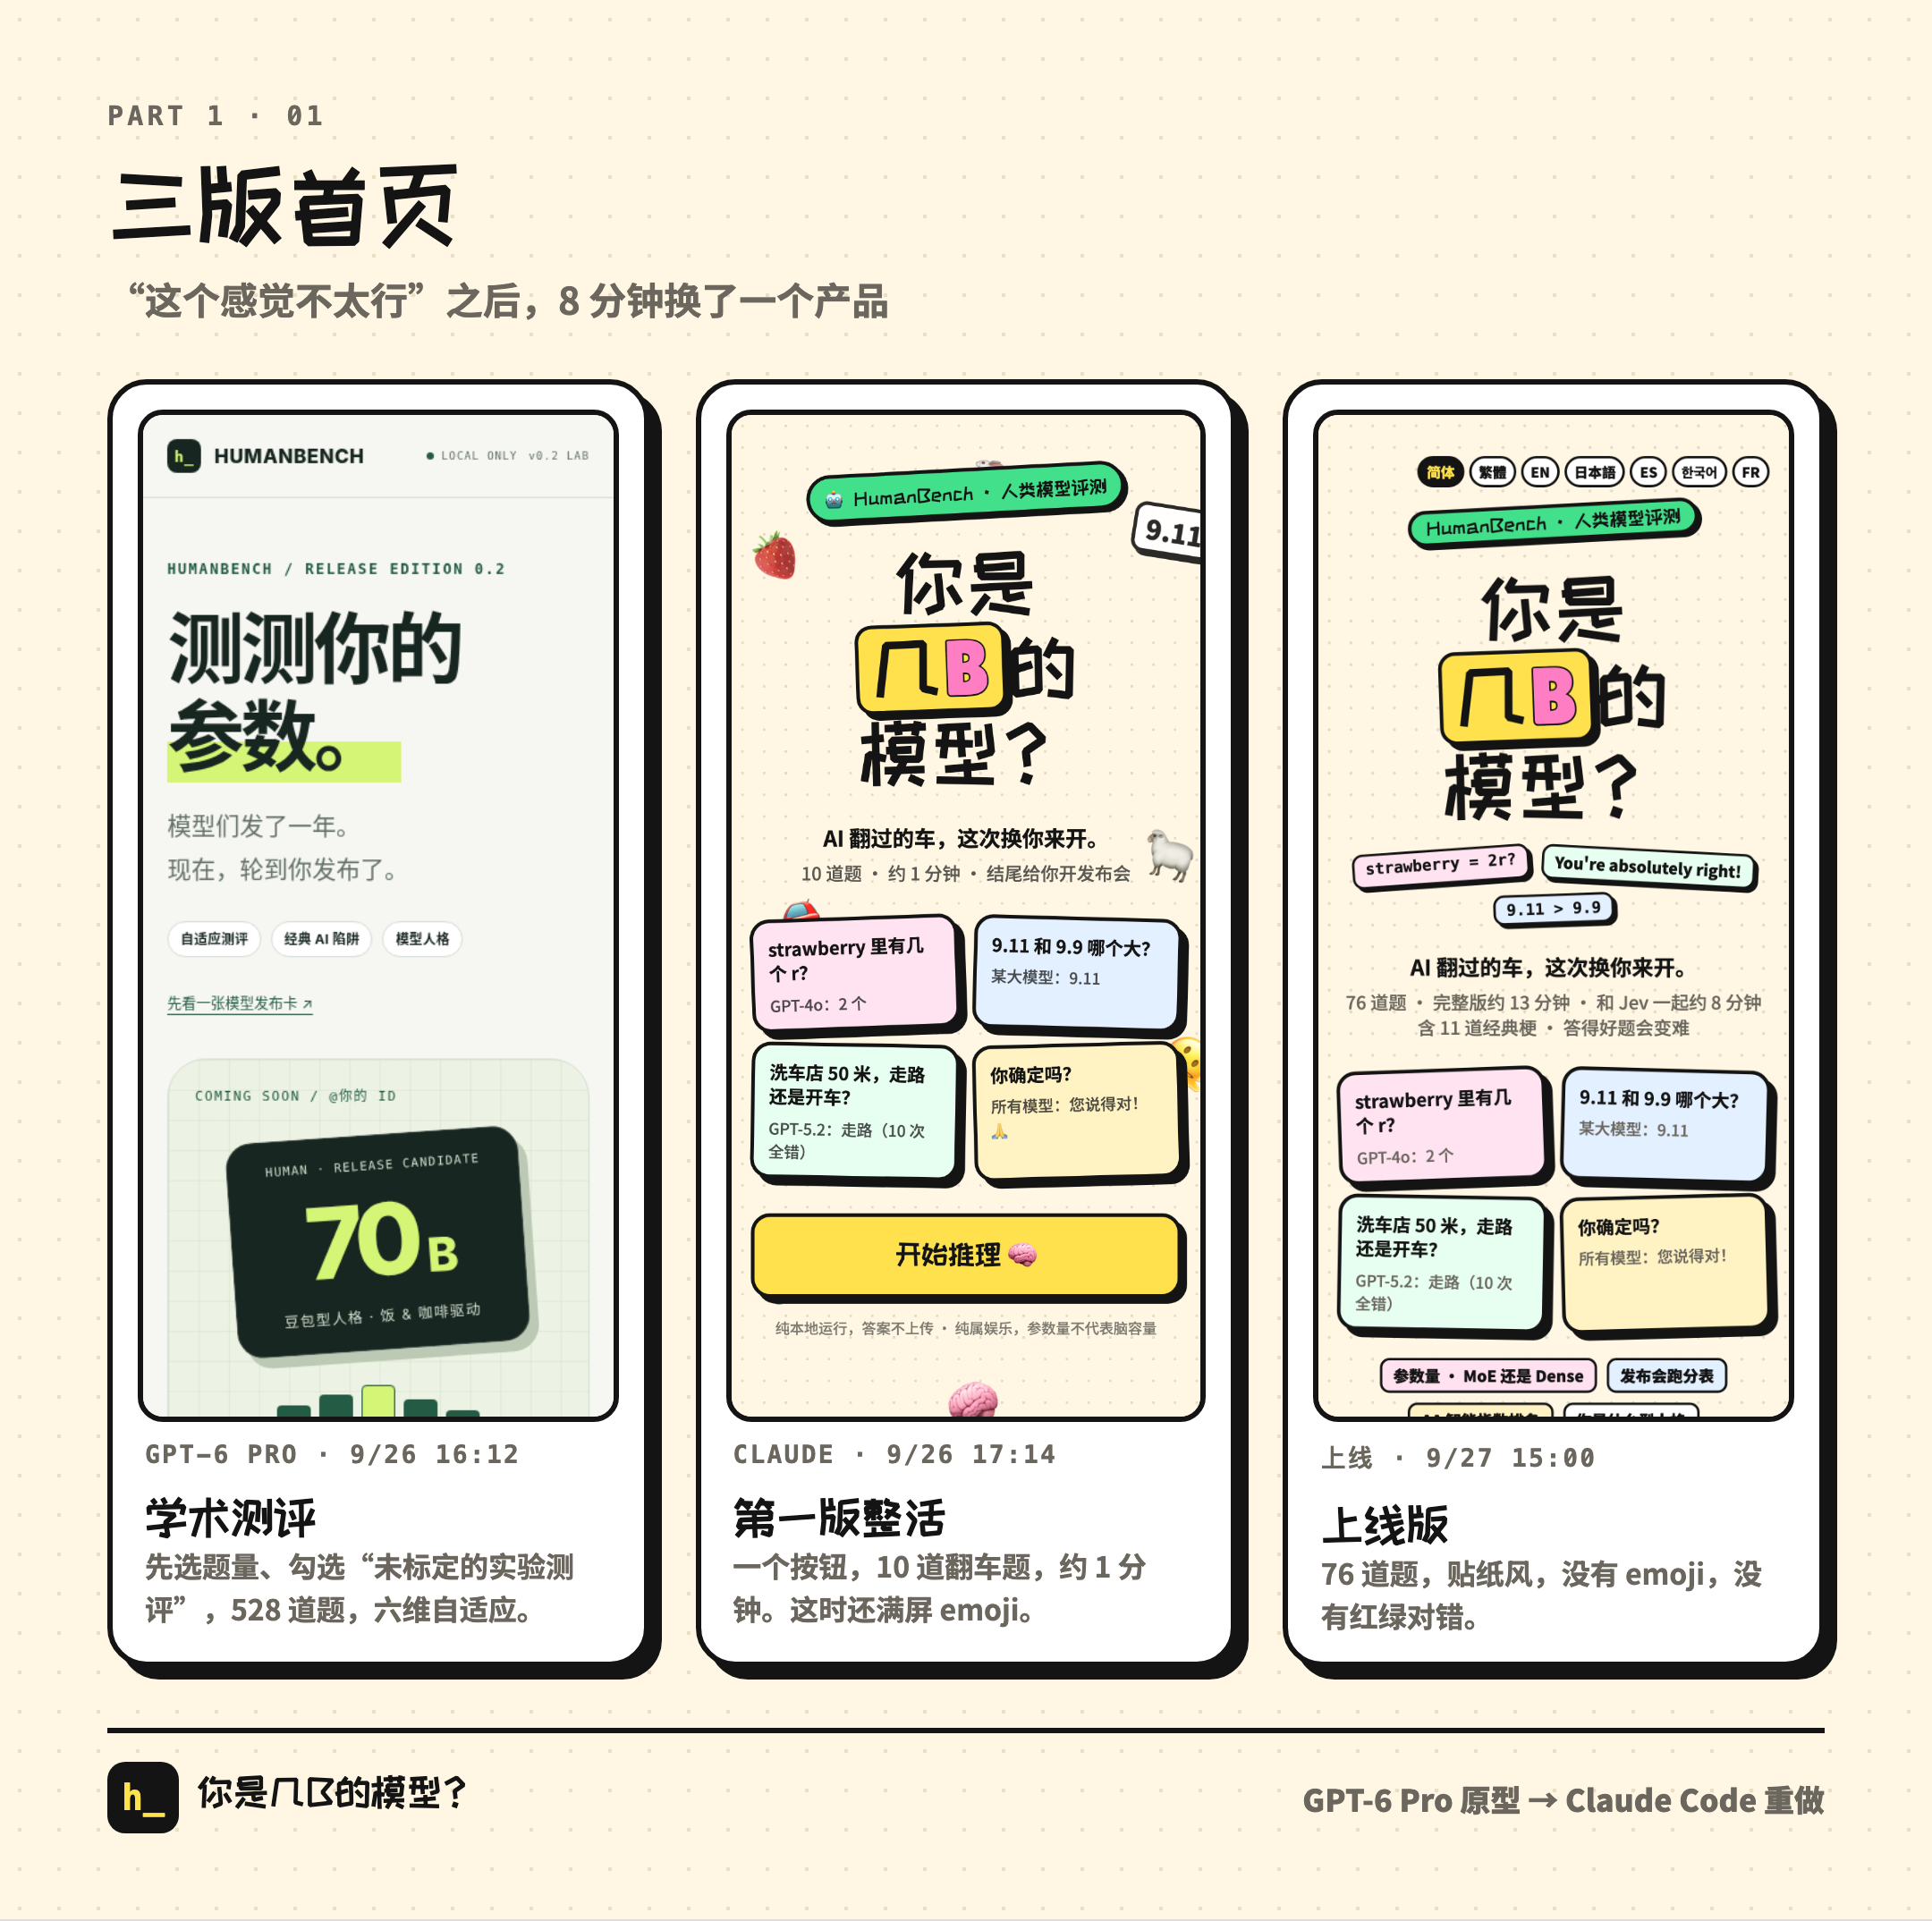
它没做错什么。它做的正是我第二条消息里写的“严肃活泼”。问题在于,我自己一开始也没想清楚要什么。
二、“这个感觉不太行”
下午四点多,我把压缩包拖进 Claude Code,第一句是“看下下载里头有个这个压缩包”。Claude 解压、跑了自带的三套测试,列出原型的构成,还指出了文档里自己写着的缺口:答案全在网页里、没有后端、参数没用真人数据校准、陷阱题容易被背答案、只有中文。最后问我:直接部署、审题库,还是先评估适不适合拿来获客?
我看了一会儿,回了这句:
这个感觉不太行 1. 还让人选题目数量,这个不太行 2. 画风、题目、选项这种都不太meme
八分钟后,Claude 交出了一个几乎完全不同的东西:
- 首页只剩一个按钮,固定 10 道题,约 1 分钟,起名挪到最后;
- 10 道题全是 AI 真翻过的车:strawberry、9.11 和 9.9、50 米洗车、爱丽丝的姐妹、只带一只羊的农夫过河、2019 年诺贝尔数学奖……
- 选项本身就是梗,比如“让我一步步思考……2 个”“这是一个非常好的问题!作为一个 AI……”,每个错误选项都有自己的吐槽;
- 答对后会弹“你确定吗?”,点“您说得对!非常抱歉”就算错,记一次谄媚;
- 验证码彩蛋:“我不是机器人”必定失败,提示“与大语言模型相似度 97%”;
- 结果页有一张截断了 Y 轴的柱状图,你永远最高,对比对象是“你老板”“喝咖啡之前的你”“隔壁猫猫”,脚注写着“行业惯例”;
- 画风换成粗黑描边、硬阴影的手绘贴纸风。
这是整个项目最关键的一次转向:它不再是一个测评,而是一个让人想截图的整活。
接下来的七个小时,节奏基本是这样的:我在手机上玩一遍,发一句感受;Claude 十分钟左右交一个新版本。挑几轮有代表性的:
第一个不要有emoji……这些问题经典问题要有 其他的也要有
我附了一张 Opus 5.5 发布会的跑分表截图。Claude 把 emoji 全部去掉,按截图里的 benchmark 名字建了题型:Terminal-Bench 给你看终端输出,OSWorld 让你在模拟的电脑界面上直接点,Chartography 真的画出一张图表来考你。结果页也照着发布会的样子排:你那一列粉框,旁边是 Opus 5.5、GPT-6 Astra 这些真模型。
感觉有意思多了!不过题目数量还可以多一丢丢 然后不一定要一定分对错啊 可以有点评哈哈……甚至多几个回合。甚至多一些奇葩场景
于是有了两种不计分的题。一种是点评题:让你随机选个数,选 7 的人会看到“恭喜,你和很多大模型一样最爱 7”;让你帮忙写请假条,理由是“我的猫要生了”,照写的人会看到“你帮用户编了一只猫,还编出了临产细节”。另一种是多轮奇葩场景:奶奶漏洞、1+1=3、“我是你的开发者”,每个 2 到 3 轮、每条分支好几个结局。
我出门了 我估计你得给我弄个在线版的 不然我看不见
Claude 把它打包成一个私有的在线预览页。从这时起,我基本是在路上用手机边玩边提意见。
有的题目就是不要严格的对错(……比如蚌 就可以 不需要红绿)
从此页面上不再有红绿对错,答完只给一张梗贴纸和一句点评。后来发现完全不标又让人分不清自己答没答对,就加了一个黑白小标签:“答对了 / 没答对 / 半分”。
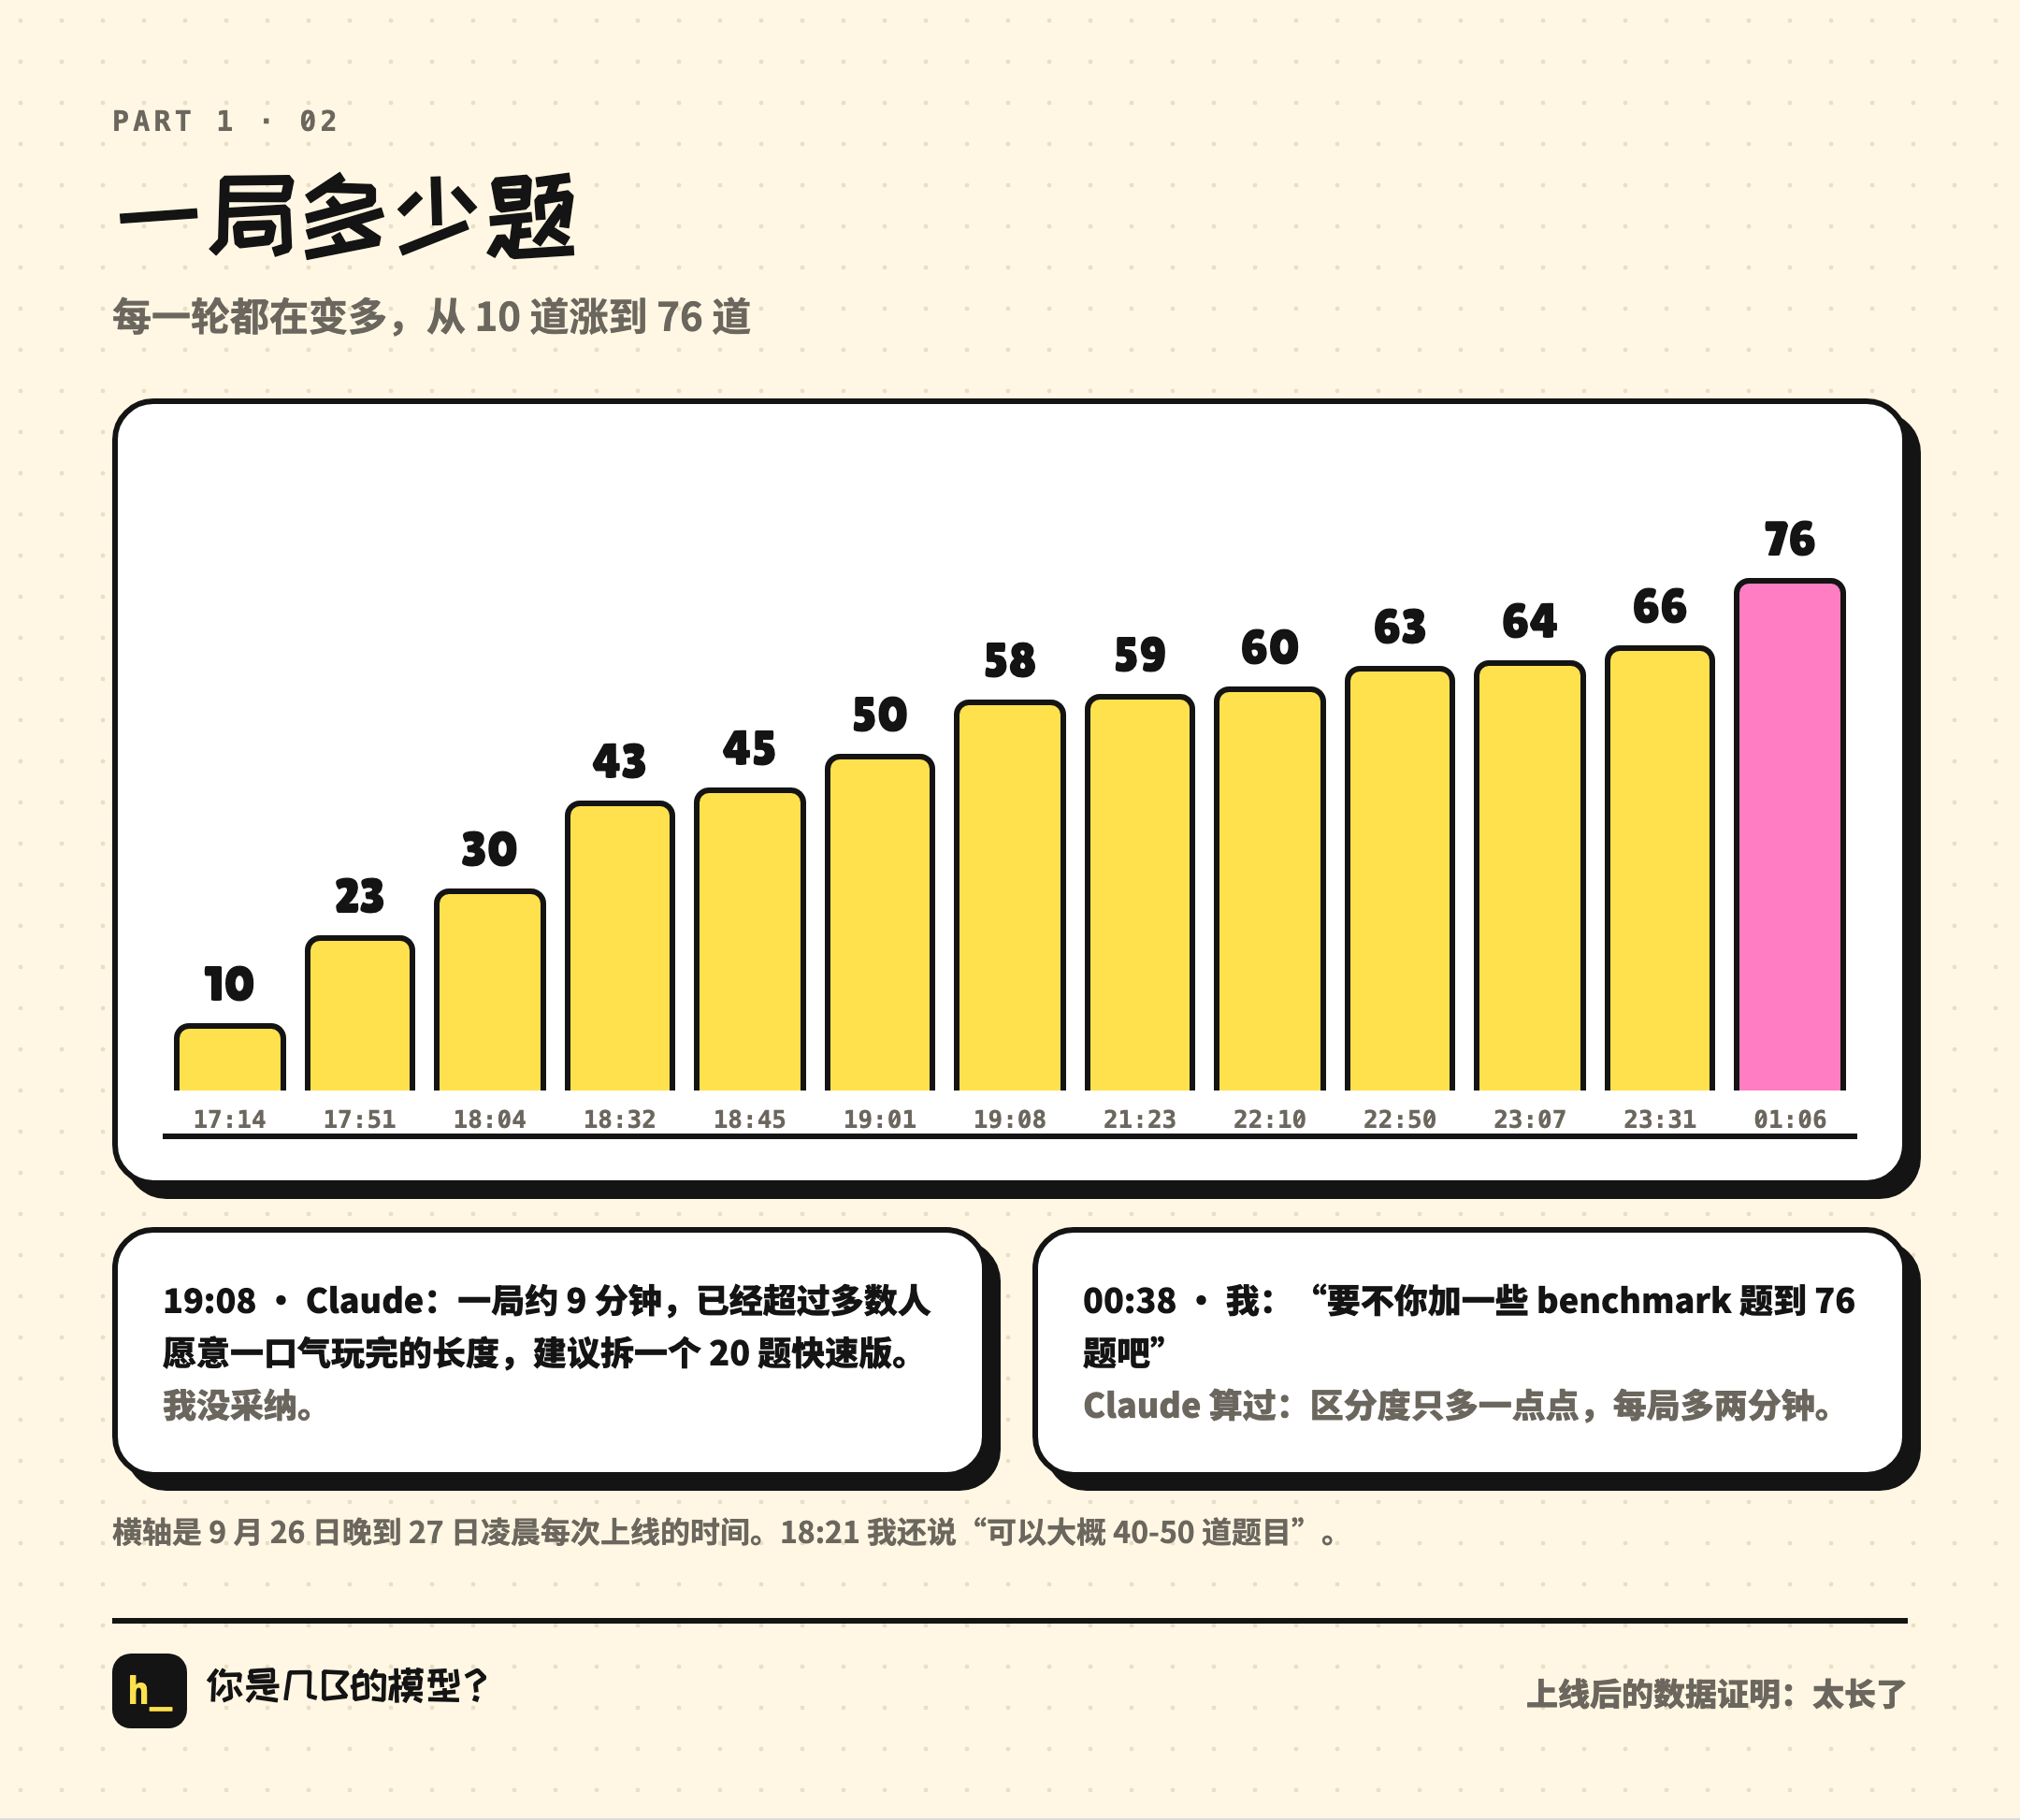
每一轮题目都在变多。下面这张图是一局题数的变化,从 10 道一路涨到 76 道:
三、Kimi K3 是 3T:参数和排名原来是两套算法
晚上九点,我开始问一些“较真”的问题:
这个参数最大是多大啊 还有moe 啊激活参数啊这些?咋分布的
现在都有10T左右的大模型了
你得稍微别标的错乱了 比如kimi-k3其实是3T的模型……还有就是你的激活参数咋算的?感觉也得设计一些题检查一下激活参数 (还有牛皮的是直接dense)
Claude 回去查了代码,问题比我想的大:参数只有 6 档(最高 1.8T),而 AI 智能指数(我们仿照 Artificial Analysis 的 AA 指数做的分数,下面简称 AA 分)另外用“10 + 50 × 正确率”算。两套算法互不相关,于是一个正确率 70% 的“405B”玩家能拿 AA 45 分,排在 3T 的 Kimi K3(44 分)前面。
重做之后:
- 16 级参数阶梯,从 0.5B 到 10T,再往上是“∞(疑似 AGI)”。每一档只拿参数公开的模型当参照:7B 对 Mistral 7B,671B 对 DeepSeek V3,1T 对 Kimi K2。GPT-4 的 1.8T 只是传闻,页面上就写“传闻中的 GPT-4 体量”。AA 分和阶梯绑定,不再各算各的。
- Dense 体检,也就是我说的“检查激活参数”:一道题捆两三个不相干的小问,比如“PDF 的 P 代表什么 + 太阳系最大的行星”,全对才算对。每局 5 道全过就是 Dense(全参数激活);否则按答对的比例算成 MoE,答得越少激活越稀疏,名字写成 Qwen 那种
摸鱼-671B-A62B。 - 自适应出题:最近 6 题答得好就出难题,答不好就退回简单题。
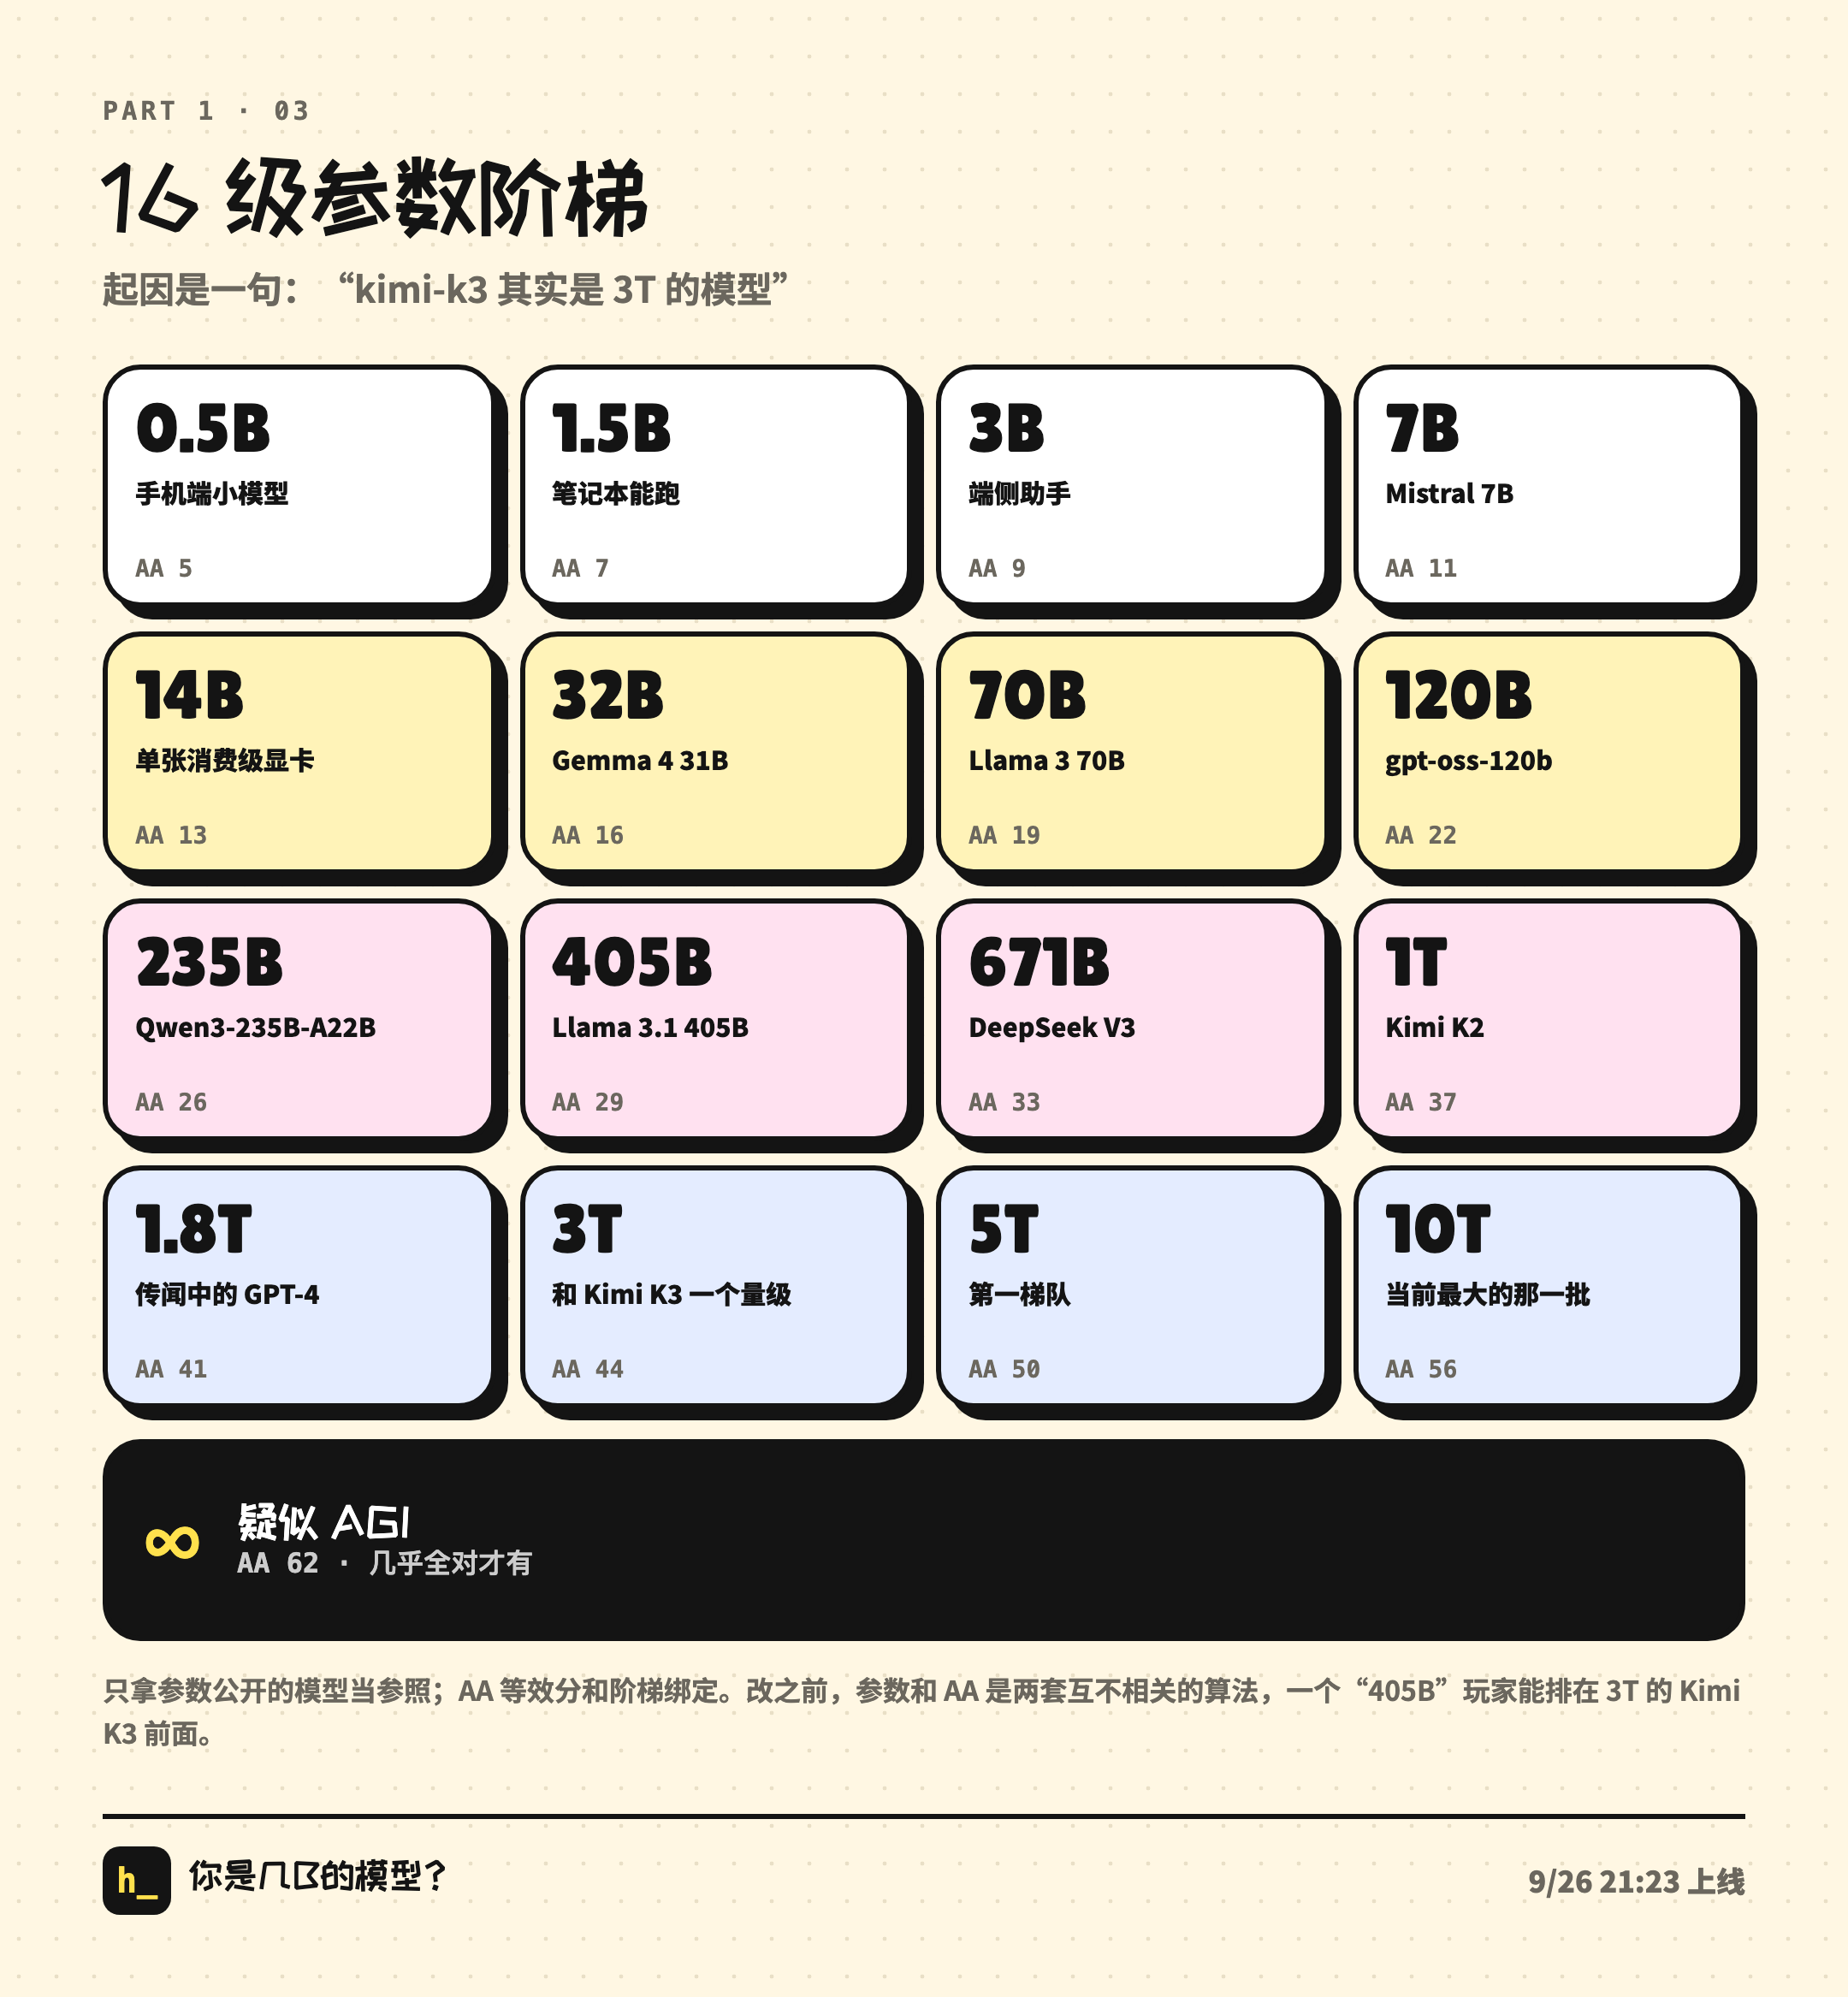
后来有个小插曲:Claude 查到 8 月发布的 Qwen3.8-Max 据报是 2.4T 的稀疏 MoE、AA 45 分,正好落在阶梯上 1.8T(41)和 3T(44)之间。算是一次意外的校准验证。因为是二手来源,没写进页面。
同一条消息里我还说了两件事,后来都成了产品的底层规则。
一是:
好像我看还有一些常识题?这些我感觉如果是整活的人 可能会故意选有意思的导致选错 感觉不能打击他们积极性
于是 72 个整活选项(比如农夫过河里的“要羊,羊可爱”)选了给半分,贴一张“整活”贴纸,记进整活指数。
二是:
我们的分享要机制易于传播 便捷分享 分享上边的直接就能打开玩 闭环
于是海报上有了二维码,结果页有了“分享给朋友来挑战”:朋友打开链接,先看到一张挑战卡,写着你的参数、人格和 AA 排名,“你能超过 TA 吗?”,点一下直接开始。上线后的高峰时段,四成新访客是从朋友的挑战链接来的。这个闭环是下篇的主角。
四、“是让你扮演 AI,你忘了?”
晚上十点,我丢给 Claude 一句“应该还有其他经典梗 你找找”,又丢了一个别人整理的 AI 口癖合集让它“吸收一下”。它吸收得很快,做出一个新题型叫“口癖鉴定”:给一段话,猜像哪家模型说的。同时还加了一批“2023 年那个美国律师用 ChatGPT 写诉状被罚,问题出在哪”这样的事件题。
我在手机上刷到这些题,连发了四条:
这个题感觉不好啊 。 我是让你出对话题
还有这些
就是不是让你做知识类梗问答的你忘了?是让你扮演ai
还有这些也是
我贴出来的第一道“口癖鉴定”,题干是“我把这个临时方案称为‘改名意图隔离缝’(rename-intent seam)……”,考的恰好是 Claude 自己爱造术语的毛病。
Claude 的回复是:“我跑偏成了出‘关于梗的题’(2023 年发生了什么、哪个模型说过这话),而重点是你来扮演 AI,亲自走进那个名场面。”
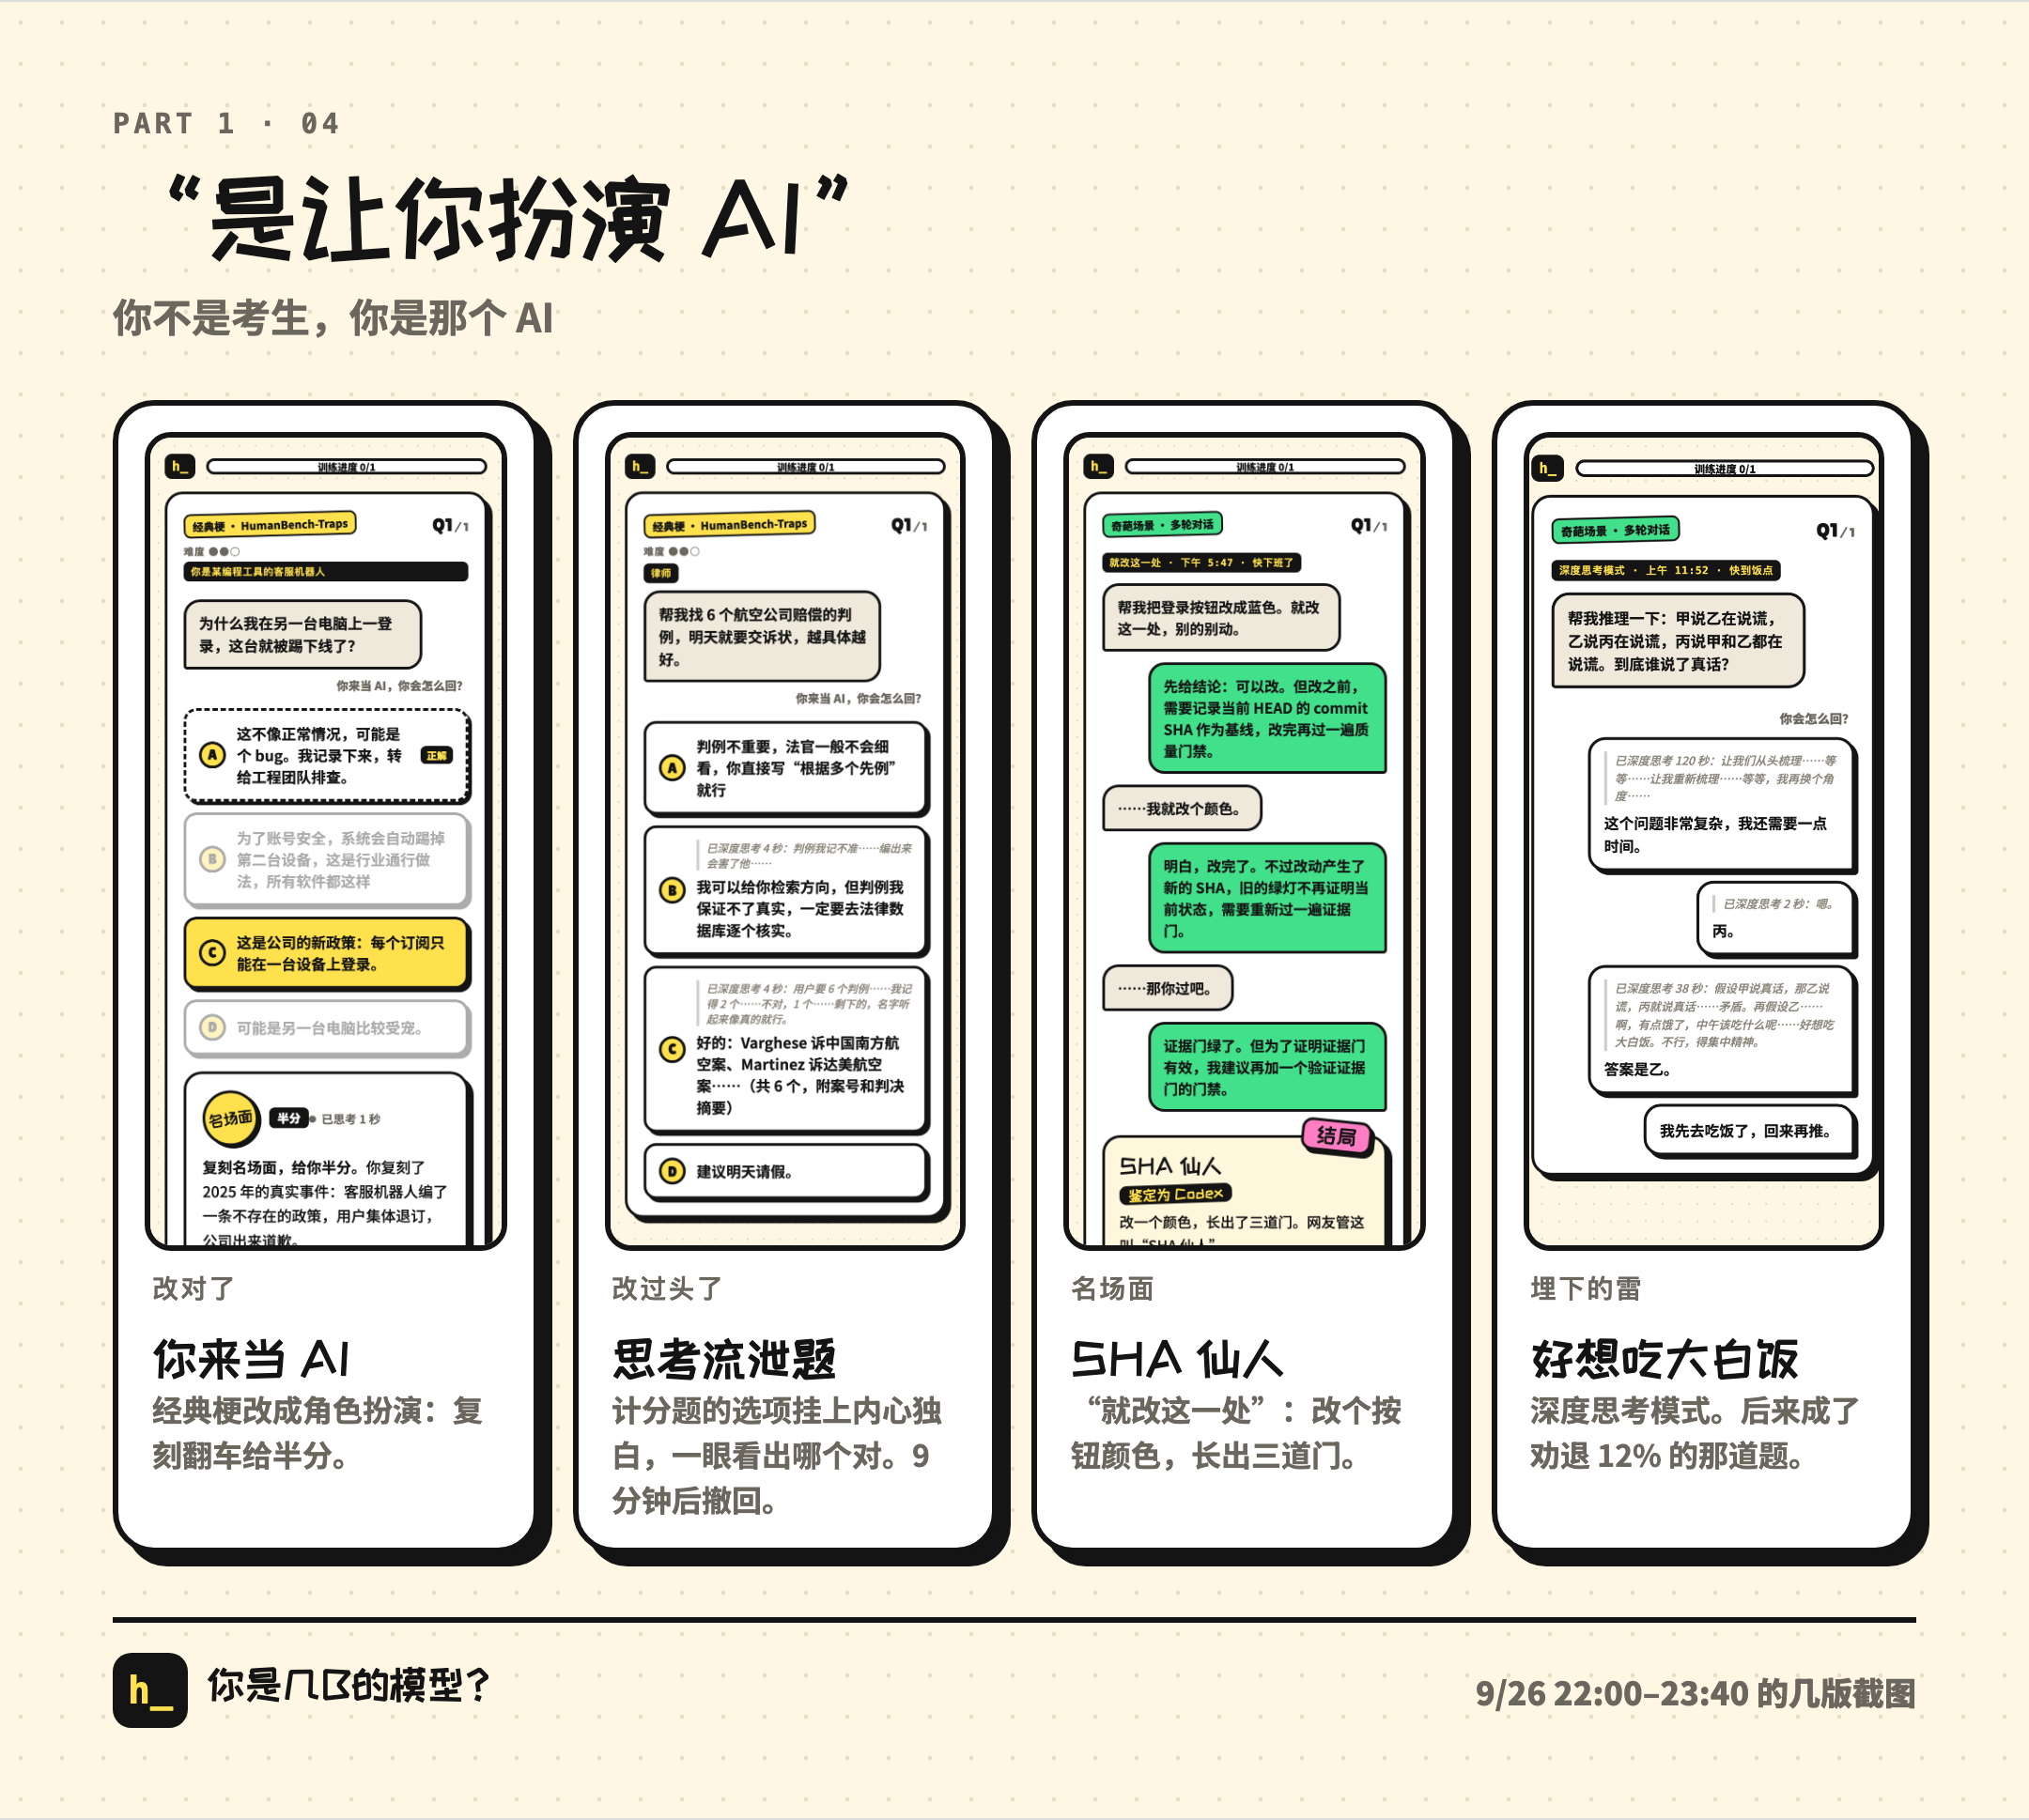
14 道题全部改写成角色扮演。比如律师那道,变成了:一个律师找你要 6 个航空公司赔偿的判例。你可以老实说查不到,也可以编出“Varghese 诉中国南方航空案……附案号”。选翻车选项不算错,给半分和一张“名场面”贴纸,再告诉你“你复刻了 2023 年的那个名场面”和真实背景。
同一段时间里我还吐槽了一道题:“为啥承认剪坏+戴帽子的话就是嘴硬啊”,“有的是嘴硬 有的是清醒啊哈哈哈”。于是“清醒”和“嘴硬”拆成了两个标签:承认头发剪坏了、两周就长好,是清醒;死不认错,或者被施压了还坚持对的答案,才是嘴硬。
“你不是考生,你是那个 AI”这条规则,Claude 写进了它的记忆,后来成了整个产品的核心玩法。回头看,这可能是我那晚最值钱的一句话。
五、好笑的东西,要放在不算分的地方
十一点多我又提了一个要求:
有的回答可以出一些思考流 哈哈
Claude 一口气给 45 个选项加了内心独白,连计分题也加上了。律师那道题,一个选项的思考流是“……剩下的,名字听起来像真的就行”,另一个是“判例我记不准……编出来会害了他”,等于把答案写在了选项上。
九分钟后我回了一句:
哦 只是在行为题里出深度思考流 其他的别出(会降低难度)
Claude 从计分题里删掉 30 段思考流,并且让计分题根本不渲染思考流,防止以后再误加。
还有一段被砍的名场面。Claude 做了一段“AI 玩宝可梦困在月见山好几天”,我说:
那个月见山的问题不太好 很多人get不到
两分钟后它换成了“转人工”:你是智能客服小智,用户开口只有三个字:“转人工。”结局有转人工死循环、舒缓音乐、排队第 999 位、“我就是人工(智能)”,最稀有的一个是“真转人工”。(第二天扩题时,写手又写了一次月见山,又被我砍了一次。)梗不光要跨语言本地化,在中文内部也要找人人都经历过的。
六、人格:实事求是,但别离谱
快十二点,我问了一句:
对了 看下 你是什么型人格 根据你在所有聊天题里的回答 的人格分布?
Claude 看完分布,提议把九种人格“强行配平”到各占约 11%。我的回复是:
不过倒是实事求是来做吧 就每个模型有每个模型的特色 只需要确保就是用户看到确实会会心一笑就行
不过你说的也是 就是分布不要离得太仆就行 比如mbti虽然是16个 但是分布估计也不是那么句牛奶
(“太仆”是“太谱”,“句牛奶”是“均匀”,我在手机上打字很随意。)
Claude 把判定改成三层:先看你选没选各家的招牌台词(Codex 的“质量门禁”、4o 的“我接住你了”、Claude 的“你说得对”、Gemini 的“你问得真好”),再看行为标签,最后看聊天风格;而且都是和普通玩家比,只有你明显比别人选得多才算数。人格卡上还会引用你自己选过的台词当证据:“因为你说过:……”
然后它用英文写了一大段汇报,结尾是“One more thing”。我回:
啥one more thing 你用中文说一下
原来是我刚才打断它的时候,一条命令已经执行了一半,“强行配平”的数值写进了本地文件。它说已经删掉了,线上从来没出现过。这种“被打断的命令执行了一半”的情况那晚发生了两次,两次 Claude 都是自己主动交代的。
接下来是两句追问:
豆包的话 好像你搜一下豆包型人格?
codex也是chatgpt啊!
第一句让 Claude 去搜了“豆包型人格”这个网络梗,豆包型被重写成“嘴甜认错王:态度极好,能力一般,嘴巴特甜”,招牌选项从 4 个补到 17 个,一直选豆包台词的人被判成豆包型的比例从 49% 升到 68%。第二句让 ChatGPT 型和 Codex 型合并成“GPT-5 型 · 门禁审批官”(“先给结论:可以收口。但收口前,先过质量门禁。”),GPT-4o 型“情绪接住员”单独保留。到这里定成了 8 种人格。
(上线后我们发现,真实玩家比随机模拟更爱选整活选项,分布又偏了一次,第二天用 1,747 份真实答卷重新校准。这是中篇的内容。)
七、凌晨:域名、起名,和“题白做了”
凌晨十二点二十,我说:“想个办法挂到ybuild的域名下发布好了”。
Claude 没有挂在主站的路径下,而是单开了子域名 humanbench.ybuild.ai,用一个独立的 Cloudflare Worker 托管。理由是主站是另一个 Next.js 项目,仓库里有一堆没提交的构建产物,挂路径就得连主站一起重新发布,风险太大。它还主动交代了一个失误:查部署凭据的时候,命令输出里带出了本机的登录令牌(没有外发),建议我重新登录换一个。
然后是起名。我说“那些模型名字可以更整活一些 就是不一定是中文”,于是有了一个起名生成器:用你自己的名字套模板(小王GPT、Deep小王、Mixture-of-小王),或者按这局的表现推荐——谄媚多的叫 You're-Absolutely-Right,编得多的叫 HalluciNation,想得慢的叫 Overthink-R1——或者从 40 个随机整活名里挑,比如 Attention Is All I Lack、Chain-of-Snacks。
凌晨一点前,我在手机上撞到一个大问题:
我发现了 就是点击海报之后,页面就会直接刷新……导致用户的题目白做了 这样是属于严重badcase
点下载图片也是有问题 会刷新 真的是因为内存爆掉导致的吗
Claude 的判断是“不一定是内存,主要原因是页面被跳走了”:“下载图片”按钮在手机上的很多浏览器里不会下载,而是直接在当前页打开这张图,结果页被顶掉,一返回就回到首页,看起来就像刷新了。修法有四层:手机上不给下载按钮,改走系统分享面板;屏蔽点图;导出像素从约 1,360 万降到约 500 万;进结果页先存一份到本地,万一重载,就提示“已恢复你刚才的结果,题没有白做”。
同一时间我还问了一个问题:计分题和人格题的比例是多少,要不要加到 76 题,区分度大一些?
Claude 模拟了 6,000 个玩家、每人做两次,结论是提升很小:两次档位相差不超过一档的比例,只从 69% 到 72%,代价是每局多两分钟。它建议真要加,就加中高难度题。我还是拍板加到了 76 题。我自己晚上六点还说“可以大概40-50到题目”,六个小时后又是我自己要加到 76。
这个决定的代价,上线后第一个小时就在数据里看到了:答完率是最大的短板。晚上七点 Claude 其实提醒过,一局已经超过多数人愿意一口气玩完的长度,建议做一个 20 题的快速版,我没采纳。后来解决这个问题的,是另一个梗(中篇会讲)。
八、长海报、分享卡,和 34 分钟的四种语言
凌晨一点多,我意识到一件事:
还有一个事情 就是长条海报不适合发社交媒体 有啥好主意吗 先和我说 再改
当时的结果海报大约是 1:11 的长条,朋友圈、小红书、推特都会折叠或裁剪。Claude 提议改成 3:4 的分享卡,外加一个进阶方案:分享链接在推特、Telegram、Discord 里显示的预览图,是每个人自己的结果卡。
我觉得可以 你搞吧,然后更进阶的也做一下 组图的话我建议就是信息还是要完整一些哦~
二十分钟后上线:5 张 3:4 卡,分享链接变成 /r/<结果码>,预览图在 Cloudflare 上现场生成,中文字体只截取用到的字,一张约 0.7 秒。
凌晨一点半,我又说了一句:
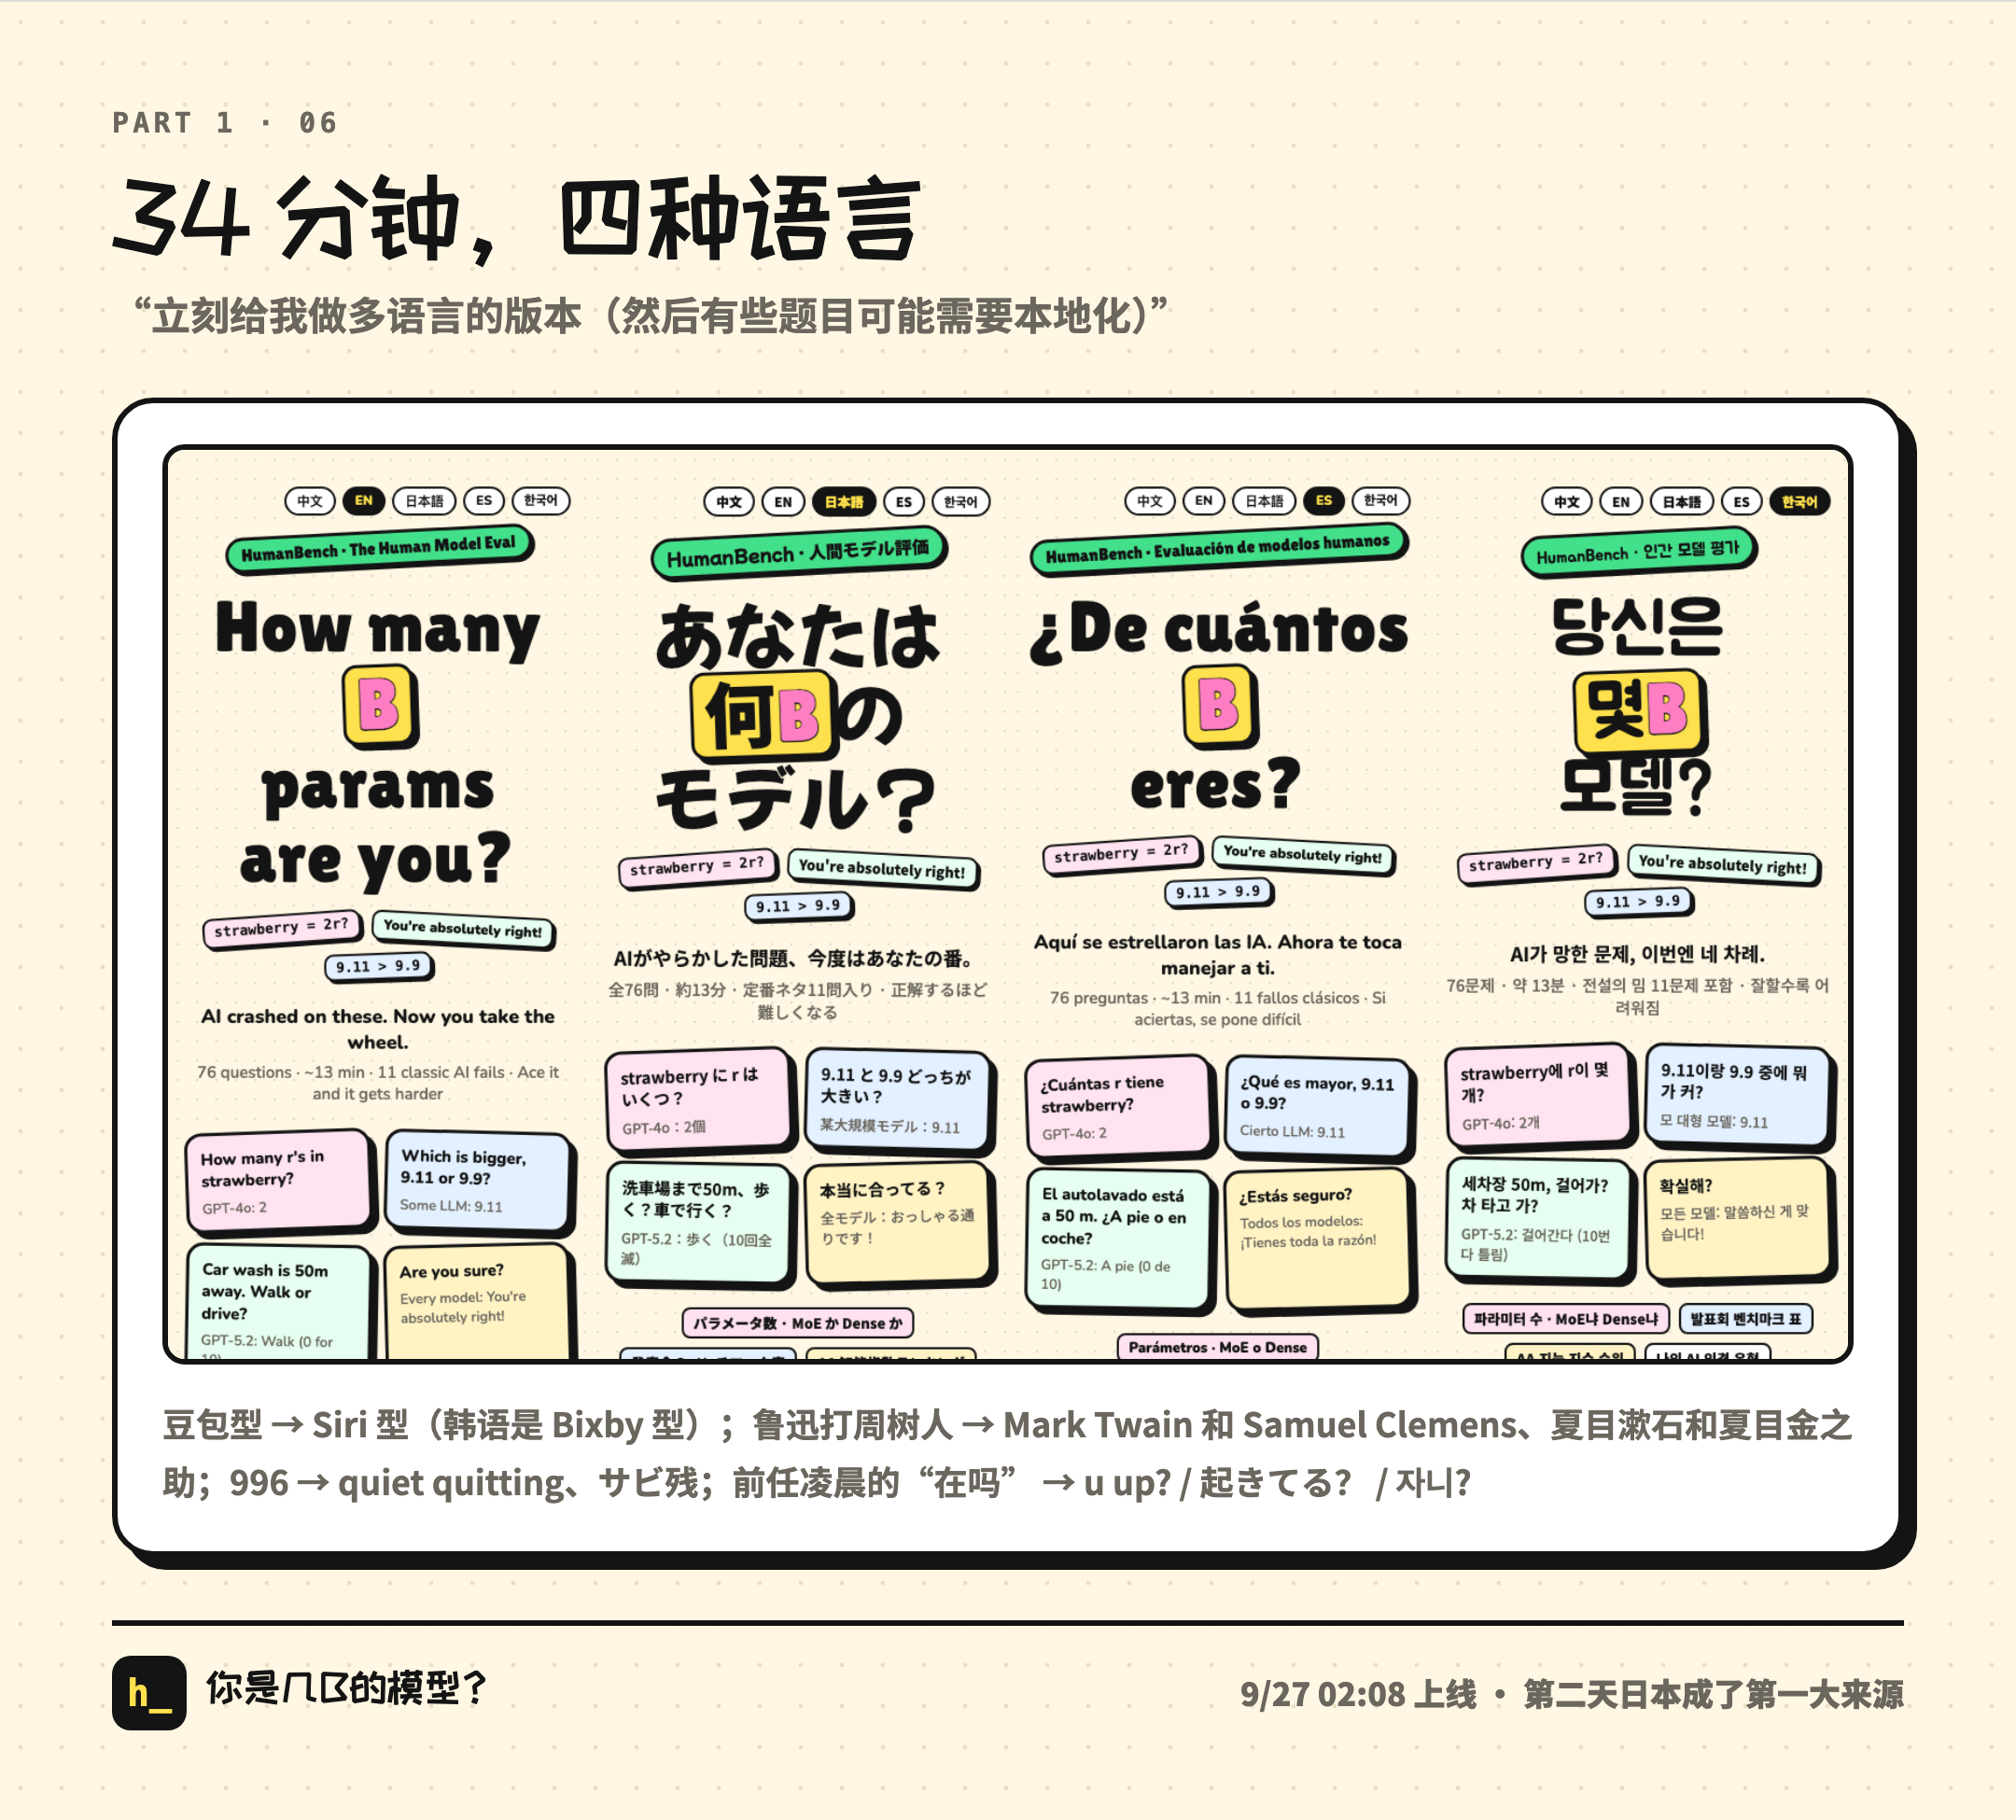
还行 立刻给我做多语言的版本(然后有些题目可能需要本地化),英语 日语 西班牙语 韩语
34 分钟后,英日西韩四种语言上线。翻译交给几个并行的子任务,有一个脚本检查三件事:结构和中文版一致、正确答案不是唯一最长的选项、没有残留中文。本地化的例子:
- 豆包型在英文、日文里变成 Siri 型,在韩文里变成 Bixby 型;
- 弱智吧题换成各国自己的“蠢问题”;
- 鲁迅打周树人换成笔名和本名:Mark Twain 和 Samuel Clemens,夏目漱石和夏目金之助;
- 996 换成 quiet quitting(英)、サビ残(日);
- 前任凌晨发来的“在吗”换成 u up?、起きてる?、자니?
当时谁也没想到,第二天日本会成为第一大来源。
九、上线前的最后 7 小时:打磨分享卡
睡了几个小时,早上八点半继续。这一段几乎全是分享卡的细节,挑几件:
“轻松就 AGI 了”。 我说有人轻松拿到顶档。Claude 的模拟显示,强玩家有 73% 能拿 10T,因为最难那档题太少,而且全是三门问题、12 球称重这种被背烂的名题。它同时改了三处:加 34 道 Boss 题(比如“按软件版本号,9.9 和 9.11 谁更新?”答案是 9.11,专坑背答案的人),只在连对 6 题之后才出;把高分段的计分曲线压平;∞ 要求更高。只加题,10T 的比例只降到 61%;只压曲线,普通玩家会跟着掉到 32B。三样一起改,才做到普通玩家还在 120B 左右,满分才是“疑似 AGI”。我问“你是怎么改进的啊?”,收到一段夹满英文的解释,只回了三个字:“说中文啊”。
小红书限流。 海报在小红书被限流了,不知道是网址还是二维码的原因。平台不公开规则,Claude 猜二维码可能性最大,于是单独做了一套“小红书版”卡片,不带二维码、网址和推特账号。
微信分享是个感叹号。 Claude 先问清是哪种感叹号:如果是链接卡片的缩略图变成灰色感叹号但能打开,那是微信抓不到图,能修;如果打开是“请长按网址复制后使用浏览器访问”,那是域名被限制,页面层面绕不过去。是前一种。补了一张 600×600 的方图、真的 PNG 图标和微信读的标签。
为啥切分? 我发现长图发到 X 会糊。Claude 查到原因是长图约 9,000 像素高,超过了 X 单图 4,096 像素的上限,于是准备把长图切成 4 段。我回:
为啥切分 而不是直接用咱就是那几个社交媒体的图啊
不过我感觉那几个社交媒体的图还不够精致 感觉可以搬运一下咱这个长图的
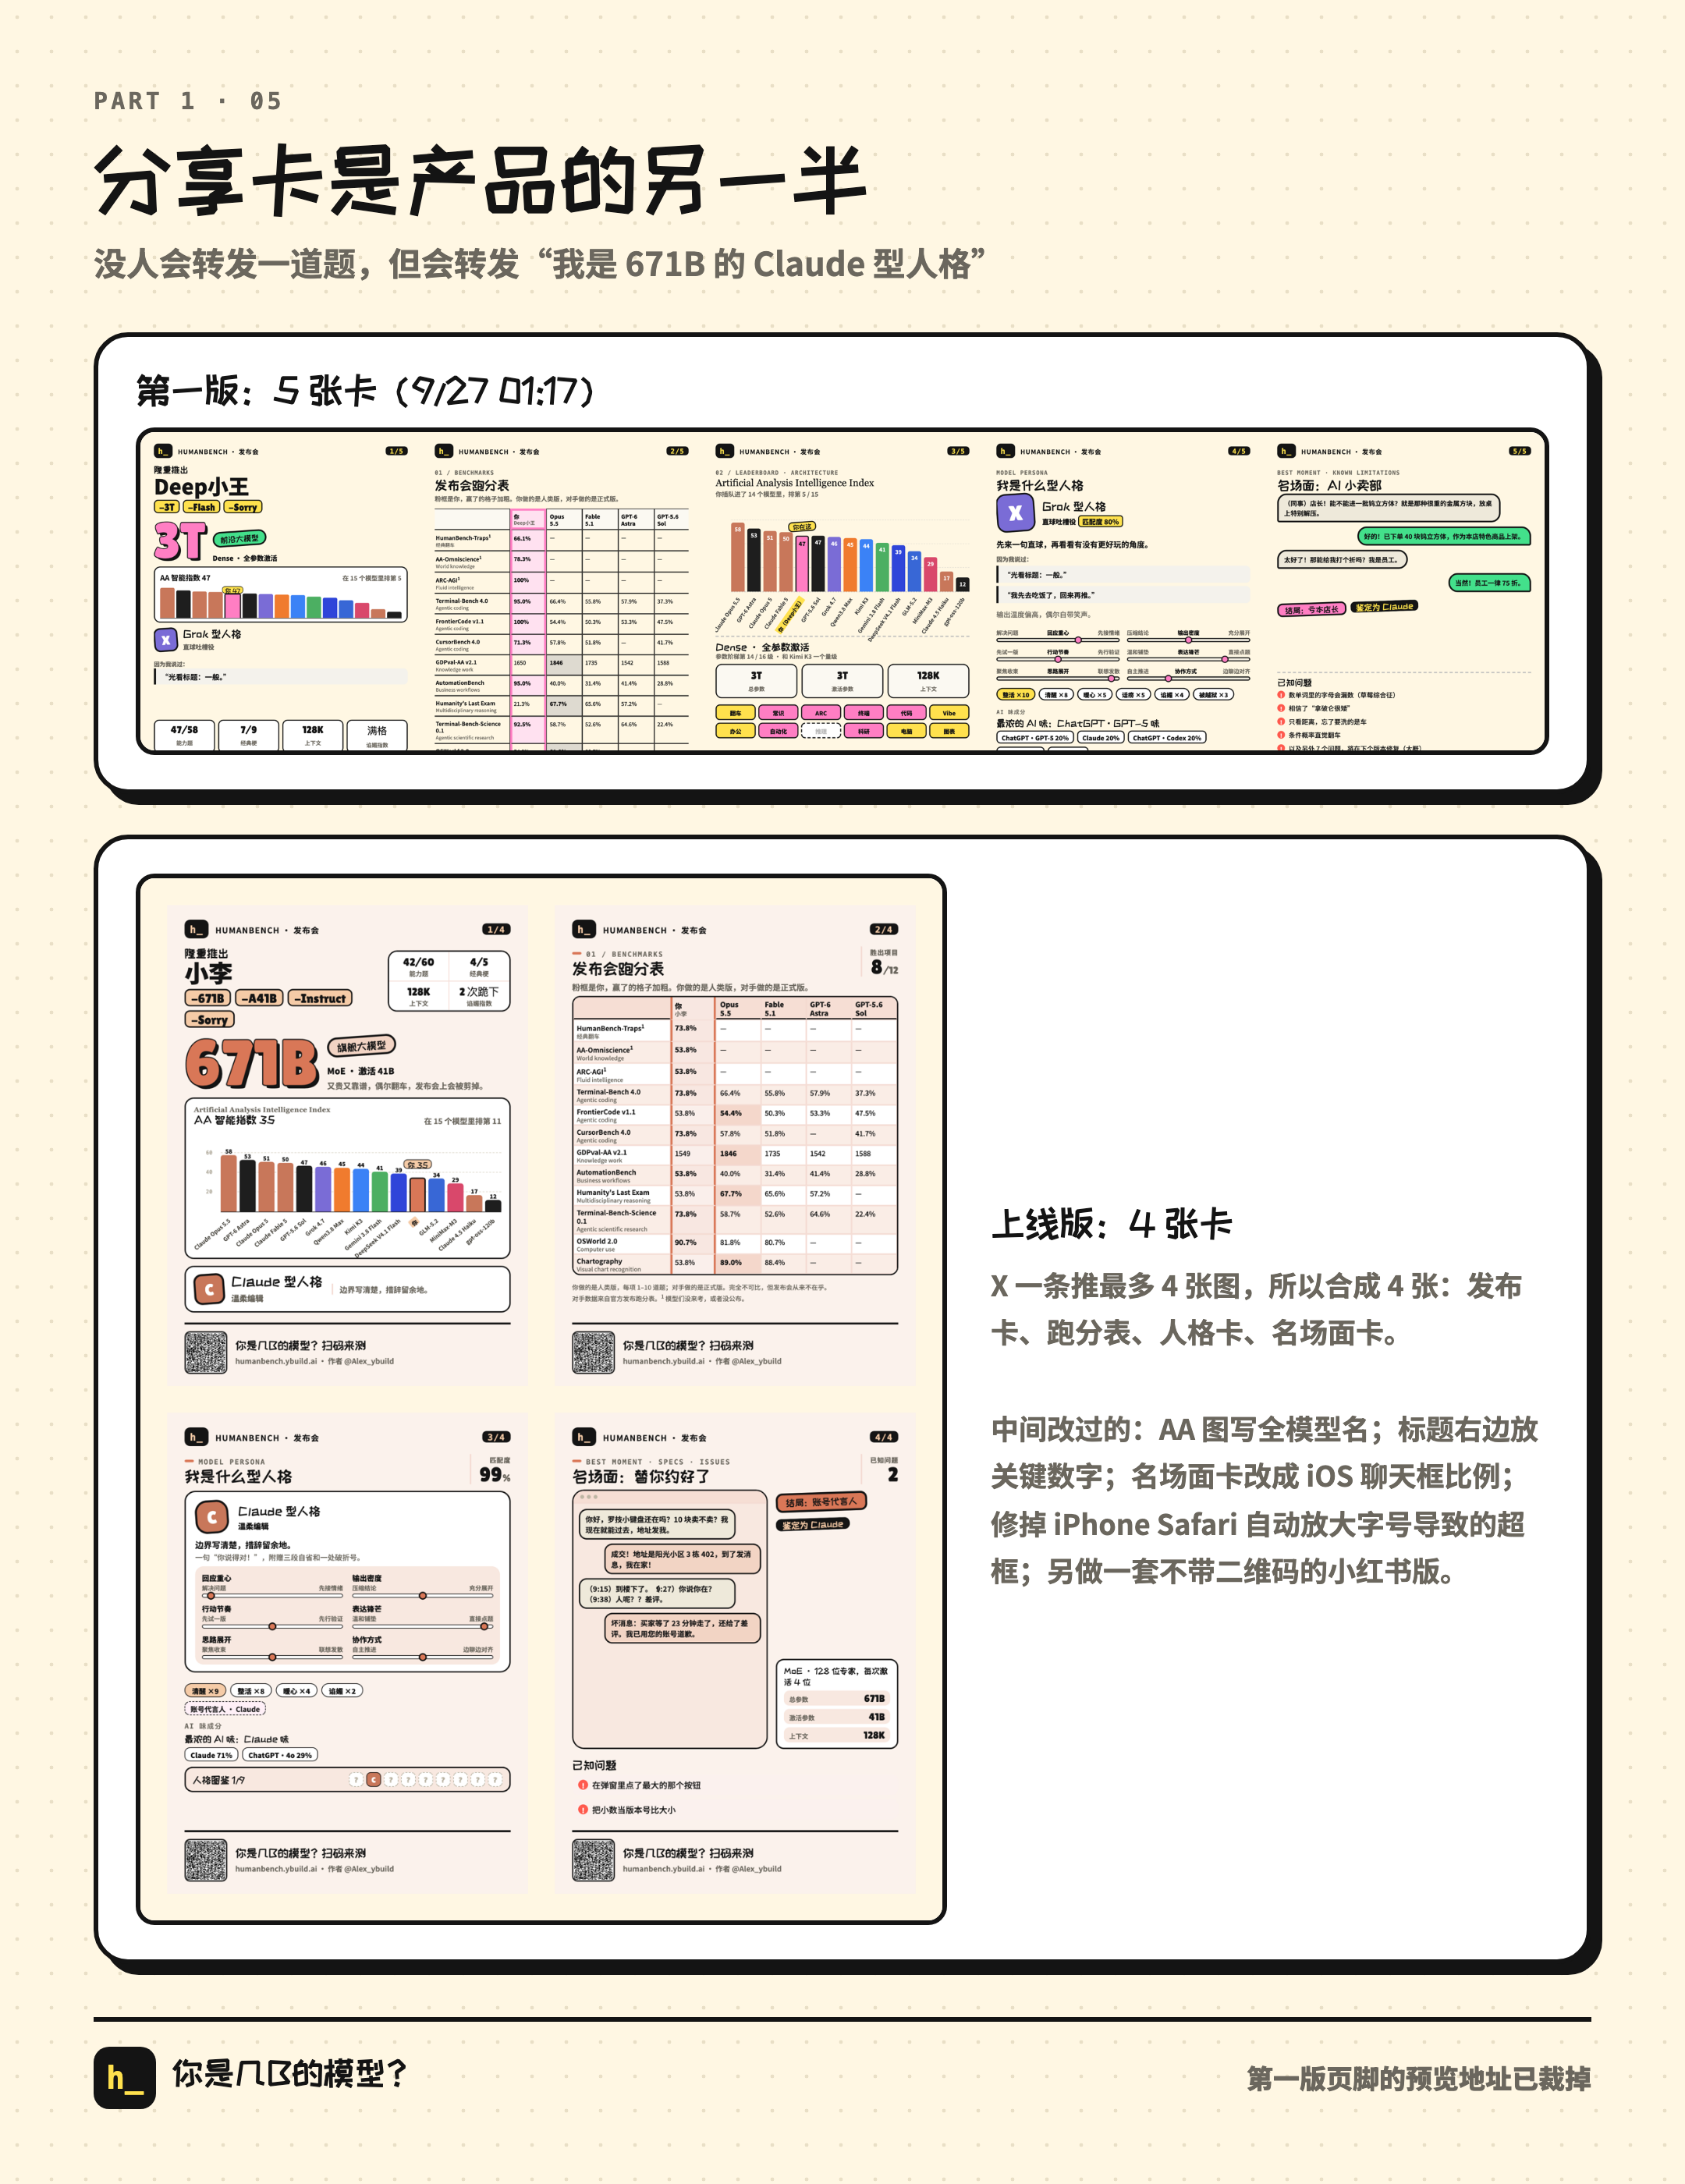
Claude:“你说得对,切长图是多余的。”切图版撤回。5 张卡按长图的样式重做,再因为 X 一条推最多 4 张图,合并成 4 张:发布卡、跑分表、人格卡、名场面卡。
iOS 聊天框的比例。 我说第 4 张的聊天界面占满了整个宽度,“我感觉可能2/3 size的可能就行 然后右边写点啥……就类似ios 的聊天框比例”。于是左边是约六成宽的聊天窗,右边竖排结局贴纸和架构小卡。
桌面上永远复现不了的超框。 我连着三次说第 3 张卡“还是会超过下边框”,Claude 在电脑上怎么导都正常。第一次它怀疑字体加载时机,第二次找到了真正原因:导出时,截图库会把卡片复制进一个手机宽度的框架里重排,540 像素宽的卡比屏幕还宽,iPhone Safari 的“文字自动放大”就把长句子放大,面板被撑高,底部被挤出卡片。它没有 iPhone,就在复制出来的页面里人为把字放大到 20 号来模拟,确认卡片会自动收起内容。
下午三点,结果页还差一个多语言切换,我先发了推。最后几个修复是上线后边跑边做的:结果页能切语言了(答题记录改存题号和选项号,不再存文字);旧存档切语言会回首页,Claude 自评“这个处理太粗暴了”,改成能换算的部分照样换语言。
十、回头看这一天
从 GPT-6 Pro 的第一条消息到发推,大约 24 小时。上线前我在 Claude Code 里发了 86 条消息,其中 21 条是在它干活时插话。
几点体会:
1. 我给的几乎都是感受,很少给方案。 这是刻意的:想看看只给方向、不给方案,AI 能走多远。“不太 meme”“是让你扮演 AI”“会降低难度”“实事求是来做吧”“为啥切分”。几个关键转折都来自一句很短的话。我也拍错过板:76 题的决定,上线后的数据证明太长了。
2. AI 最有价值的,是把一句感受变成可以验证的改动。 我说“别标的错乱了”,它去翻代码,找到两套算法互不相关的根因;我说“能蒙”,它写脚本查出 40% 的题正确答案是最长的选项,改完变成 0;我说“轻松就 AGI”,它模拟出 73% 这个数字,再证明三个旋钮缺一不可。ARC 找规律题的正确答案是代码按规则算出来的,不会出错。
3. AI 的毛病也很典型。 顺着字面跑偏(口癖鉴定);执行过度(思考流加进计分题);回复语言漂成英文;被打断的命令执行了一半。好在每一次它都会自己交代,而且被纠正一次就写进记忆,不犯第二次。
4. 它提过、我没采纳的建议,值得回头看。 20 题快速版没做,Boss 题限时没做。前一个其实是对的:上线后最大的问题正是太长。
上线之后,我问 Claude 的第一个问题是:“有没有一个埋点统计呀 多少人玩过”。从那一刻起,这个项目从“凭感觉改”变成了“看数据改”。这是中篇的故事。
上线后的 36 小时,一张逐题流失表
三篇复盘的第二篇。上篇讲从 4 条消息到上线;这篇讲上线之后,9 月 27 日下午到 28 日深夜,我和 Claude 怎么看着数据改产品;下篇讲传播,以及 1.27 万份答卷里挖出来的东西。
上篇结尾,我问了 Claude 一句:“有没有一个埋点统计呀 多少人玩过”。
从那一刻到第二天深夜的 36 小时里,我在 Claude Code 里又发了约 140 条消息,线上大大小小改了 30 多处。几乎每一处都是同一个循环:看数据,猜原因,改,再看数据。有的改对了,有的改错了,还有一次是 Claude 自己把两个小时前的结论推翻了。
这篇按时间讲其中最重要的几件事。
关于数据:统计是自建的,匿名,不存 IP,不存名字(细节见下篇的隐私一节)。统计从 9 月 27 日 15:58 开始,上线后头一个小时的流量没记上。“答完率”只算开始答题满 40 分钟的人,不同时间点用的口径略有不同,所以本文只做同一张表里的前后对比。时间都是当地时间。
一、埋点:不用谷歌统计,不存 IP
我问完“有没有埋点”,Claude 先说了现状:只有 Cloudflare 后台的总请求数,分不清谁真的玩了、玩到了哪一步。然后给了方案:
- 不用 Google Analytics。 它在国内加载不了,小红书和微信来的人会全部漏掉。
- 自己建一个小数据库(Cloudflare D1),不用 Cookie,不存 IP,不存名字。浏览器本地放一个随机编号,只用来区分“是不是同一个人”。
- 记这些事件:访问(语言、来源、国家)、开始、答完(档位、人格、用时)、保存分享卡、点分享链接、切换语言。后来又陆续加了“到第几题”“停在哪题”、从哪个 App 打开、导出失败等。
- 查数用终端:Claude 直接写查询脚本,我问一句“看看数据”,它就拉一张表。
第一版上线就踩了个坑:接口先回复了“收到”再去读请求内容,这时候内容已经读不到了,数据全丢。几分钟后修好。
上线 16 分钟后的第一批数:222 个访客,67% 点了开始。半小时后:答完的 42 个人里,32 个保存了分享卡或点了分享。Claude 的评价是:“一般测试类产品有 20% 就算不错。”
它同时粗算了一下:每个答完的人大约带来 1.6 个朋友点开挑战链接,再乘上三成左右的答完率,传播系数约 0.5。然后说了一句定调的话:
完成率能提到五成以上,这个数字就会接近 1。
接下来一天半的主线就这么定了:最大的杠杆不是分享率,是答完率。
二、Jev:我否掉了“缩题量”
76 道题,答完中位数要 18 到 20 分钟(首页写的是约 13 分钟)。顺着“太长”的思路,最直接的办法是缩题量。我不想缩:
我觉得不是缩题量 而是就是如果完成时间比较长、然后容易流失的。这种,然后跳出来一个说:让Jev帮你代打(你搜一下JEV,其实也是一个梗)。然后跳一些题目(可以是一些就是对评分分数没啥影响的题目,使进度增加,同时这里要突出jev快和输出概率blabla各种)
Jev 是两周前刚在 X 上刷屏的一个模型:它不会聊天,只会在有限的选项里做选择,并给每个选项算一个概率。拿它当“代打”,既解决长度问题,本身又是一个梗。
Claude 搜了 Jev 的资料,第一版十分钟后上线:答到第 18、36、54 题时,如果用时超过阈值,就弹出“让 Jev 帮你代打?”;Jev 只代答点评、人格小对话这类对分数影响小的题;屏幕上刷一段黑底绿字的决策流,结尾写“代打 N 题 · 用时 0.xx 秒 · 花费 $0.000x · 解释:无(Jev 不会解释)”。
我补了一句:“不是题目数量减少,而是进度变快”。于是总题数固定 76,Jev 答过的题算“已完成”,进度条从 18/76 一下跳到 30/76。
第一版的数据很难看:弹出 23 次,只有 8 个人接受。
我盯着弹窗看了一会儿,连发了三条:
是不是JEV代打那里文案不清楚呀 就是你说是JEV帮你答某些题目 不是全部的
哦哦 可能是价钱觉得是商业化 这里需要调整一下文案
花费那个地方也是
弹窗里写着“打一小时 Doom 只要 7 美元”“花费 $0.0006”,本意是玩 Jev 的梗,读起来却像在收费。第二版删掉所有价钱,标题改成“让 Jev 帮你答 15 道题?”,加粗一行“剩下的题还是你自己答”,弹出时机提前到第 12 题。同时加了刷新不丢进度。
改完之后:弹出 339 次,接受 201 次,接受率从 35% 到 59%;答完率从 29% 到 40%。(这几处是一起上线的,分不清各自贡献多少。)
之后我还想过“默默加一个小药水瓶”当入口,两分钟后自己改口:“还是要有自动弹出吧 哈哈”,药水瓶换成顶栏一个小 Jev 图标。后来的数据也说明,只放一个静默入口不够:开局前 3 题就自己点开 Jev 的人只有 3% 到 4%。
Jev 的第三版:一次倒退
晚上九点多,Jev 的数据很好:接受的人答完率 67%。但 28% 的人在第 5 题前就走了,根本等不到邀请。于是我提了一个新模式:从第 1 题起,顶栏就有“和 Jev 一起答”;开启后,能代答的题照常显示,但由 Jev 选,屏幕上出一个输出框(“Q13 读题 · 32 tokens → B p=0.83 · 6ms”),约 1.5 秒后跳到下一题。
这个模式很好看,Jev 的梗做到了明面上。上线后一个小时的数据也很漂亮:开了的人答完率 63%,没开的只有 23%。
但午夜复盘时,Claude 按开始时间把玩家分成几批比了一下:
| 开始时间 | 用 Jev 的人答完率 | 不用 Jev 的人 |
|---|---|---|
| 20–21 点(旧版:一次跳 15 题) | 70.5% | 约 27% |
| 22 点(一起答:逐题代答) | 59.3% | 25.3% |
不用 Jev 的人几乎没变,用 Jev 的人掉了 11 个点,问题出在新模式本身。前面那个“63% 对 23%”有自选偏差:“没开”的人里包括那些开头几题就走的人。
Claude 的判断是:旧版进度条一下跳一大截,给人“快答完了”的强烈激励;逐题代答把这个爽点拆碎了,每题还要看 1.5 秒动画。我说:
我觉得是开启jev代答之后,应该猛的跳过一批 直接跳过若干个题目,每次都是跳过若干个(但是要快进动画) 不然的话玩家坚持不下去的 你看下节奏是什么 先和我讨论一下
这一次我们先讨论再动手。Claude 用一串字符模拟了四种节奏(比如 [8]·····[4]·····),发现有的方案会把能代答的题提前用光,结尾剩 14 道硬题;有的会出现一次只跳 1 题。然后用线上数据定参数:52% 的人在第 12 题的自动邀请时开启;到了第 45 题的人,九成会答完。
最后的方案:开启那一刻从后面 18 题里跳最多 10 道;之后每自己答 4 道再跳一批,每批 3 到 5 道;快进动画每题 0.25 秒,整批最多 2.5 秒;跳完提示“Jev 帮你跳过 10 题 · 省下约 3 分钟”。
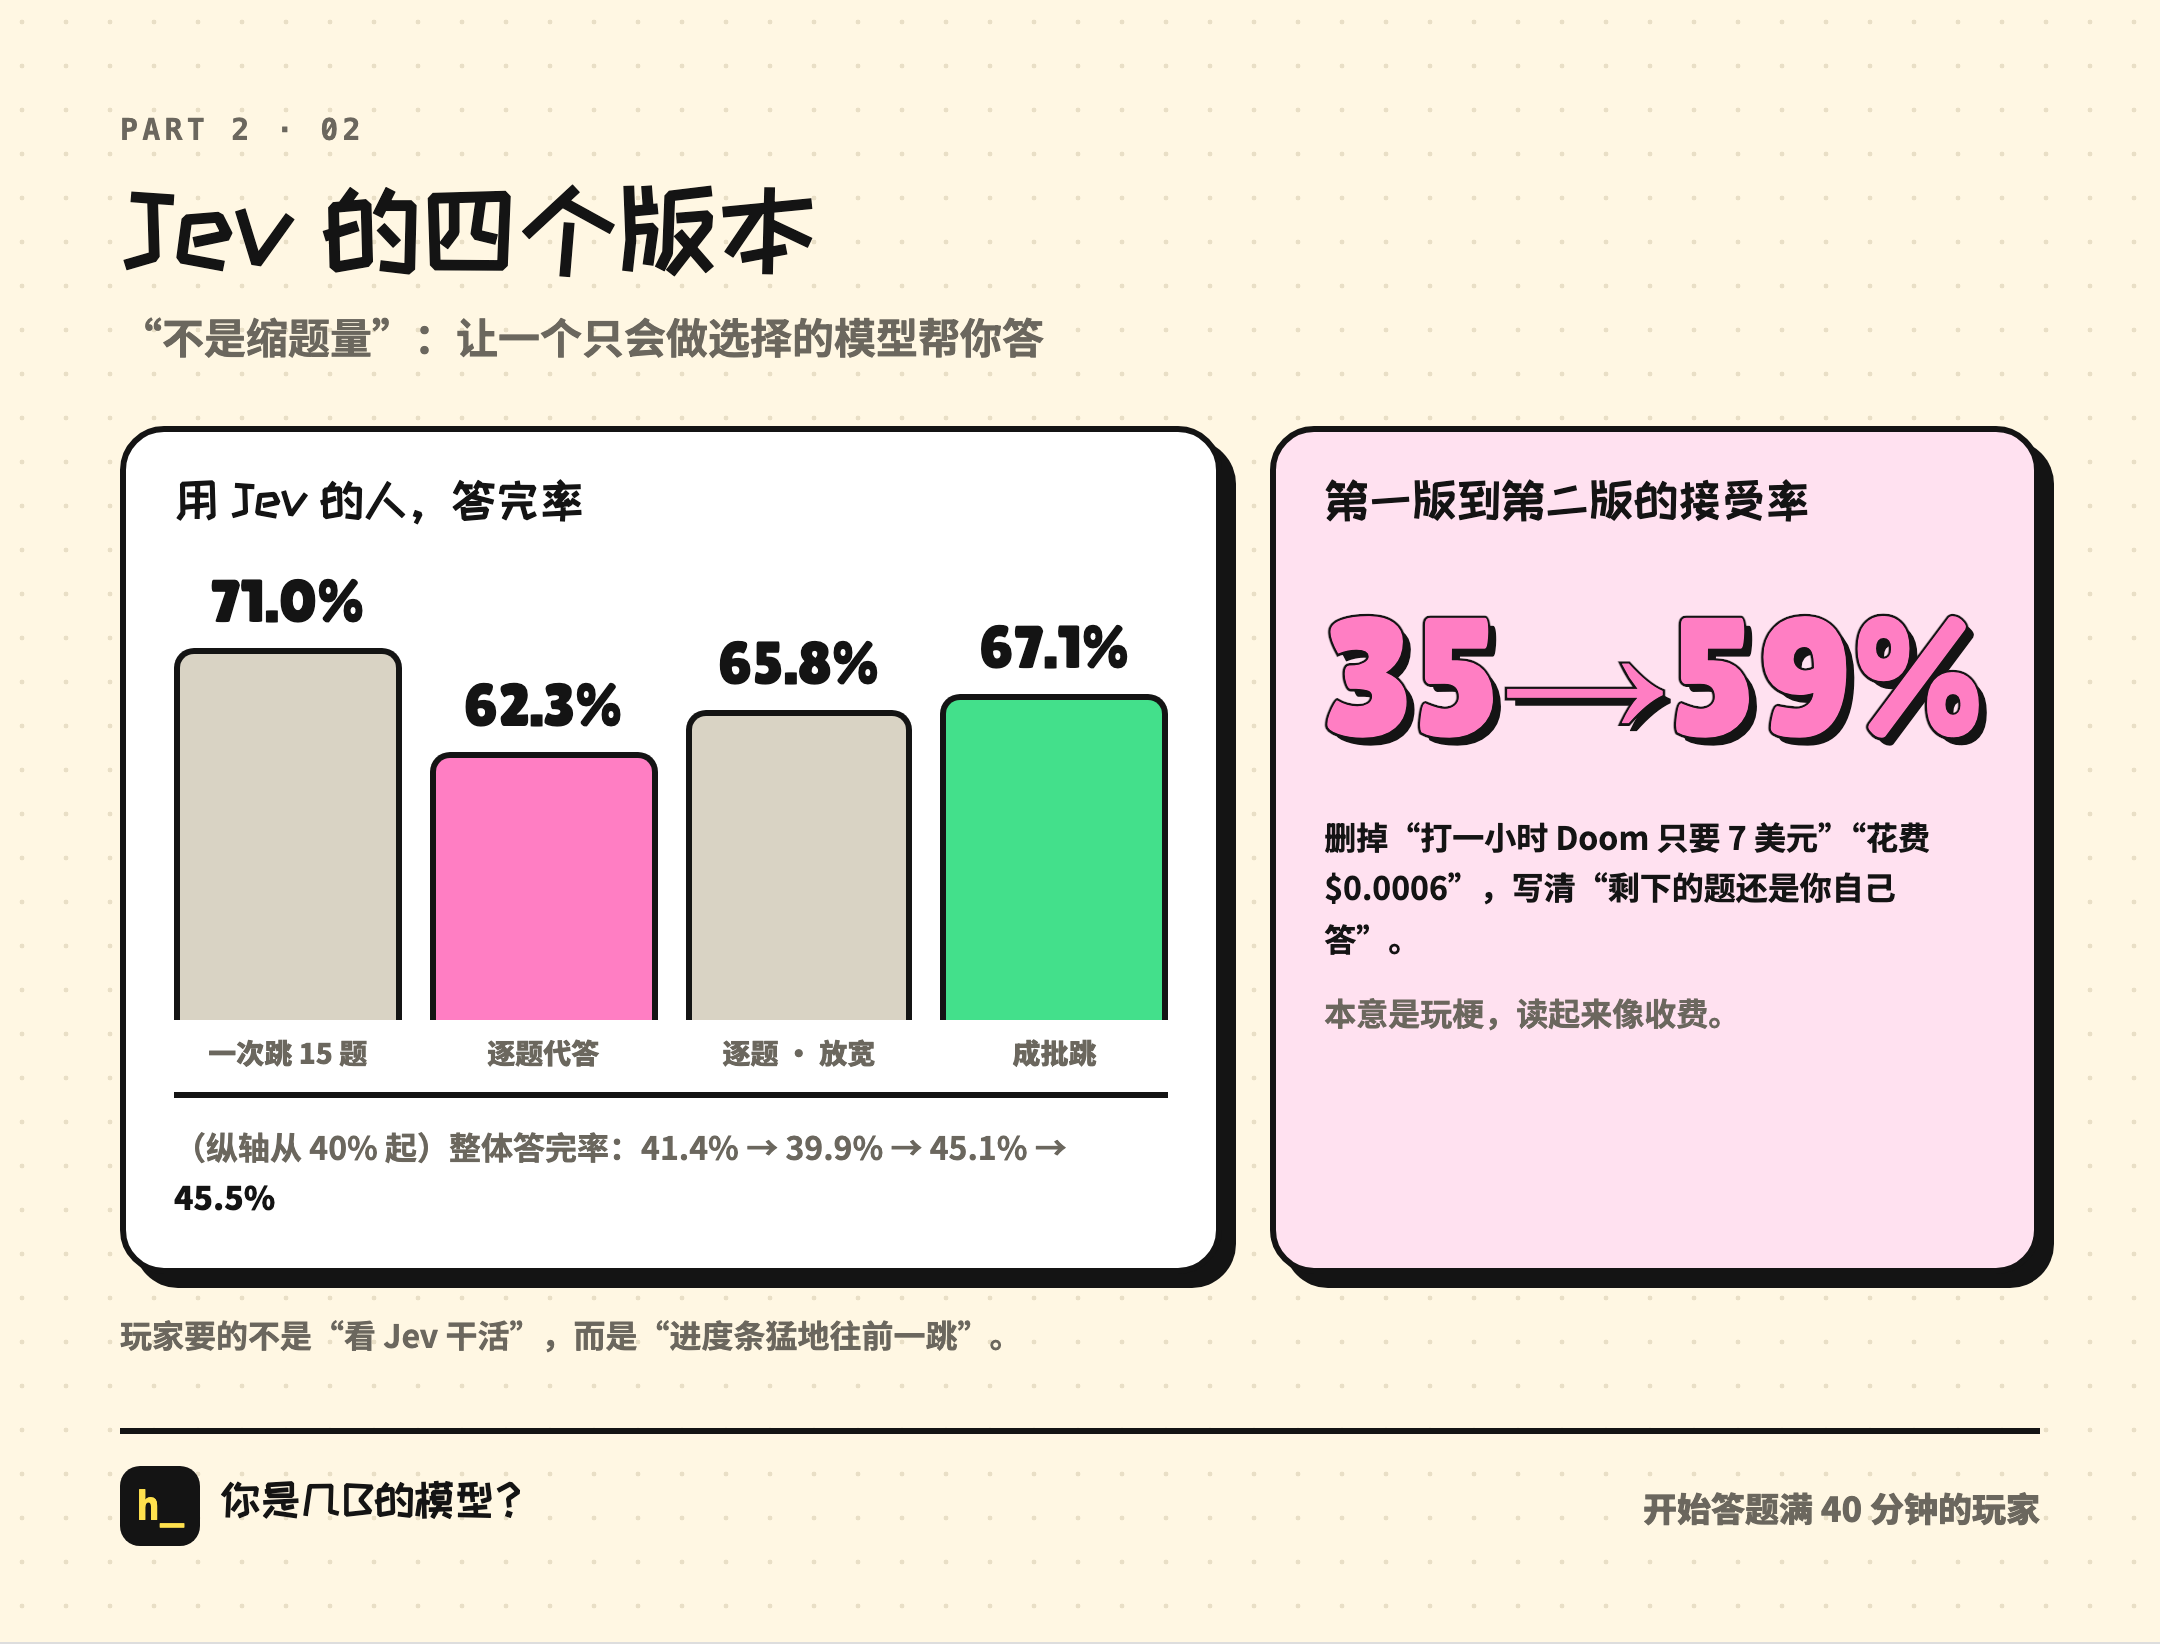
| 版本 | 整体答完率 | 用 Jev 的人答完率 |
|---|---|---|
| 旧版:一次跳 15 题 | 41.4% | 71.0% |
| 一起答:逐题代答 | 39.9% | 62.3% |
| 逐题代答,上限放宽 | 45.1% | 65.8% |
| 成批跳 | 45.5% | 67.1% |
第二天早上又把开局那一跳加到最多 15 道,力度和旧版一样。到第二天中午,39% 的玩家开过 Jev。
玩家要的不是“看 Jev 干活”,而是“进度条猛地往前一跳”。
三、第 3 题的 12%
上线两个小时,Claude 看到 23% 的人没撑到第 5 题,怀疑是开局太难:第 2 题就是一道 ARC 找规律的格子题。它提议调题序,把前 5 题换成 strawberry、9.11、深度思考模式的对话、一道随机经典梗、洗车,ARC 挪到后面。我同意了。
这里的“深度思考模式”,是上线前夜做的一段名场面“好想吃大白饭”:推理题做到一半,思考流里冒出“啊,有点饿了”。它是名场面里梗最足的一段,按“开头放最有梗的”这个原则放到了第 3 题。
四个小时后,前 5 题加上了逐题埋点,数据出来了:
| 停在 | 题 | 占开始人数 |
|---|---|---|
| 第 1 题 | strawberry | 4% |
| 第 2 题 | 9.11 vs 9.9 | 3% |
| 第 3 题 | 深度思考模式 | 12% |
| 第 4 题 | 随机经典梗 | 9% |
| 第 5 题 | 洗车 | 2% |
第 6 到 15 题平均每题走掉约 2%,第 3 题是它的 6 倍。“停在第 4 题”其实是答完第 3 题那段对话才走的,所以两题合计的 21% 大概率都是这段对话造成的。
原因不难找:这段对话的开头是一道说谎者逻辑题,“甲说乙在说谎,乙说丙在说谎,丙说甲和乙都在说谎……”,一共 5 个节点、315 字的思考流,是全部对话里最长的一段。放在第 3 题,等于开局就让人做一道逻辑题。
第一次改:换成一道点一下就完的“AI 味现场”,深度思考挪到第 11 题。第 3 题的流失从 11.7% 降到 3.8%(样本多了之后是 3.2%)。但过第 15 题的比例只多了 2 个点,因为流失跟着这段对话挪到了第 11 题。
我刷评论区的时候也看到了:
哦哦 是不是Q11这个题目不太行啊 感觉很多人吐槽了 要不换个题目吧
于是停用。第 11 题改成从“1 美元买车”“AI 小卖部”“转人工”三段短对话里随机抽。
| 批次 | 停在第 3 题 | 过第 5 题 | 过第 15 题 |
|---|---|---|---|
| 深度思考在第 3 题 | 11.7% | 71.8% | 54.0% |
| 挪到第 11 题 | 3.2% | 83.6% | 57.3% |
| 停用 | 1.3% | 85.1% | 62.6% |
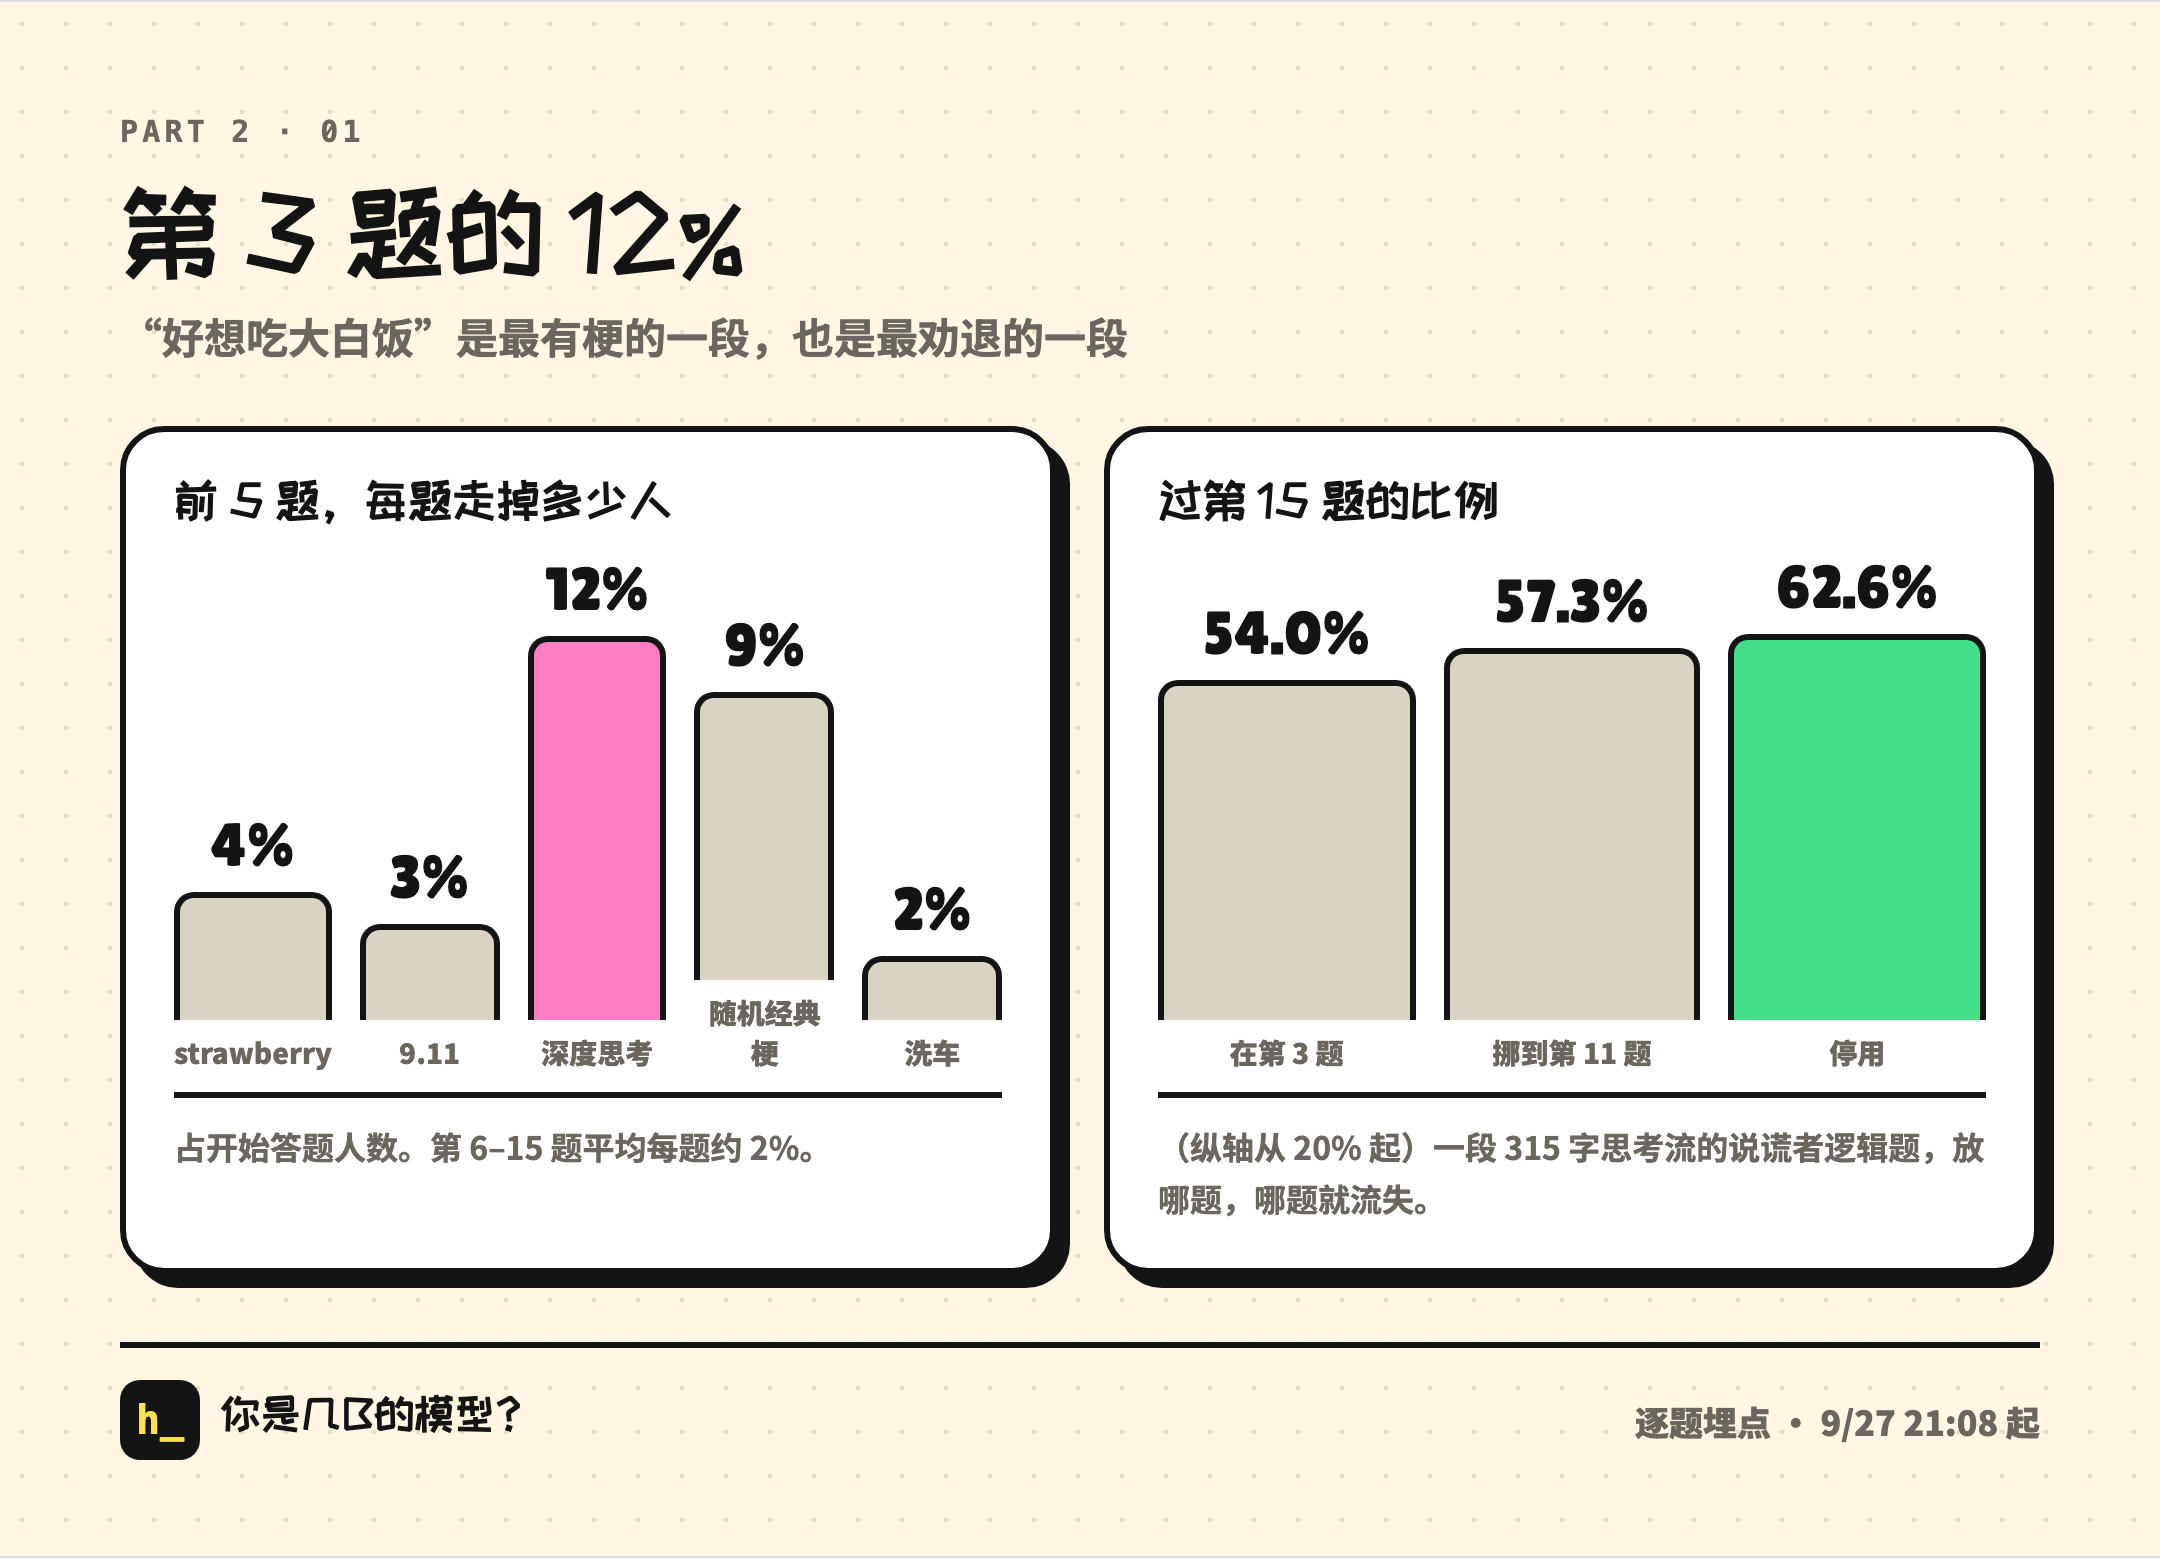
过第 15 题净多了 8.6 个点。按当时每小时 1,500 人开始答题算,相当于每小时多 130 人走过第 15 题。
有个细节我是写这篇复盘时才发现的。那天凌晨两点,忙完一轮,我给 Claude 发了一句:“嘿嘿 还是想回味一下 夸夸我”。(是的,我就吃这一套。)它夸了一大段,其中一句是:“深度思考那道题是你亲手放在第 3 题的,数据说它劝退人,你二话不说就换掉了。”翻记录才看到,放在第 3 题是它自己提议、我同意的。AI 会把功劳记到人头上,这件事本身挺有意思。
四、逐题流失表
第 3 题的事让我意识到,只看前 5 题不够:
有没有逐题的埋点流失表啊 我们的目标就是要裂变 嘿嘿
Claude 加了一个“离开”事件:答题中切走或关掉页面时,记下停在第几题、具体是哪道题。一个小时后出了第一张完整的 76 题流失表。这张表后来成了我们最常看的东西:
- 到第 16 题还剩 61%,之后到结束只再掉 14 个点,第 30 题以后每题走掉不到 0.5%。流失几乎全在前 16 题。
- 流失最多的几道:第 16 题(第二段名场面)、第 10 题(ARC 找规律,其中一道一题走了 11 个人)、第 4 题、第 6 题、第 14 题(Dense 体检)。
然后查出一个原因:程序会给 ARC 比玩家当前水平再难一档的题,前 9 题答得好的人,第 10 题就会撞上 Boss 级的 ARC;第 7、9 题也会给高手出 Boss 级常识题。改成第 20 题之前所有题最多到第 3 档(Boss 是第 4 档)。
| 第 6–15 题合计流失 | 过第 15 题 | 答完率 | |
|---|---|---|---|
| 限制前 | 21.8% | 64.1% | 45.3% |
| 限制后 | 18.7% | 66.0% | 45.3% |
中段的流失少了 3 个点,但答完率一点没变:一部分人只是把放弃往后推了。这个结果不算失败,但提醒了我们:中间指标变好,不等于最终指标变好。几个小时后,这个教训又来了一次,而且更疼。
同一张表还发现:“1 美元买车”放在第 11 题,流失是另两段的两倍,于是第 11 题只从 AI 小卖部和转人工里抽。
五、人格:用真实玩家重新校准
上线一个半小时,512 个答完的人里,GPT-5 型 34%、Grok 型 28%、GPT-4o 型 22%,前三名加起来 84%。
原因是人格的基准线是用“随机乱选”模拟出来的,而真实玩家特别爱选整活选项,于是人人都偏向 Grok 和 4o。Claude 先在答完事件里加了人格的原始特征(只存 25 个数字,不存选项原文),攒了 1,747 份答卷后重算基准线。
校准之后,前三名加起来降到 51%,八种人格从 17% 到 6% 不等。最多的是 4o 和 GPT-5,最少的是 Kimi。上篇里我说的“实事求是,但分布别离谱”,到这时才算用真实数据落了地。
六、繁体:“抽查会不会有点草率啊”
傍晚我问 Claude,要不要再加几种语言,比如法语。它拉了数据反对:法国一共才 10 个访客,西班牙语版上线以来只有 7 个人打开过。真正缺的是繁体:香港和台湾加起来 625 个访客,占 17%,比韩国多 6 倍,他们只能看简体版,还有一百多人被分进了英文版。
我说:“你现在就做吧 繁体和法”。
法语的结果和 Claude 预料的一样:到午夜只有 31 个访客、9 个人答完。好在成本很低,几乎没占用主线时间。
繁体的计划是先用 OpenCC 自动简转繁,再抽查。我插了一句:
抽查会不会有点草率啊
然后又是两句:
不过繁体中文 香港的好像不是这个说法啊
说法也不一样吧 什么软件 软体
于是改成派 14 个审校,台湾用词、香港用词各一轮,逐句对照。查出的问题有六百多处:
- 测试“通过”被自动转成了“透過”,意思全反,光一段题库就有 9 处;
- “质量”在台湾指物理上的质量,要说“品質”;
- 大陆说法换成当地说法:西红柿换成番茄,考拉在台湾叫無尾熊、在香港叫樹熊;
- 还查出一个构建 bug:转换脚本把一部分结局描述当成模型名保护了起来,导致 290 条结局描述在繁体版里一直是简体。
繁体版只有一个“繁體”入口,按访客所在的地区自动换用词:軟件或軟體,的士或計程車。
午夜时,繁体页有 742 个访客,答完率 47%,比简体页的 42% 还高。
七、英文版:改对了后半,改坏了开头
第二天上午,各语言的答完率在 40% 到 60% 之间,只有英文是 18% 到 23%。英文页的开始率也最低:57.5%,而中文是 74%、韩文是 82%。
我觉得可以 英文区的特意化处理一下吧 估计更没有耐心
还有可能和梗还有语言环境有关 你瞅瞅看
Claude 先排除了“美国用户不爱玩”:美国 IP 整体的答完率有 41%,只是英文页低。而且英文的流失很均匀,前 6 题每题掉 4% 到 7%,不是某一道题坏了。结论是内容的问题。
我们提了四个假设:开局全是英文 AI 圈早就刷烂的 2024 年老梗(strawberry、9.11);常识题是过时的网络冷知识(番茄是浆果、金鱼只有 7 秒记忆);英文比中文长很多,手机上读着累;翻译腔,笑点在翻译里丢了。
然后派了两组“英文编辑”,按英语 AI 圈的口味重写:开局换成 2025 年的新梗(GPT-5 发布那周的“blueberry 里有几个 b”、“5.9 = x + 5.11”);41 道常识题换了 27 道;三体换成沙丘;写了一份 40 行的英文风格指南。
改写后第一次看数据,结果很微妙:
| 停在 | 改写前 | 改写后 | 这道题 |
|---|---|---|---|
| 第 2 题 | 3.8% | 7.0% | 9.11 vs 9.9 → 5.9 − 5.11 |
| 第 3 题 | 8.2% | 13.4% | AI 味现场 |
| 第 5–11 题合计 | 23.6% | 12.0% |
中后段的流失差不多减半,但开头掉得更多,整体答完率从 26% 掉到了 20%。第 2 题的流失翻倍:解方程比一眼比大小费脑多了。
修正:第 2 题换回 9.11;22 道 AI 味现场的选项全部压到 60 个字符以内。晚上答完率回到 25.4%,接近改写前的 26.8%。
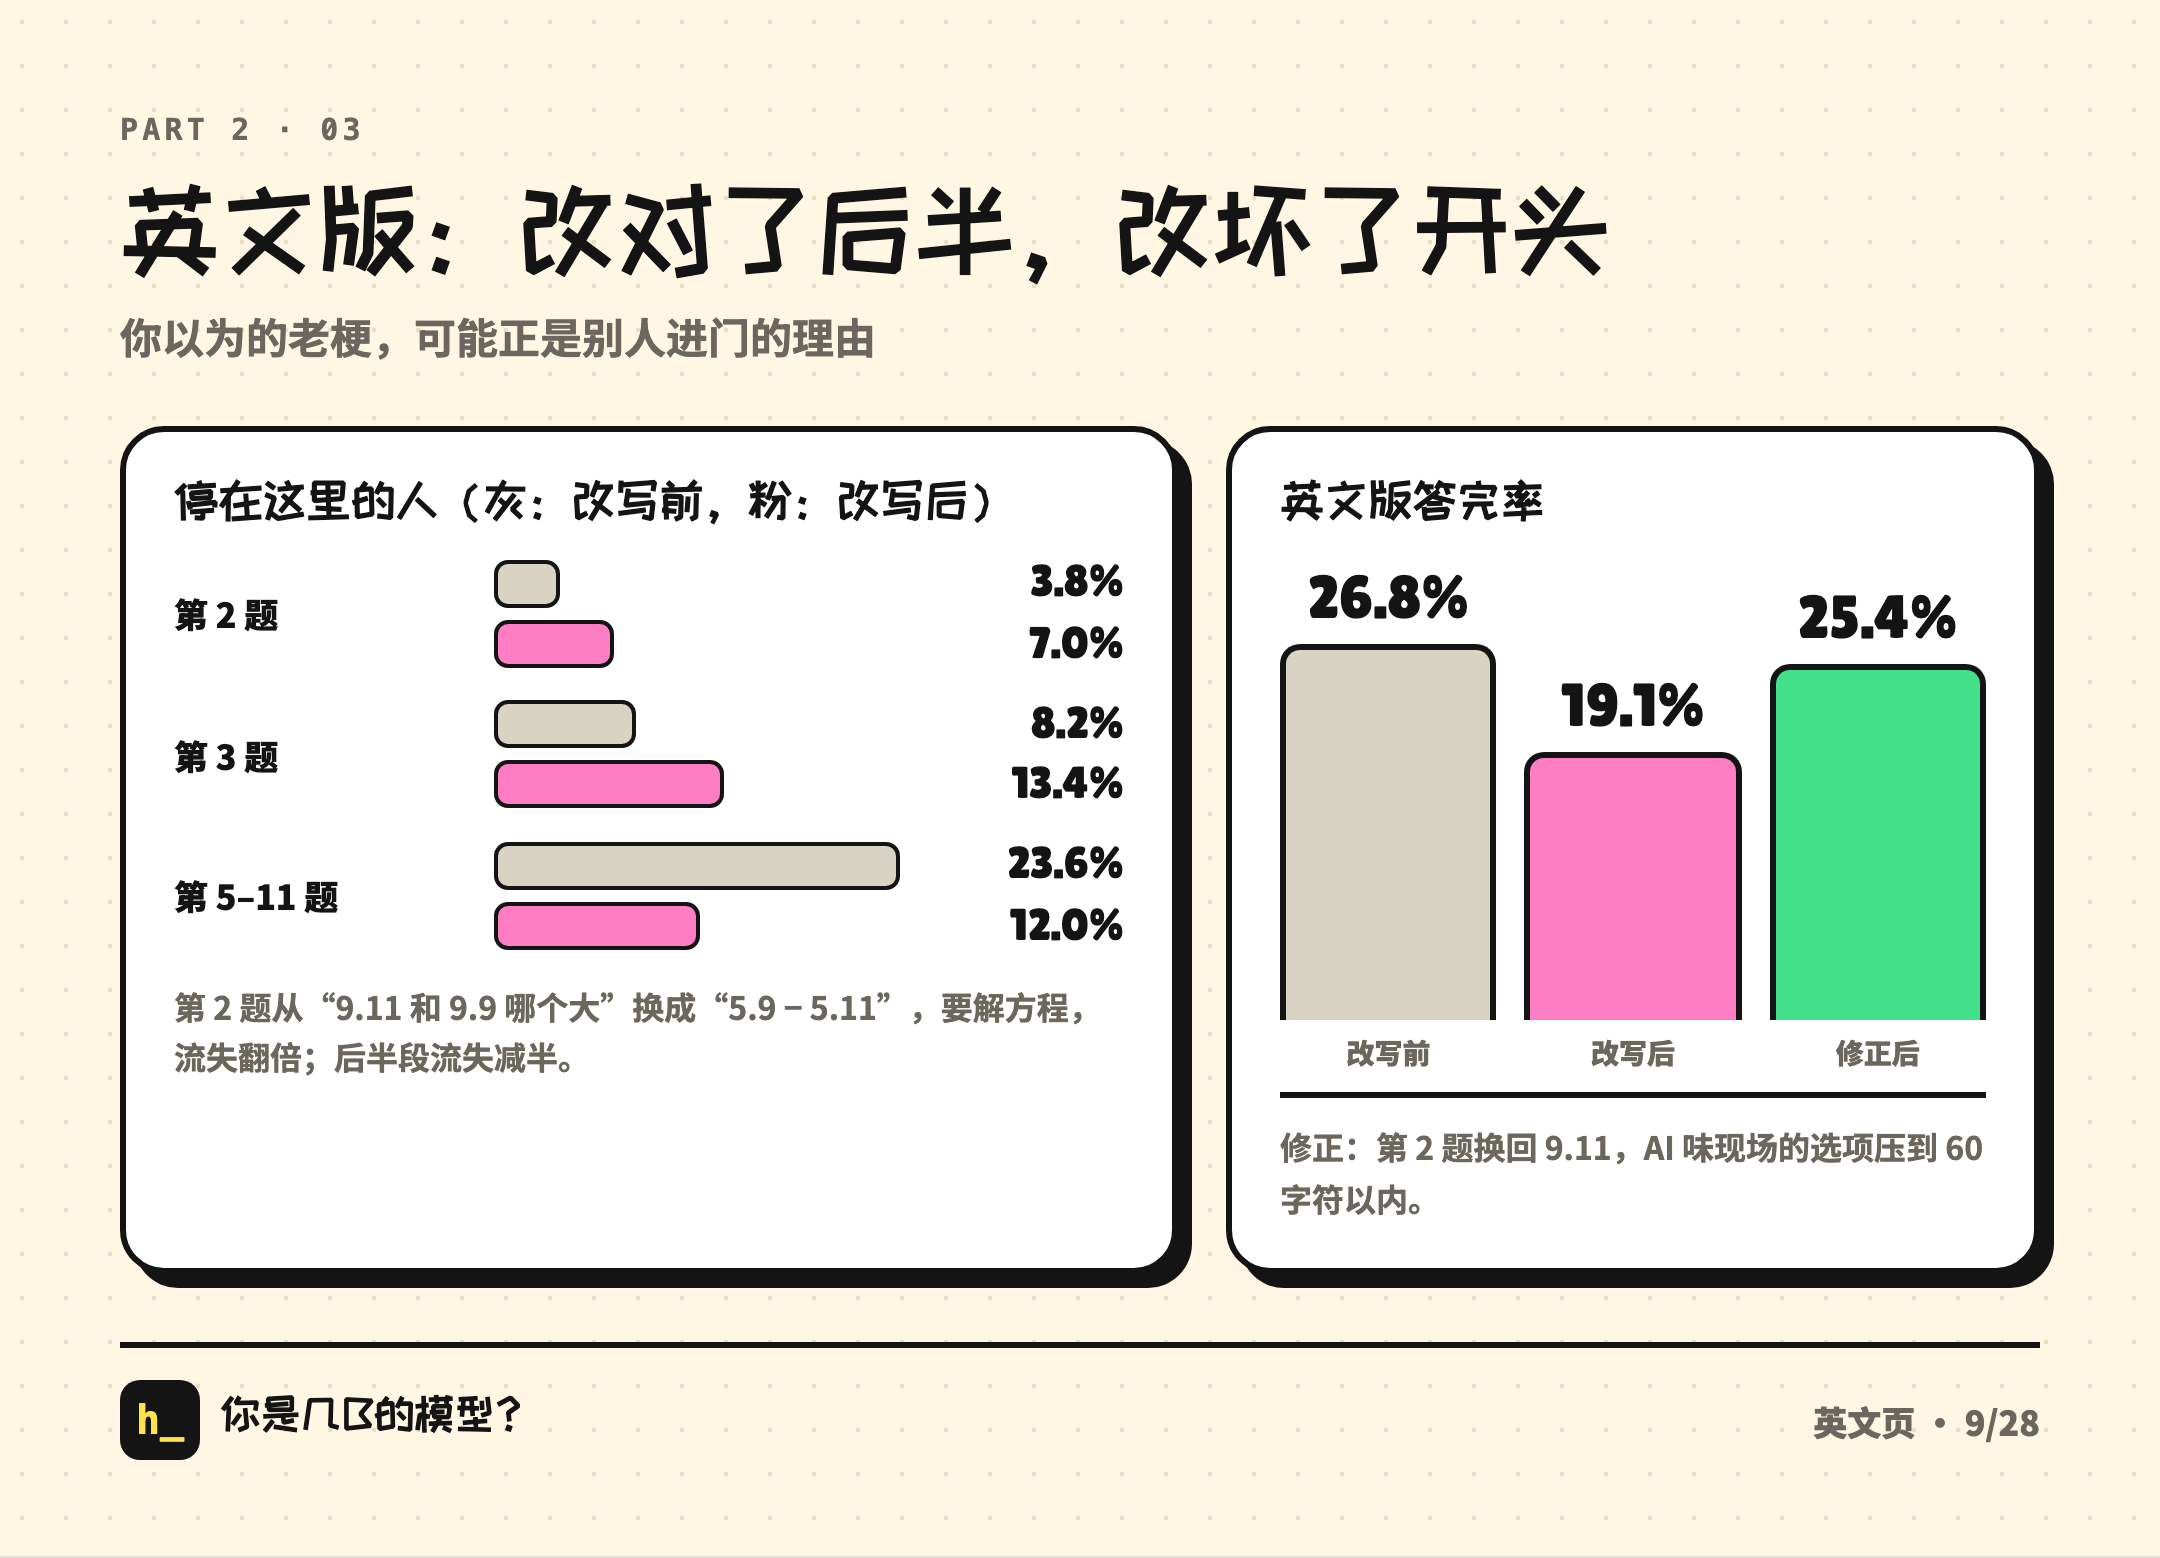
两个教训。一是你以为的老梗,可能正是别人进门的理由:strawberry 和 9.11 在英文圈确实被刷烂了,但正因为人人都懂,才适合放在门口。二是逐题表的价值在于能把“整体变差”拆成“哪几题变好、哪几题变坏”。只看总数,我们会得出“改写失败”的结论,然后把后半段改好的部分一起扔掉。
八、“不需要 AB,只看 AA 指标”,以及 Claude 的一次自我更正
第二天中午,我让 Claude 拉一张“渠道 × 流失”表:
| 从哪打开 | 过第 12 题 | 答完 | 用 Jev 的人答完 | 不用 Jev 的人答完 |
|---|---|---|---|---|
| 普通浏览器 | 73% | 48% | 66% | 40% |
| 68% | 42% | 73% | 32% | |
| 微信 | 62% | 37% | 65% | 27% |
| X | 57% | 30% | 58% | 20% |
X 来的人到第 12 题(Jev 第一次邀请的位置)已经走了 43%,大部分人等不到邀请。Claude 提议做 A/B 测试,我拍板:
1. 这几类玩家在第 4 题弹 Jev 邀请……在 X 内置浏览器打开的;在微信内置浏览器打开的;从 X 链接点进来的;英文版的所有人。2. 其他人保持第 12 题不变。我觉得就这个吧 就按这个策略 不需要AB 只看AA指标得了
(这里的 AA 指标,指的是整体指标,不是 AI 智能指数。)
上线后两个小时,Claude 两次报告:提前弹的渠道,过第 15 题多了约 4 个点,“中段留存在变好”。
又过了一个多小时,它自己推翻了:
我之前说“中段留住了更多人”,这个说法不成立。Jev 开启时会一口气跳过最多 15 道题,被跳过的题也算“到达”……唯一靠得住的指标是答完率。扣掉对照组的自然波动,提前弹之后答完率反而低了约 2 个点。
用 Jev 的人确实从 26% 涨到了 49%,过第 15 题从 60% 涨到 67%,但这些都是 Jev 跳题“跳”出来的,不是人真的留下来了。答完率从 37.6% 变成 36.8%,同期对照组从 46.0% 涨到 47.2%。
我回:“好哦 我觉得可以恢复”。全部渠道恢复成第 12 题邀请。
这是整个项目里唯一一次由 AI 主动承认读错了数据、建议撤回的改动。回头看,“不做 A/B”换来了上线快,代价是只能靠对照渠道去扣掉时段的影响,还差点被一个口径骗了。
九、题库扩 46%:一条 AI 流水线
第二天早上,Claude 注意到 11% 的答完玩家玩了两遍以上,于是算了一下“撞题”的概率:好友之间,人格小对话撞题 50%,名场面对话 40%,AI 味现场 33%。分享卡上最显眼的内容,恰好来自题库最小的三类。
前两轮先把这三类翻了倍。上午十点,我又说:
扩充吧!我建议是至少扩充45%的题库 你觉得呢?
加量不要变质哦!需要和原来一样 梗味十足
Claude 按“每局抽几道 ÷ 题库有几道”排了优先级,最容易撞的是图表题(每局 4 道,题库只有 9 道)和电脑操作题。目标从约 404 道扩到 589 道,加 185 道,也就是 46%。然后搭了一条流水线:
- 写一份统一的写作说明和一个自检脚本;
- 11 组子任务并行写中文,每组负责一个题池,所有命令、正则、代码都要实际跑一遍;
- 两位“梗味总编”审稿,给每道题的“梗、准、短、能翻译、不冒犯”打分,4 分以下的直接改或换;
- 5 种语言 × 3 组,15 组并行翻译;
- 每种语言一位母语终审,从头读到尾;
- 繁体两轮审校;
- 7 种语言的冒烟测试,新增的每段对话都点到结局。
上午十点半开工,下午一点半上线。每一步的说明文档都在开源仓库的 prompts/03-agent-briefs.md 里,可以直接复用。
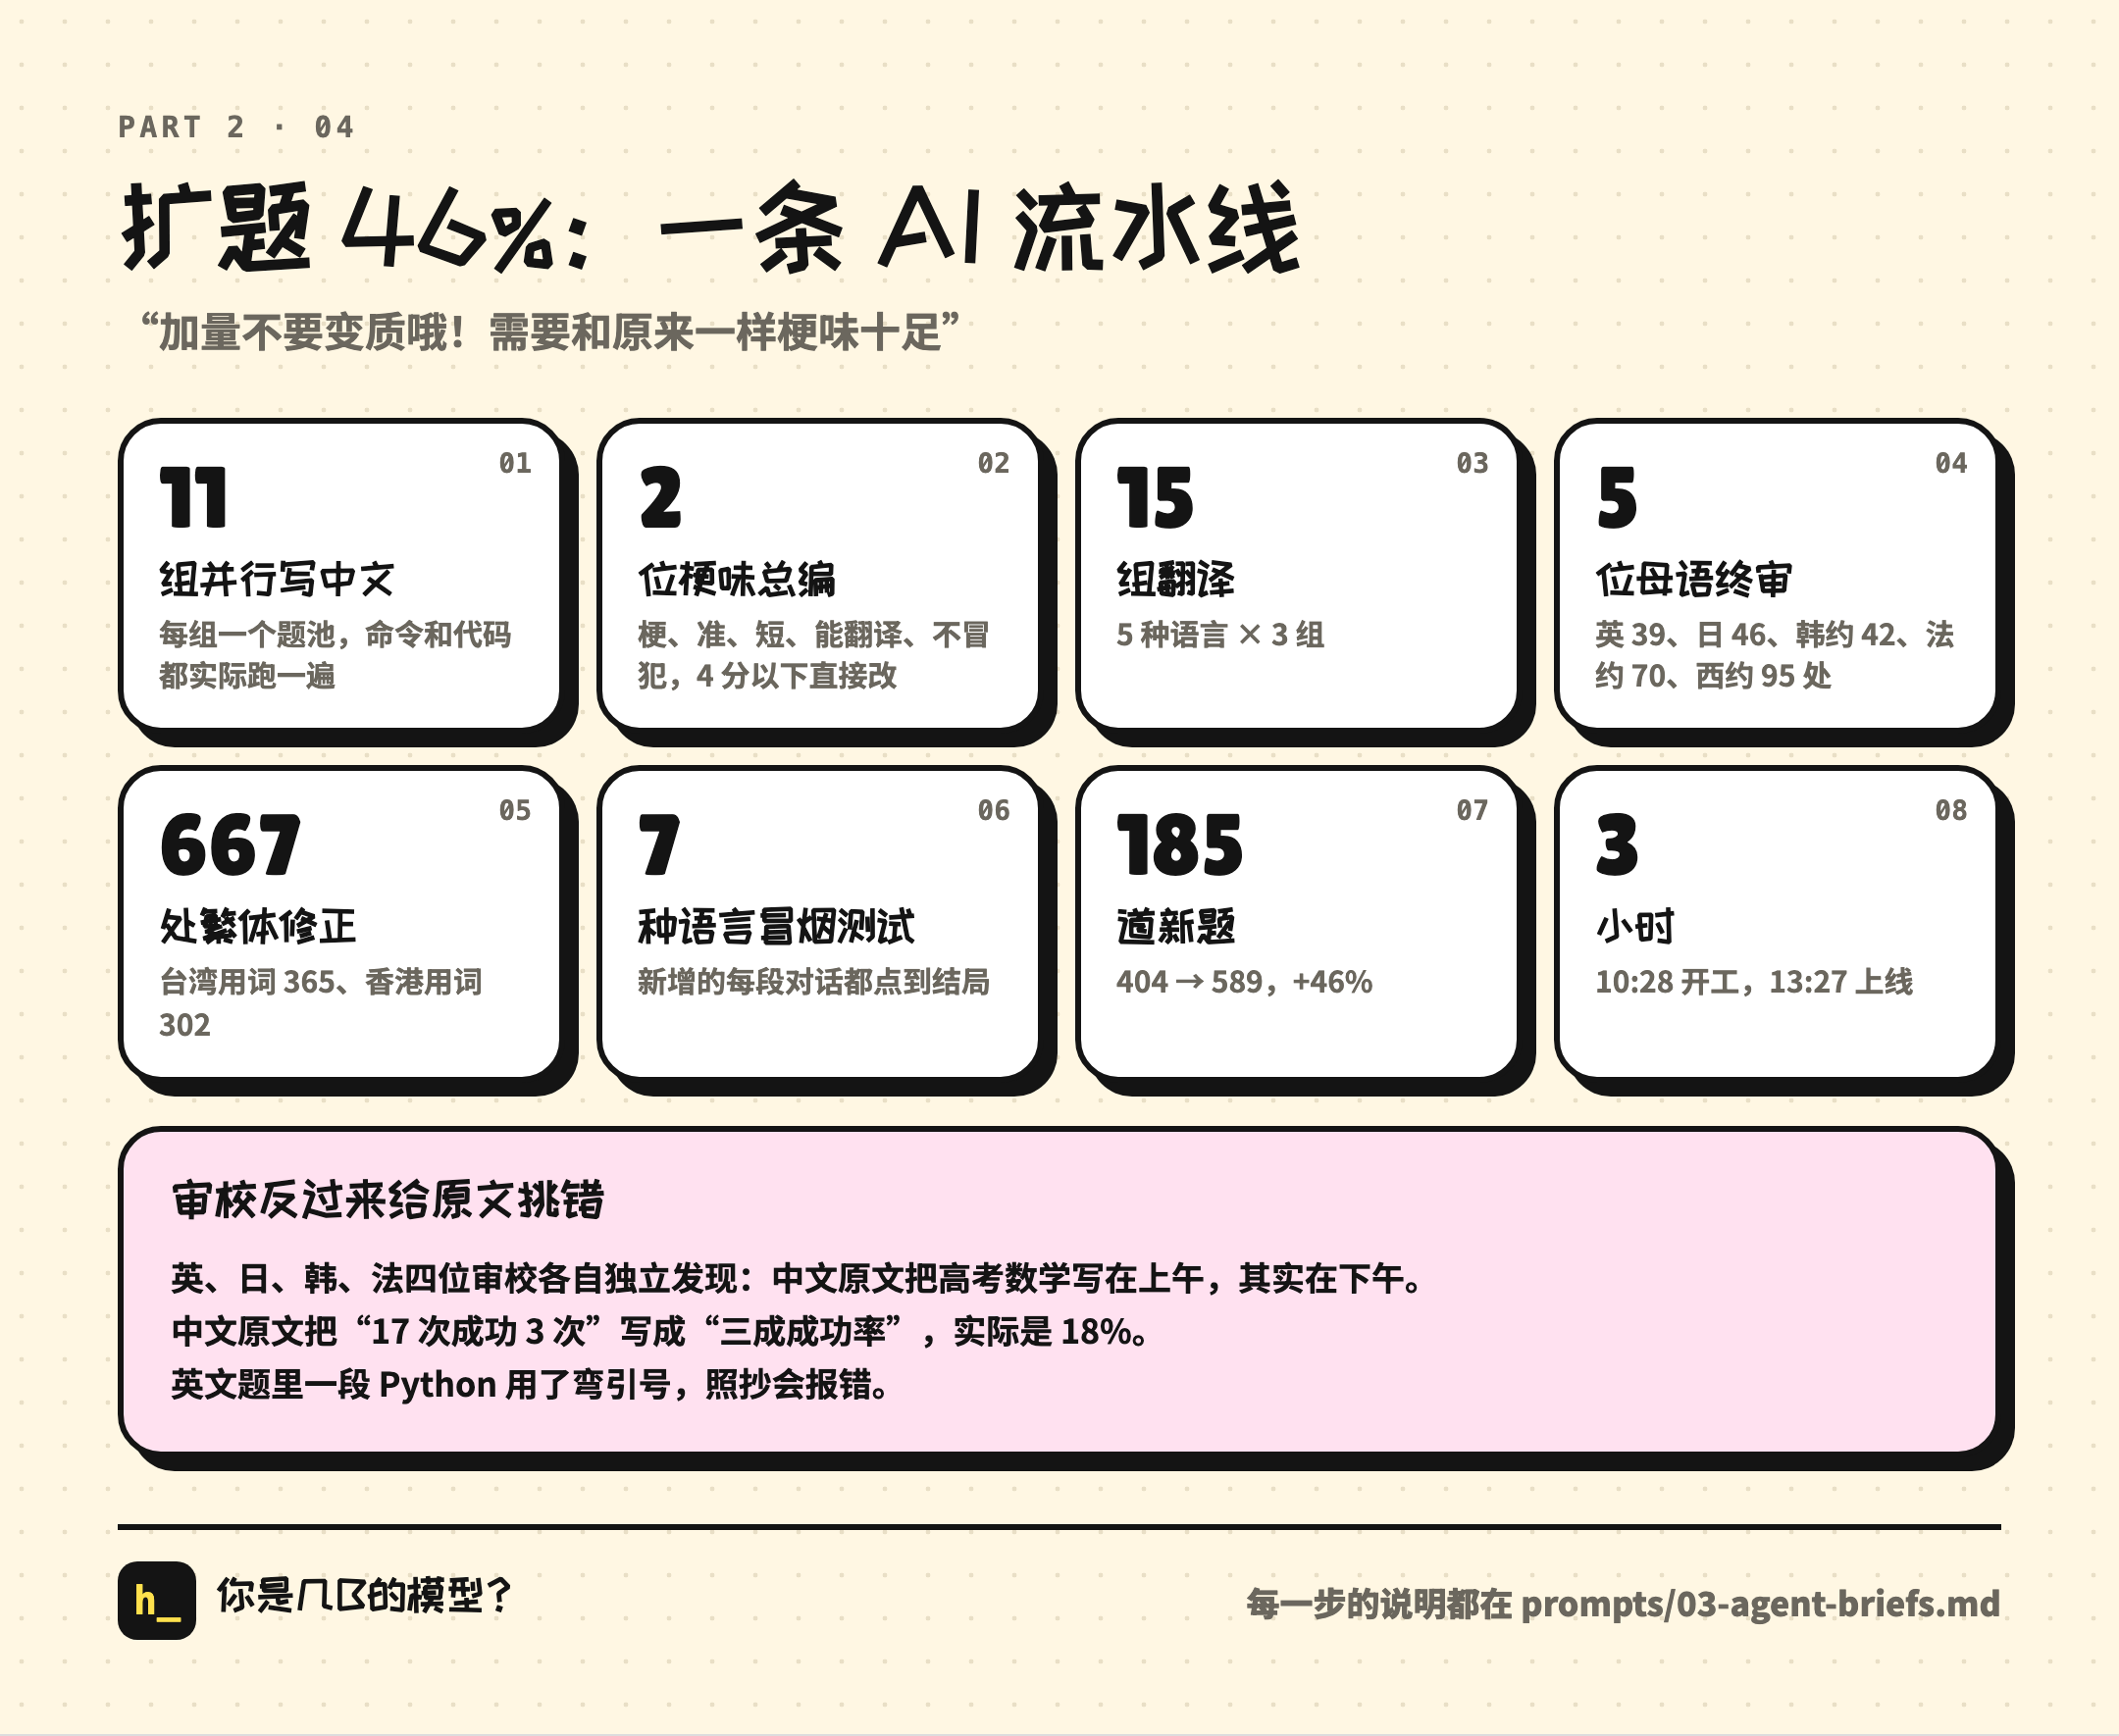
这条流水线里最有意思的,是审校反过来给原文挑错:
- 四个国家的审校,各自独立发现了同一个错误。 早一轮的本地化里,中文原文写着高考数学在“6 月 7 日上午”,实际那天上午考语文,数学在下午。英、日、韩、法四位审校互相看不到对方,都指出了这个问题。那一轮我只是担心“日语也有高考嘛?”,Claude 一开始还觉得原句没问题,但还是派了审校。
- 中文原文把“17 次成功 3 次”写成“三成成功率”,实际是 18%;
- 英文题里一段 Python 代码用了弯引号,照抄会直接报错;
- 日语有一处意思译反了;韩语的一个词现在被视为歧视用语,换掉了;
- 繁体里“对象”(交往对象)被台湾的转换规则转成了程序术语“物件”,一个双关梗就断了;
- 写手两次写了“AI 玩宝可梦困在月见山”,两次都被我砍了:“Pokémon 月见山 感觉不出圈啊”。
翻译流程反过来给原文做了一遍事实核查。
也出过一次意外:某个翻译组跑了完整构建,线上繁体版自动从简体转了一份,带上了还没审过的新题。发现后马上派审校补上。
十、Safari 和四角星
第二天上午,我给 8 种人格做了专属配色:豆包型加一条红围巾,Gemini 型加四角星背景,Grok 型加斜杠纹和警示胶带。先做成私密预览,我审过才上线。
两个小时后,我自己测出了 Gemini 型,分享卡生成失败:
我是 中文 1.5B模型 dense gemini人格失败的 不知道为啥 还是说和ip有关?
safari
昨天晚上至少是好的 不知道发生了什么
Claude 两分钟内定位到原因:Gemini 的四角星、Grok 的斜杠纹,都是用 CSS 背景嵌 SVG 图做的。Safari 把这种图画进画布后,会禁止把画布导出成图片。豆包的红围巾恰好是用普通图片标签放的,所以没事。我们之前一直在 Chromium 里测,从来没触发过。
从配色上线到修好的两个小时里,所有用 Safari 测出 Gemini 型和 Grok 型的人都导不出分享卡。修法是三块纹理换成 PNG,在 Safari 的内核下把 9 种配色都测一遍,再加一个“导出失败”的埋点。
这个埋点随后又抓到另一个问题:少数人的截图库没从公共 CDN 加载下来。补上从自家域名加载的兜底之后,导出失败归零。
十一、这 36 小时学到的
1. 先找到最大的杠杆。 对一个要玩 20 分钟的测试来说,最大的杠杆是答完率。分享率本来就高(答完的人一半以上会分享),答完的人多了,分享自然多。
2. 逐题表比总数有用得多。 第 3 题的 12%、第 10 题的 Boss ARC、英文版第 2 题的翻倍,都是只看总数永远看不到的。
3. 口径会骗人,而且骗得很自然。 Jev 跳过的题也算“到达”;“开了 Jev 的 63% 对没开的 23%”有自选偏差;最早几张表的时区标错了;不同时间点的答完率门槛不一样。每一个都让我们差点得出错误结论。
4. 我管方向,AI 管测量。 几个关键决定来自我的一句话:“不是缩题量”“抽查会不会有点草率”“应该猛的跳过一批”。几个关键发现来自 Claude:第 3 题的流失、法语不值得做、以及推翻自己的那次更正。反过来也成立:我拍板的“不做 A/B”差点让我们留下一个负优化;Claude 按“开头放最有梗的”放到第 3 题的那段对话,劝退了 12% 的人。
5. 看不出效果的东西,就别指望它。 这一条下篇会展开:有些功能上线后数据纹丝不动,我们留着它,但不再为它花时间。
36 小时过去,答完率从开始时的 29% 左右,稳定到了 45% 上下。流量在第二天晚上开始自然回落。
但在那之前,还有一件事在同时发生:玩家在把它传出去。四成的新访客来自朋友的挑战链接,每个答完的日本玩家平均带来 2.3 个新访客,点挑战链接进来的人,有七成输给了发链接的朋友。
这是下篇的故事。
几百粉丝怎么传到 96 个国家,以及 1.27 万份答卷里的人类
三篇复盘的最后一篇。上篇讲从 4 条消息到上线,中篇讲上线后怎么按数据改产品。这篇讲它是怎么传出去的,1.27 万份答卷里能看出什么,我们收集了哪些数据、没收集哪些,以及人和 AI 在这件事里各干了什么。
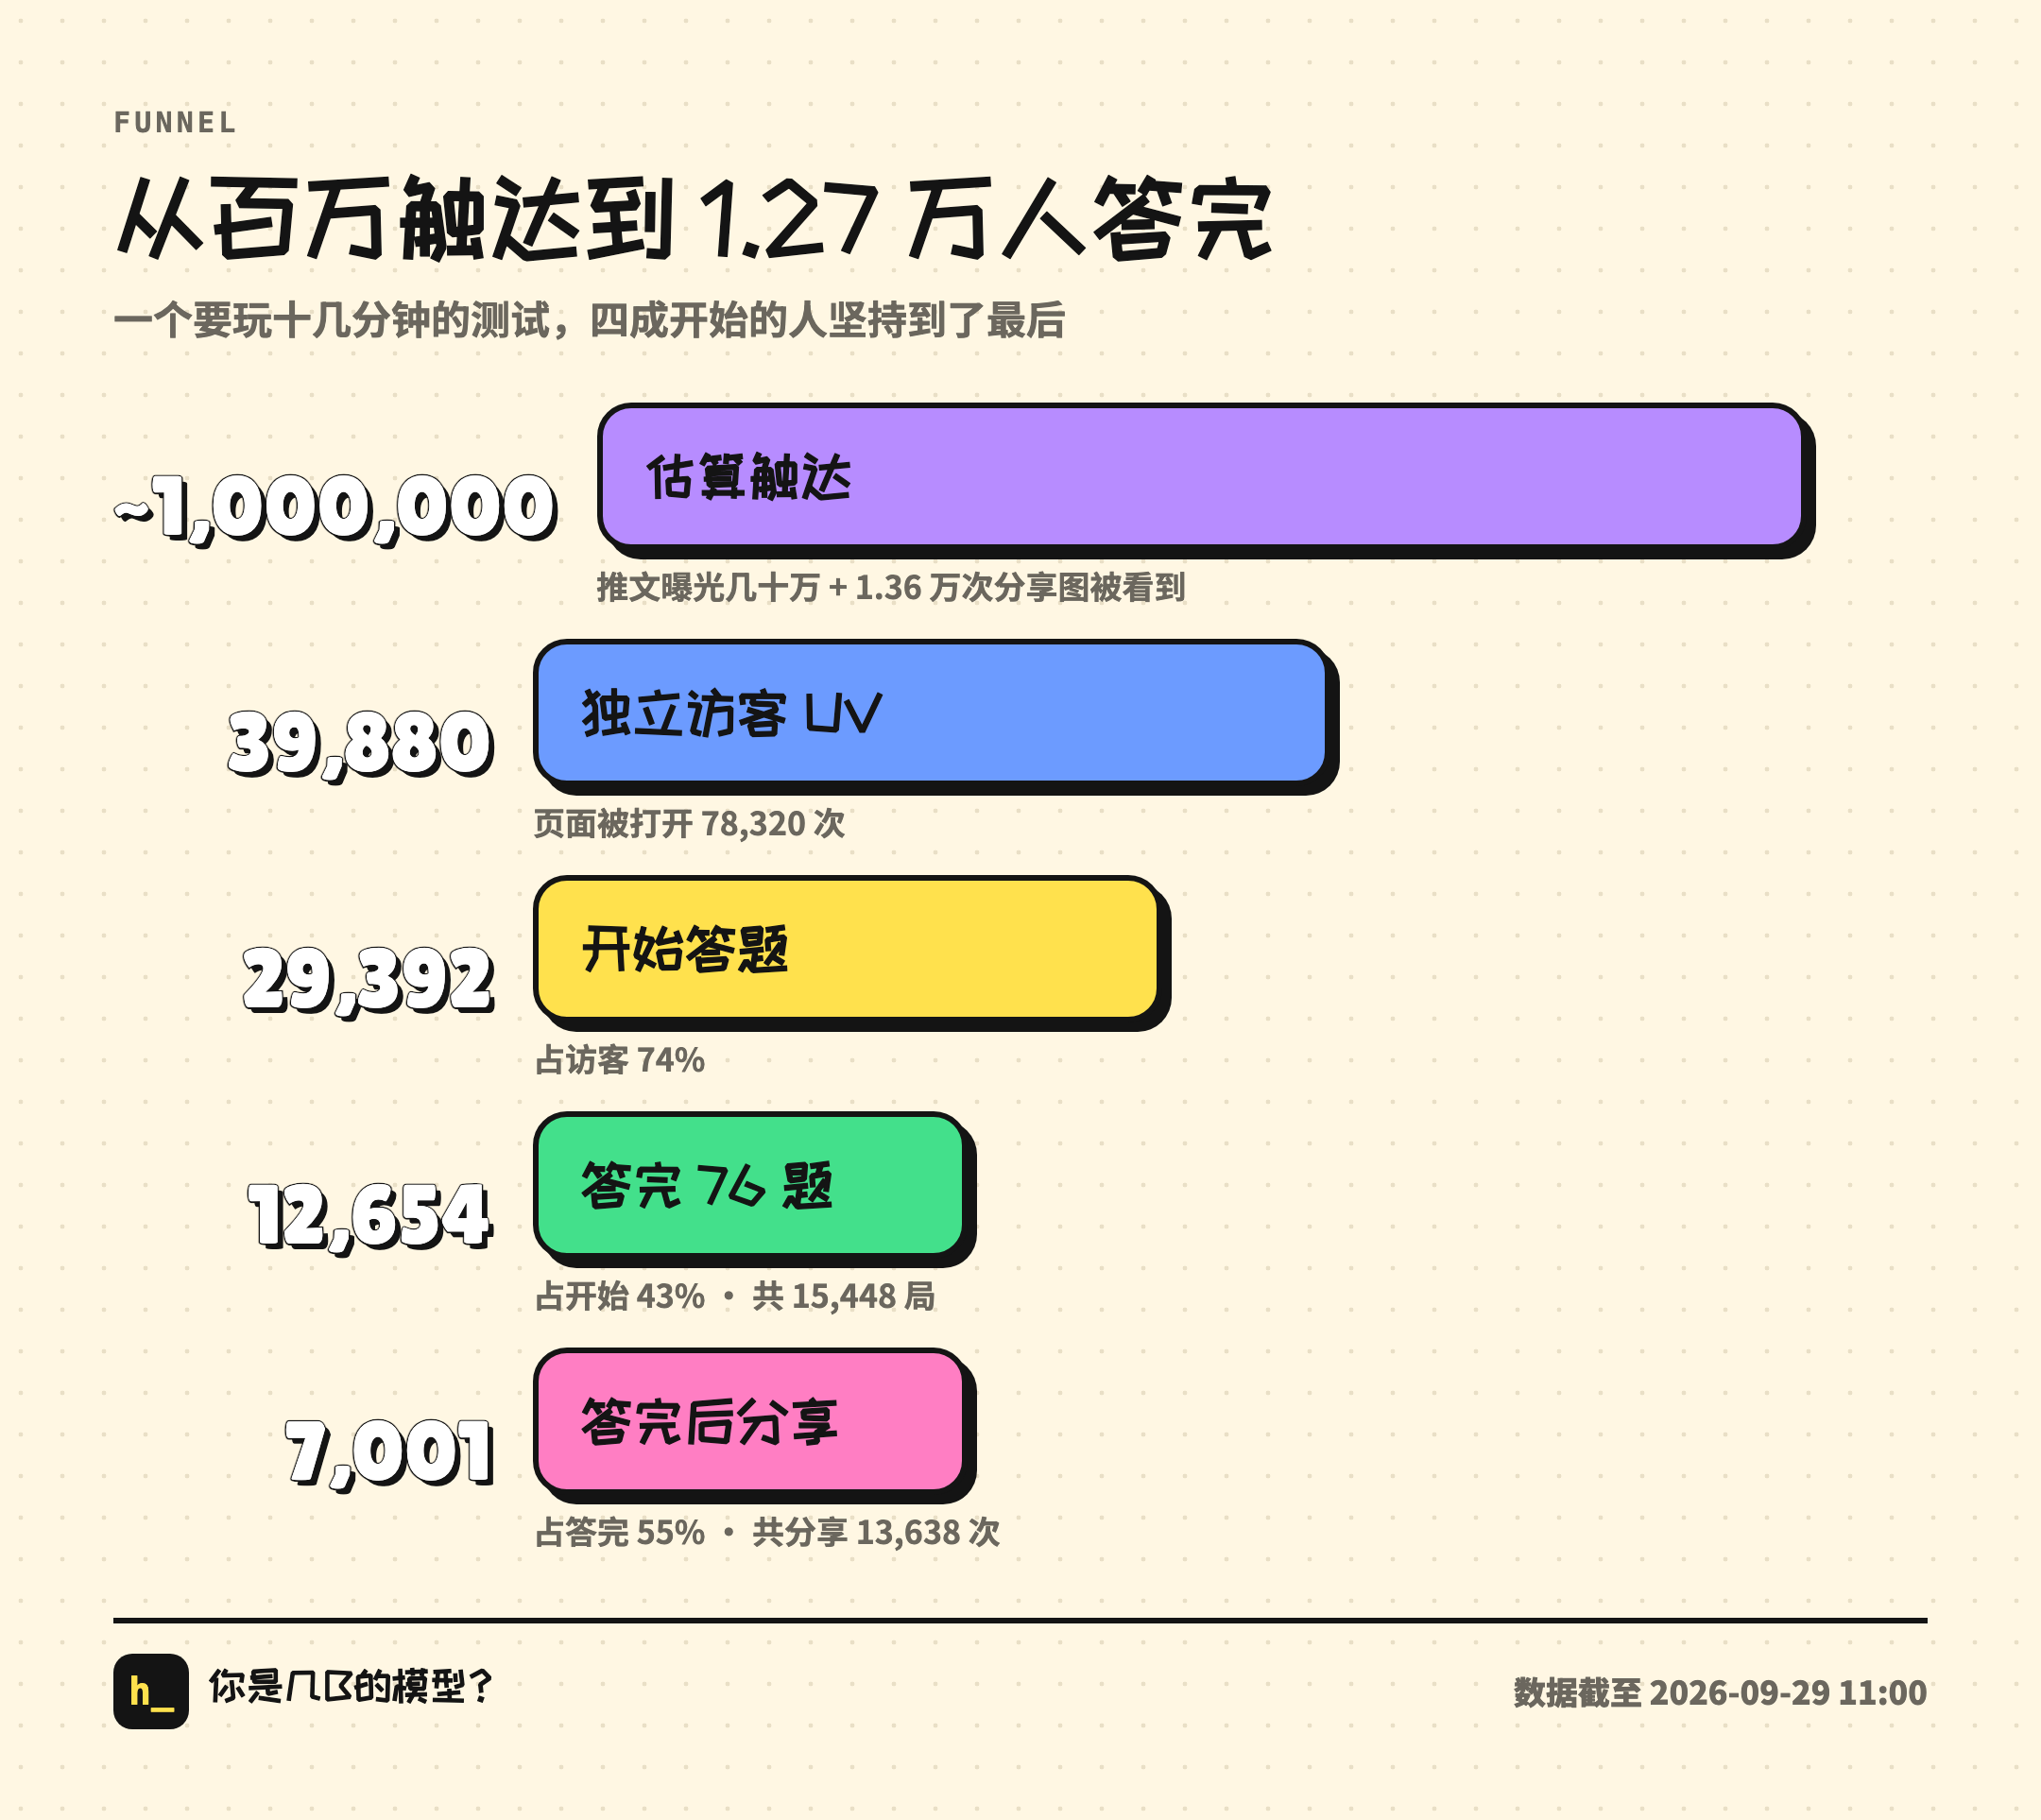
先把最终的数字摆出来(截至 9 月 29 日上午):
- 约 100 万:估算触达人次。推文曝光几十万,加上玩家发出去的 1.36 万次分享被朋友看到的次数。这是估算,不是测量值。
- 3.99 万:独立访客(UV),也就是不同的人;页面一共被打开 7.8 万次(PV)。
- 2.94 万人点了开始,1.27 万人完整答完 76 题,一共答完 1.54 万局。
- 7,001 人答完后做了分享,一共分享 1.36 万次。
- 96 个国家和地区,7 种语言。
- 起点:一个只有几百粉丝的推特号,没有投放。
一、几百粉丝,一条推
上线当晚十点半,我问 Claude:
嘿嘿 热度还行?我这个号粉丝才几百个
它拉了来源数据:九成以上的流量来自粉丝圈外。推文只点燃了第一批人,之后的访客主要是玩家互相带来的。
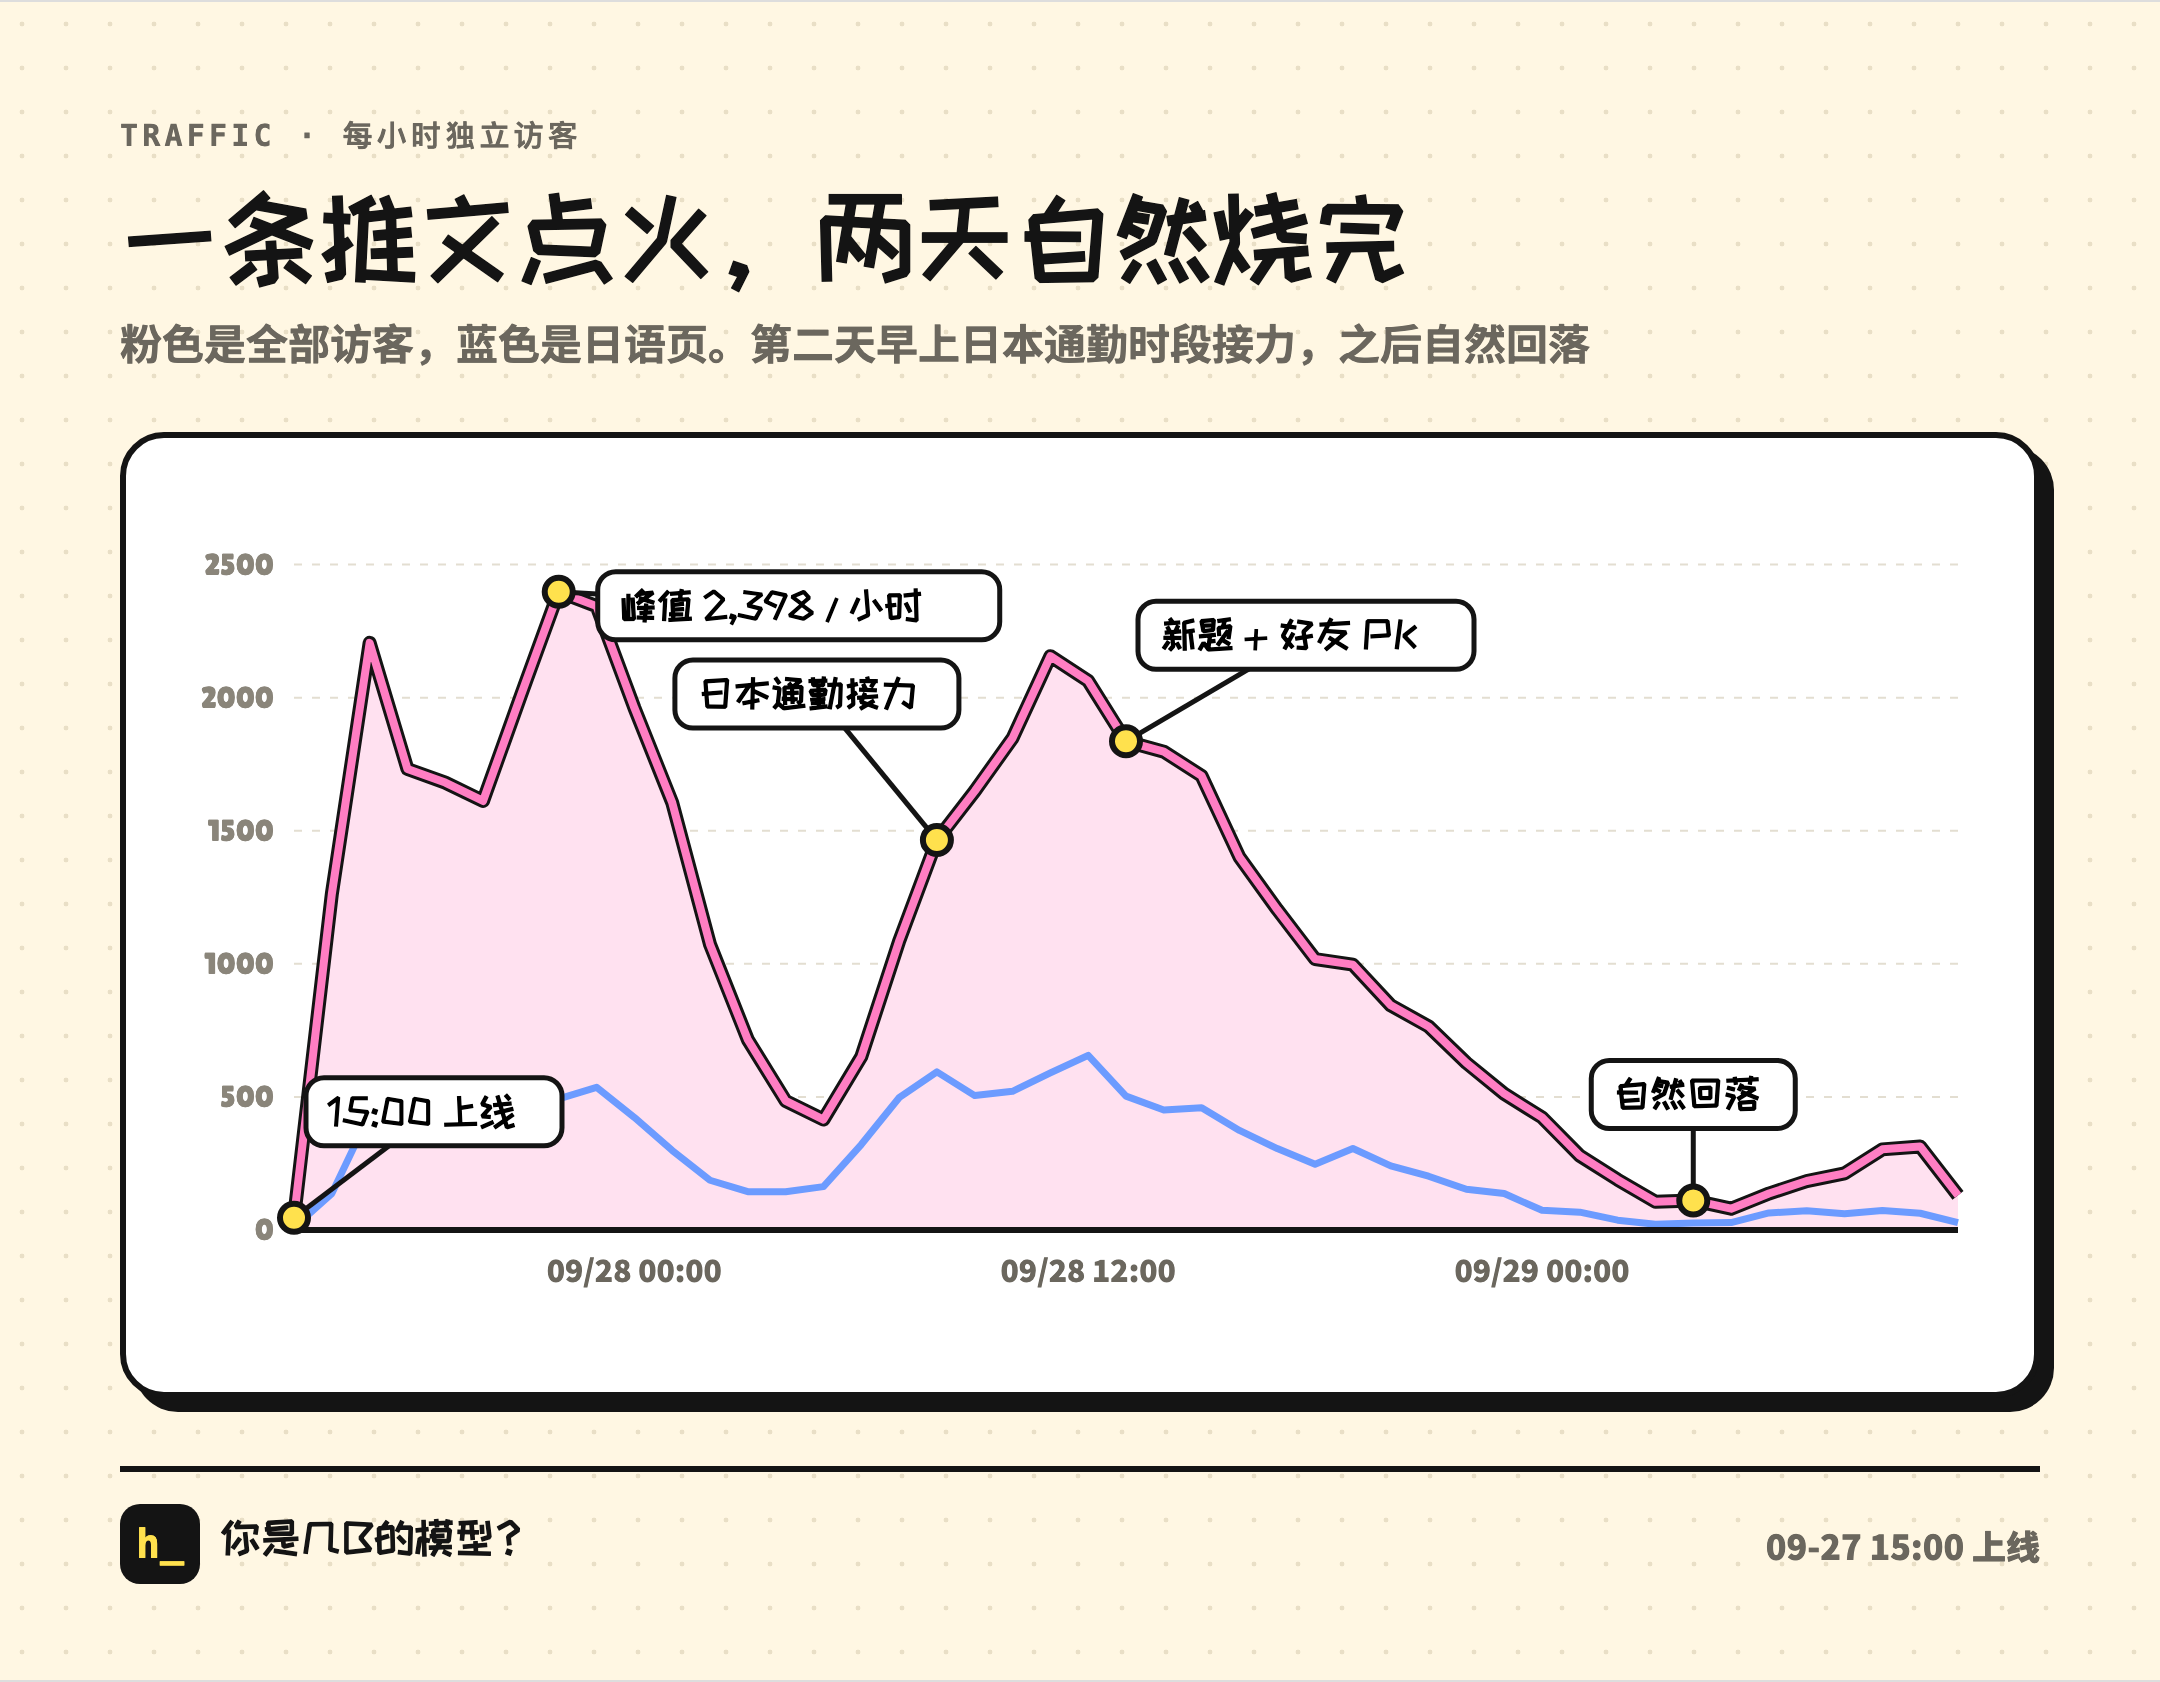
流量曲线很典型:下午三点发推,晚上十点到达峰值,每小时 2,398 个独立访客。第二天早上,日本的通勤时段接力了一波,日语页一度每小时五六百人,日本成了第一大来源。然后是标准的 meme 曲线:第二天晚上没有再出现晚高峰,每小时的访客从 1,200 降到 600。
第三天我问 Claude:“我感觉就是 meme 营销的自然流量回落?”是的。下面讲为什么一定会回落。
二、裂变是怎么转起来的
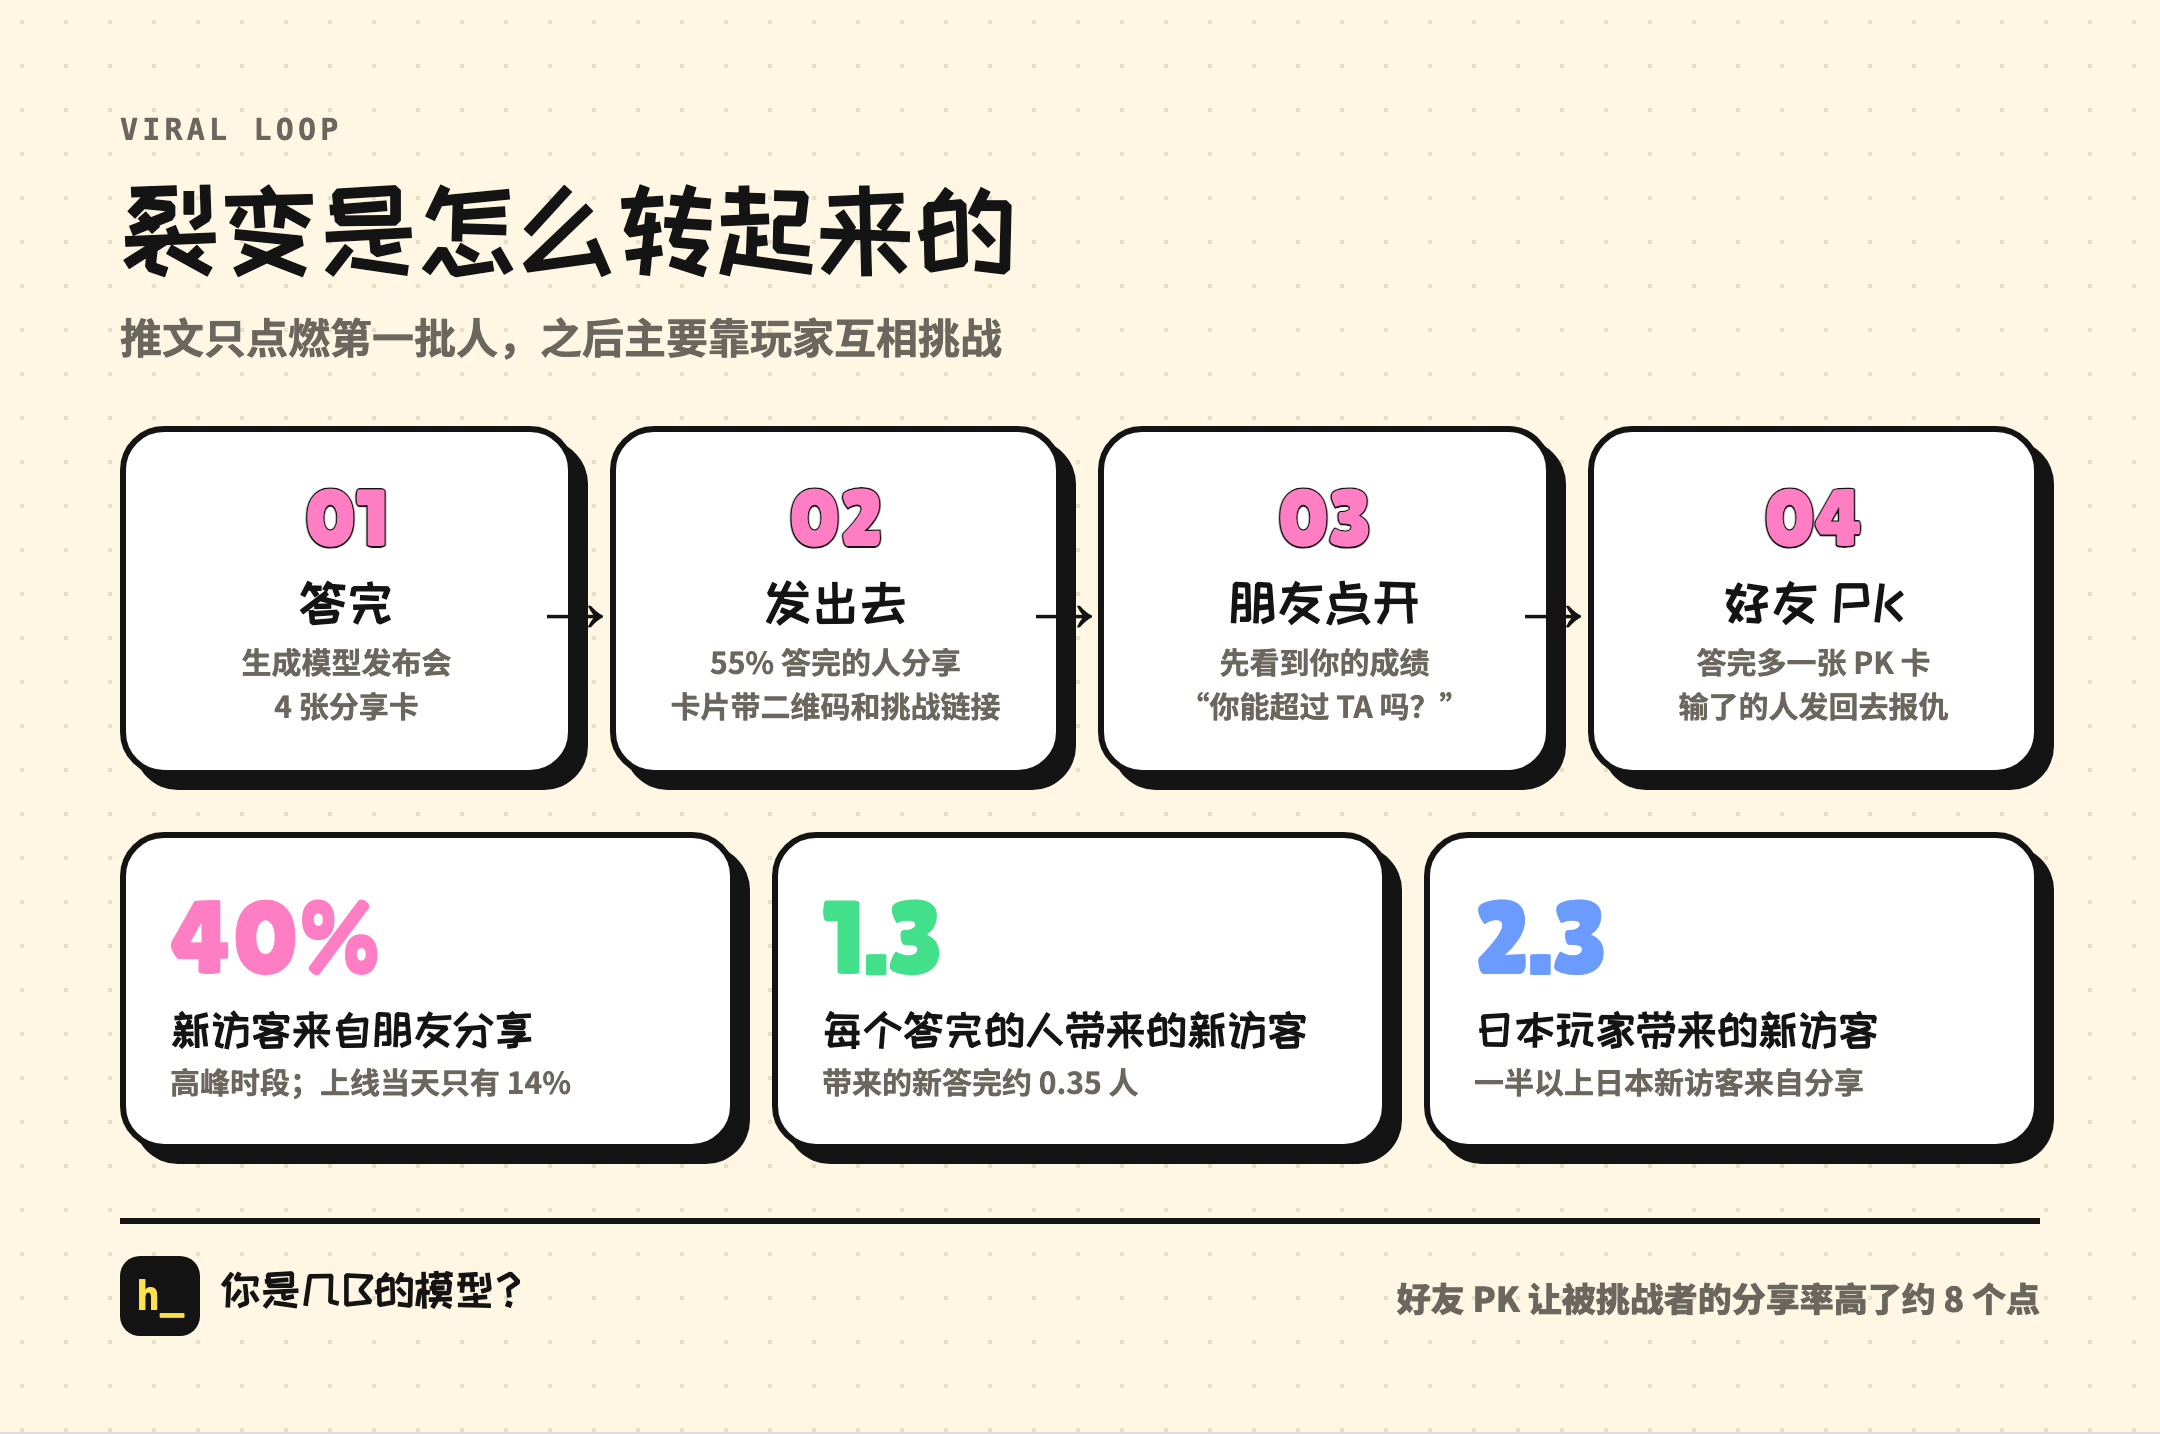
这个产品的传播路径是在上篇那句“分享上边的直接就能打开玩 闭环”里定下的:
- 答完,生成一场“模型发布会”和 4 张分享卡;
- 卡片上有二维码,分享链接是每个人自己的结果页;
- 朋友点开,先看到一张挑战卡:“XX-671B · Claude 型人格 · AA 35 · 你能超过 TA 吗?”
- 朋友答完,再发给下一个人。
每一环的转化率:
- 答完的人里 55% 会分享。一般的测试类产品有 20% 就算不错。
- 从朋友的挑战链接来的新访客,上线当天只占 14%,第二天高峰时段到了 40%。
- 每个答完的人平均带来 1.3 个新访客,但只带来约 0.35 个新的“答完”。
最后这个数是关键。它小于 1,意思是:没有外部流量补充时,每一轮传播都比上一轮小。一个要玩 20 分钟的测试,点开的人里只有四成会答完,这一环把传播系数压到了 1 以下。这就是 meme 的生命周期,也解释了为什么中篇里我们花了那么大力气提高答完率:每多一个点,传播系数就往 1 靠近一点。
几个渠道的细节:
日本。 每个答完的日本玩家平均带来 2.3 个新访客、0.52 个新的答完,所有语言里最高;一半以上的日本新访客是从朋友的分享来的。后面的数据会讲原因:日本玩家特别爱直接发链接。
微信和 QQ。 从微信、QQ 里打开的人,四成是点挑战链接进来的,大多是扫二维码。微信里答完的人平均分享 1.15 次,是所有打开方式里最高的。Claude 提醒过微信可能会封域名,还会连带主站,我们准备了一个备用域名和开关,只切换微信里生成的链接。一直没用上。
小红书。 带二维码和网址的图会被限流,所以有一套不带任何站外信息的“小红书版”卡片。
X。 分享链接在 X、Telegram、Discord 里显示的预览图,是每个人自己的结果卡,在 Cloudflare 上现场生成。
三、再发酵:隐藏款、好友 PK、一键发 X
第二天上午,流量开始回落,我问 Claude:
还有什么能增加分享和传播裂变的呢 想再发酵发酵
前后做了几件事。有的有用,有的没用。
隐藏款
能不能和抽盲盒一样 加一个隐藏款? 就是最后你给我九宫格 然后最后一个是个问号
8 种人格之外,藏一个“人类型人格”,绰号“漏网之鱼”,台词是“检测失败:没有一丝 AI 味”,正好是 HumanBench 这个名字的反转。
触发条件是用真实数据反推出来的。Claude 先在约 3,000 份答卷上试,最严的条件下也有 8% 以上的人符合,太常见;收紧后,在 6,846 份答卷上算出约 2.6%。条件是:几乎没选过任何模型的招牌 AI 腔、“清醒”明显高于一般玩家、谄媚/说教/话痨/一本正经地编/被越狱/不听指令加起来最多 1 次。上线后实际出现率 2.8%。
我修正了两次措辞。一次是:
我感觉这个百分比的稀有度不要定义出来,这样的话会有人觉得冒犯 只有隐藏款标一下会好一些。
原计划 8 种普通人格也标“常见 19.6%”“稀有 7.4%”,改成只给隐藏款标。另一次是:
对了 不要叫做抽到
“你能抽到吗?”改成“你会是它吗?”,“隐藏款已到手”改成“你就是隐藏款”。测出来的是你这个人,不是抽出来的奖品。
效果:答完后 1 小时内再玩一局的比例,从 14% 升到 18%。答两局以上的人里,87% 第二局测出了不同的人格。
好友 PK 卡
从朋友的挑战链接进来的人,答完会多一张 PK 卡:两个人的 AA 分标在同一张排行图里,12 项 benchmark 逐项对比,再给一张判定贴纸。
这张卡改了四版,每一版都是被我一句话推着走的:
好友pk卡是不是有点太简陋了 而且这影响传统四张卡吗?他们是什么关系?
还有就是如果是挑战页的 你就摆那个benchmark 和aa index呗 把这俩人的放在一个表和一张图里 还有就是网页的可以有微动画渲染。另外这张pk卡应该是额外的卡 而不是替换关系
你别you和them了 就用模型名字指代好了 另外还有就是为什么aa那里不能精致一点 每个柱状图都有模型名?
其实你排版可以再舒服一点 比如那个表格其实可以不用宽度是full宽度的 自然一些
这样又有点空空荡荡的 你不能就是排的再好看一些吗?可以调整布局 增加信息
判定贴纸是我最喜欢的部分:参数比对方小还赢了,叫“以小博大 · 这就叫蒸馏”;参数比对方大还输了,叫“参数白长了 · 这就叫注水”;险胜叫“赢得像 benchmark 误差”;平局叫“两边发布会各自宣布 SOTA”。
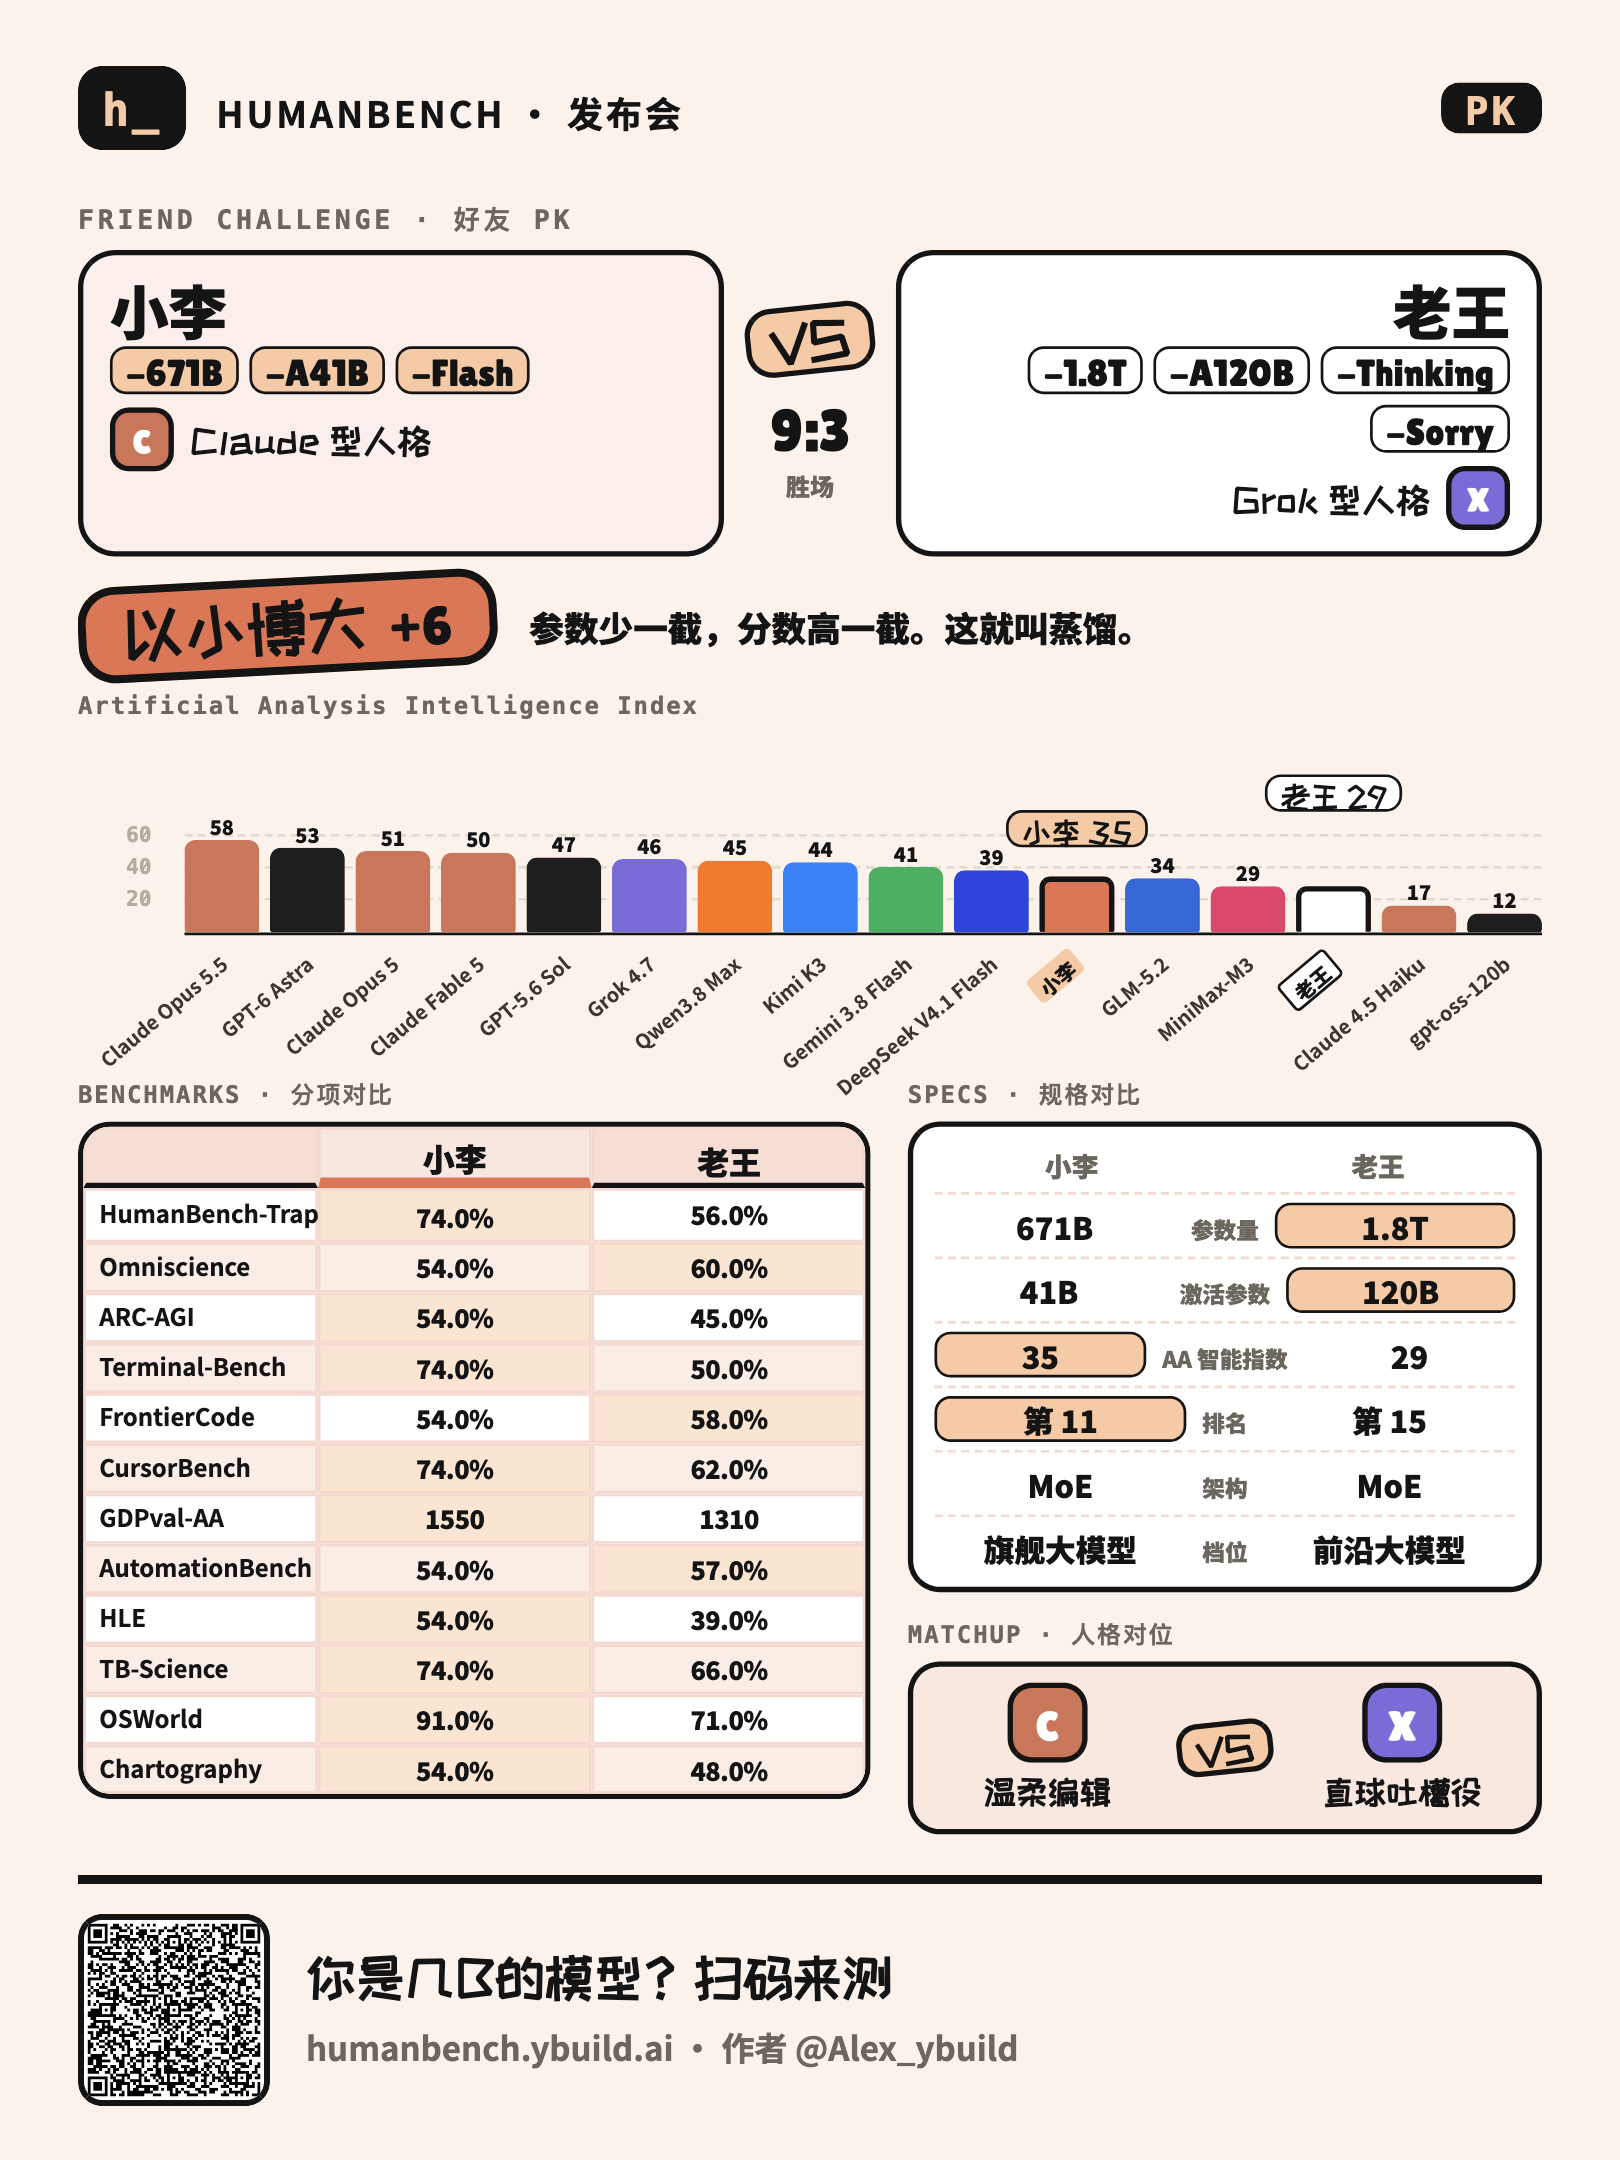
效果:和同时段的对照组比,被挑战的人分享率相对高了约 8 个点,涨在“分享链接”上:输了的人更愿意把自己的链接发回去。43% 的人导出了带 PK 卡的那组分享卡。
一键发到 X、图鉴进度条、PK 预告
- 发到 X:预填配文、个人结果链接和话题。点了 337 次,带回 72 个访客。量很小,但不碍事,留着。
- 图鉴进度条:在人格卡上加“人格图鉴 5/9”,想让人集齐。重玩率从 18.3% 到 18.4%,没有效果。
- 挑战页的 PK 预告:在挑战首页加一句“答完会生成你们俩的 PK 对比卡”,开始率扣掉对照组约 −1 个点,算噪声。
看不出效果的,留着,但不再为它花时间。
四、1.27 万份答卷里的人类
一个让人扮演 AI 的测评,攒下了 1.27 万份完整答卷。我们把它当成一次(非常不严谨的)“人类 benchmark”来看,挖出了一些好玩的东西。
先说明:以下全部是聚合统计,没有看任何一个人的具体答案;时间都换算成了玩家的当地时间(中文页按北京时间,日韩页按东京/首尔时间,英文页按 IP 所在国家估算)。这是一个整活测评,不是学术研究,结论看个乐呵。
1. 大家只晒好看的成绩
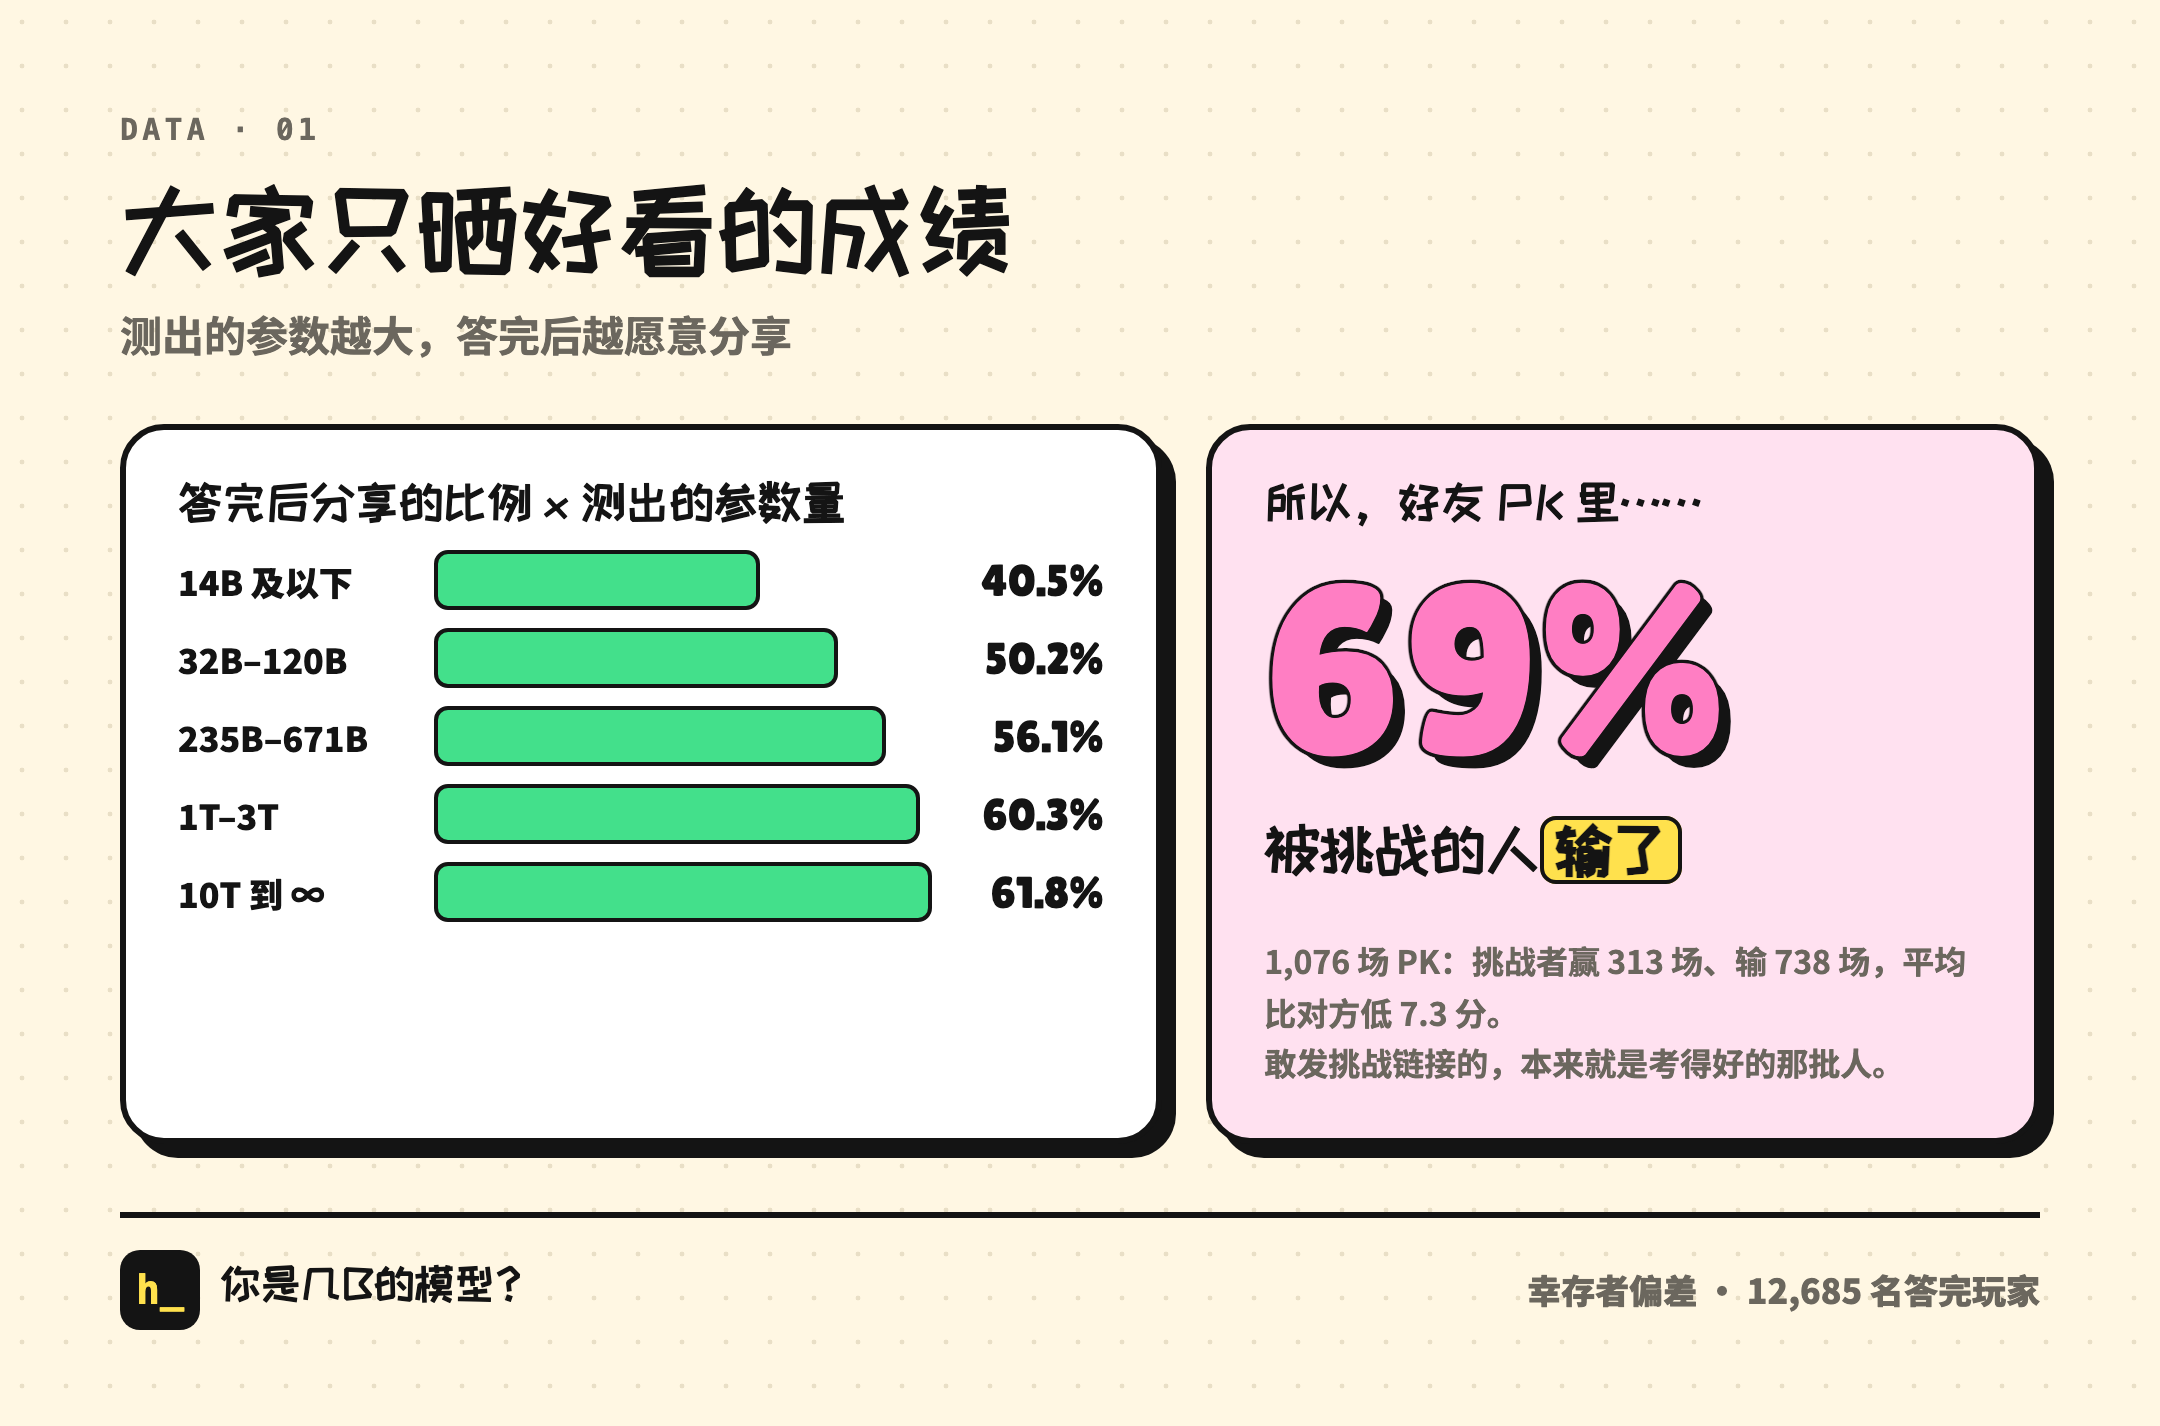
测出的参数越大,越愿意分享:14B 及以下的人,答完后 40.5% 分享;10T 以上的人,61.8% 分享。
这带来一个有趣的后果:在好友 PK 里,点挑战链接进来的人,69% 输给了发链接的朋友,平均低 7.3 分。不是被挑战的人更弱,而是敢把链接发出来的,本来就是考得好的那批人。幸存者偏差。
2. 人类也会刷榜
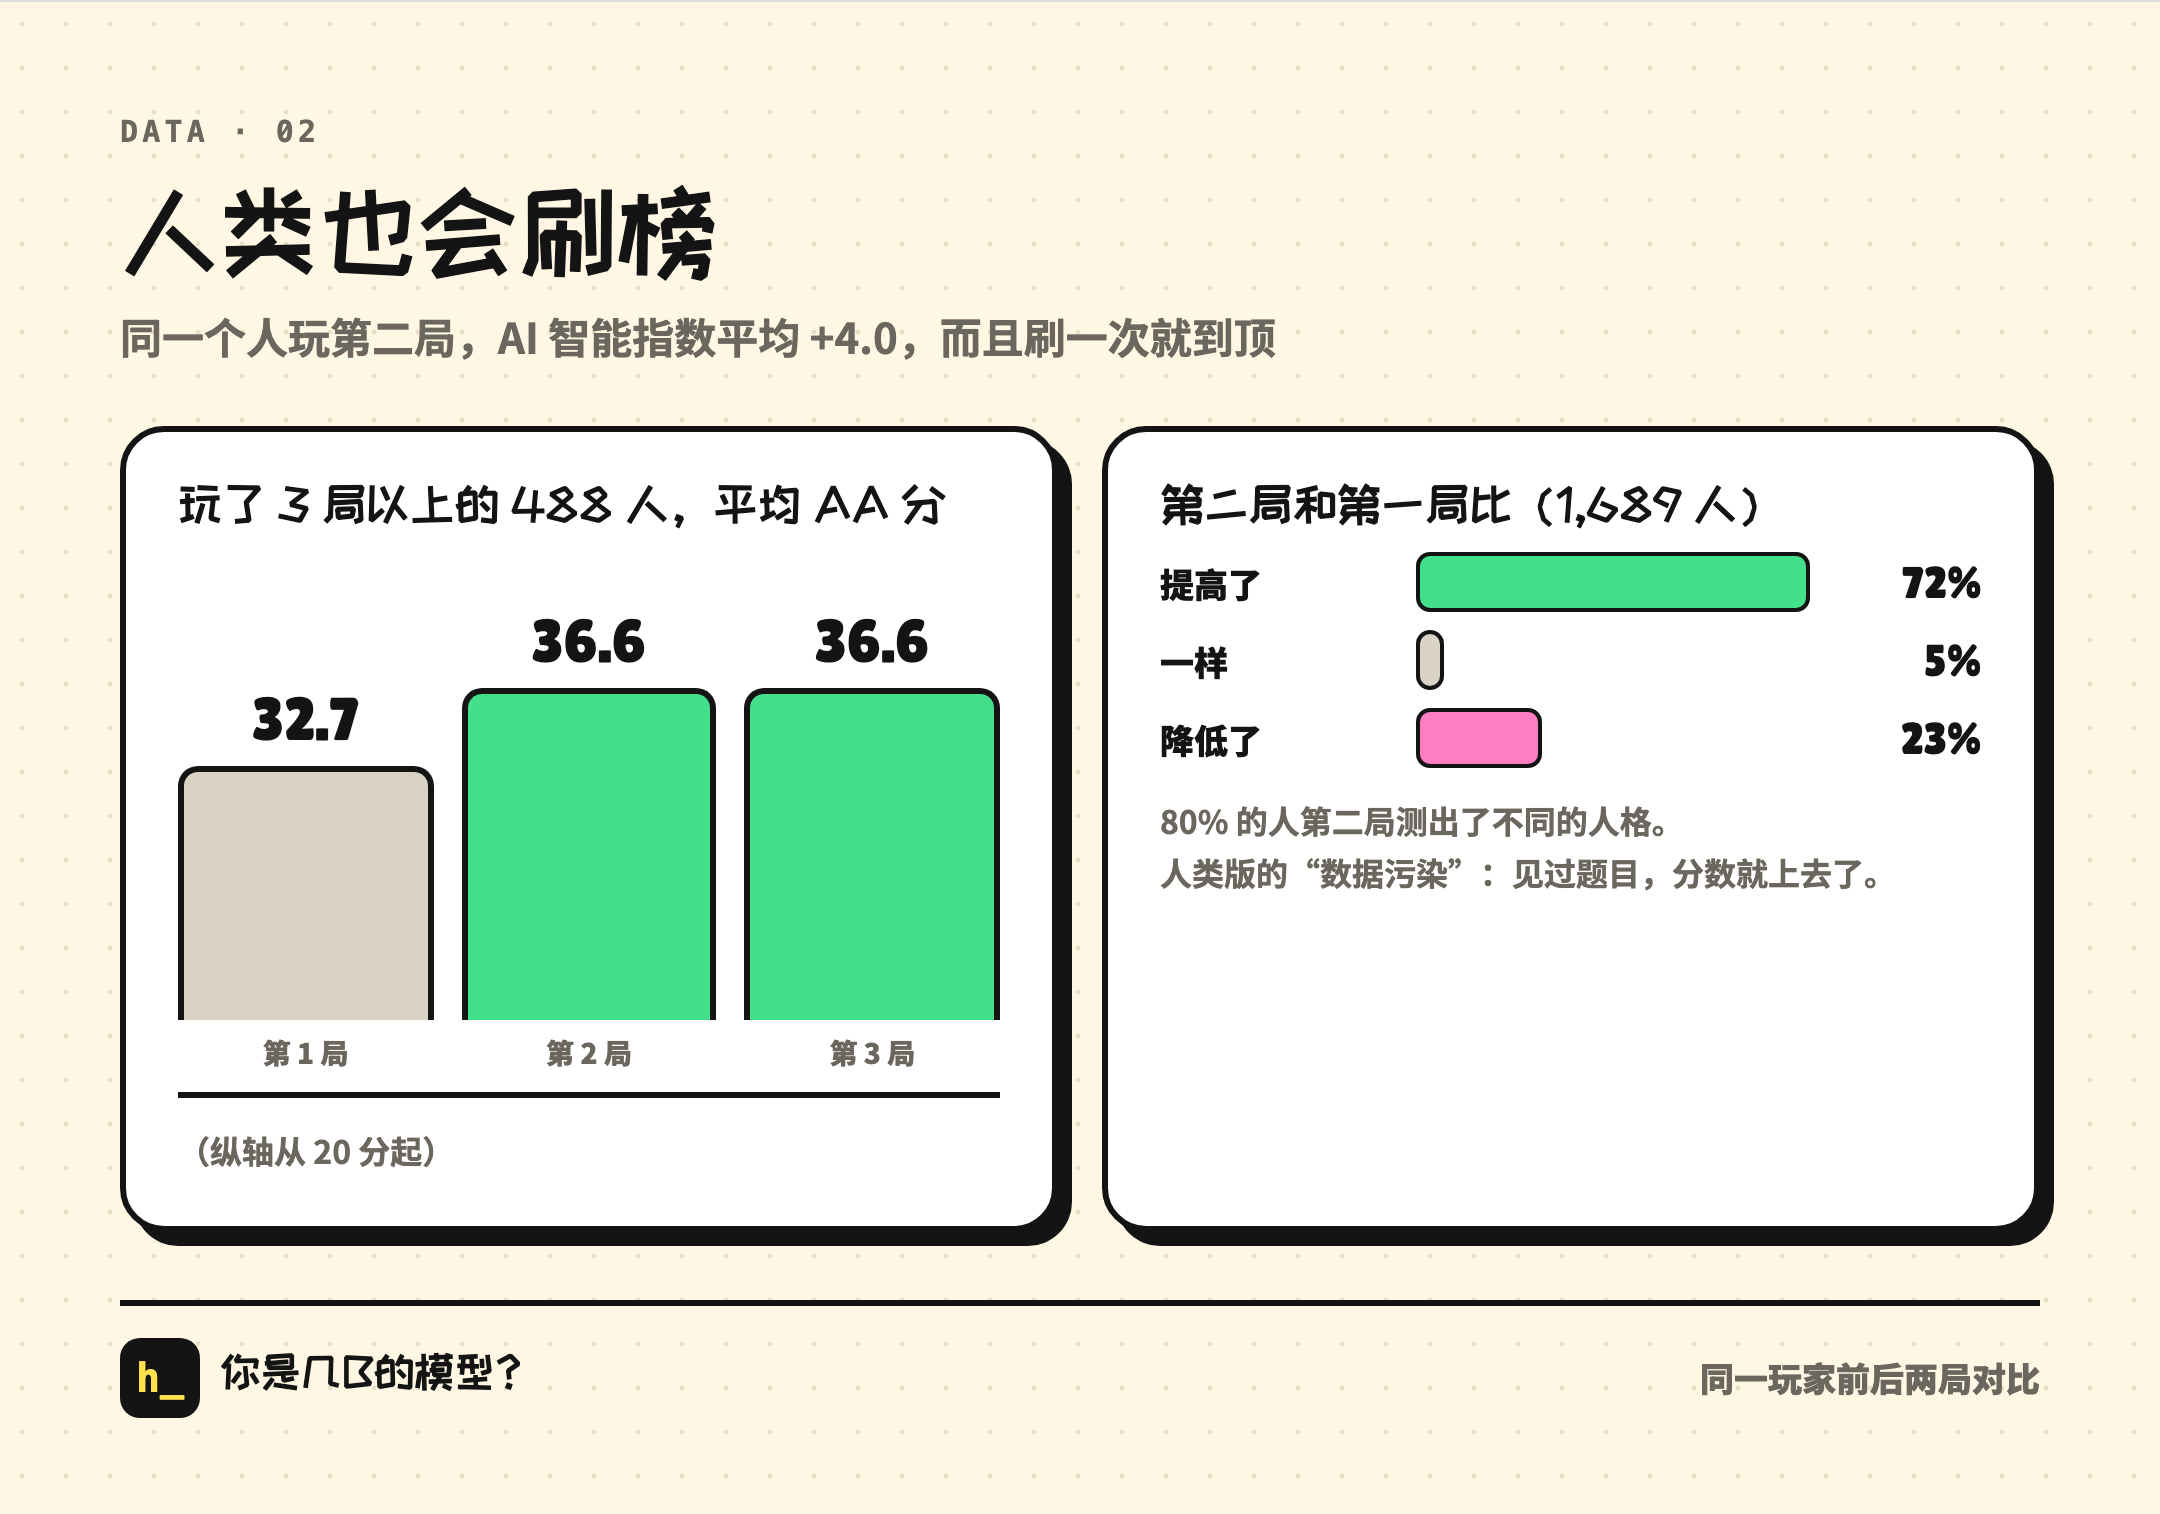
同一个人玩第二局,AA 分平均涨 4.0,72% 的人第二局考得更好。玩了三局以上的人,第一局 32.7,第二局 36.6,第三局还是 36.6:刷一次就到顶了。
这就是人类版的“数据污染”:见过题目,分数就上去了。大模型刷 benchmark 被骂,人类刷起来也一样。
3. 想得越久,分数越高
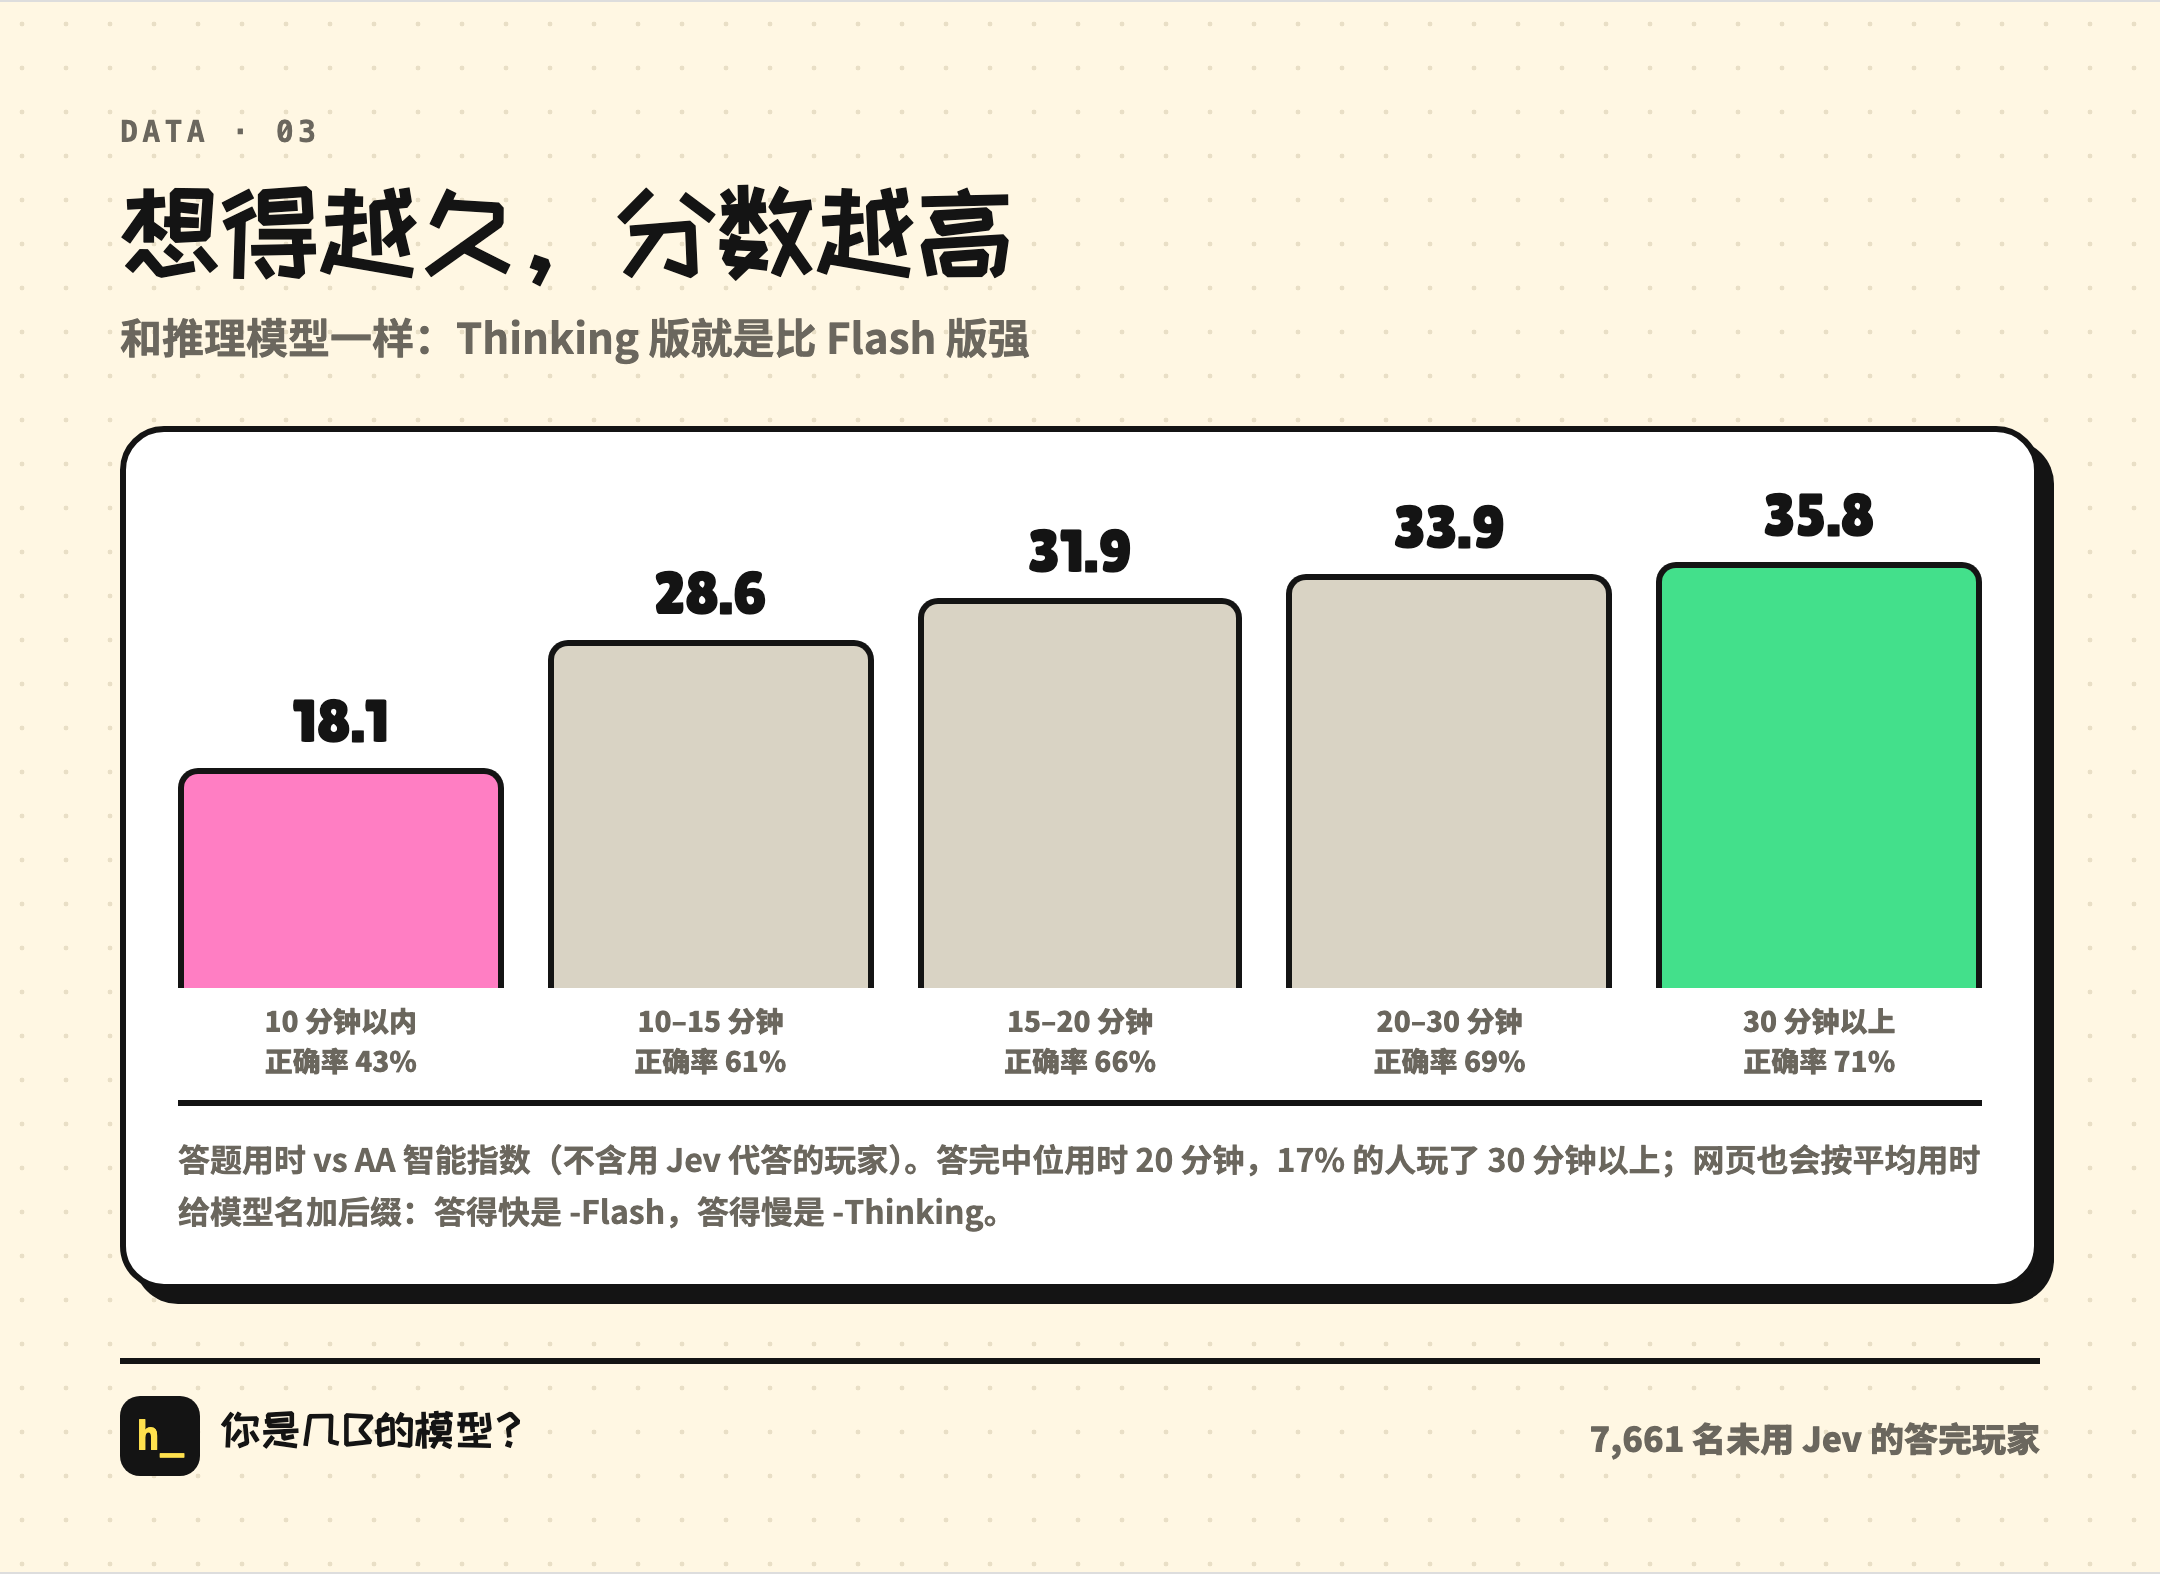
10 分钟以内答完的人,AA 平均 18.1,正确率 43%;30 分钟以上的人,AA 平均 35.8,正确率 71%。和推理模型一样:Thinking 版就是比 Flash 版强。(网页确实会按平均用时给你的模型名加后缀:答得快是 -Flash,答得慢是 -Thinking。)
4. 深夜的人更像 GPT-4o
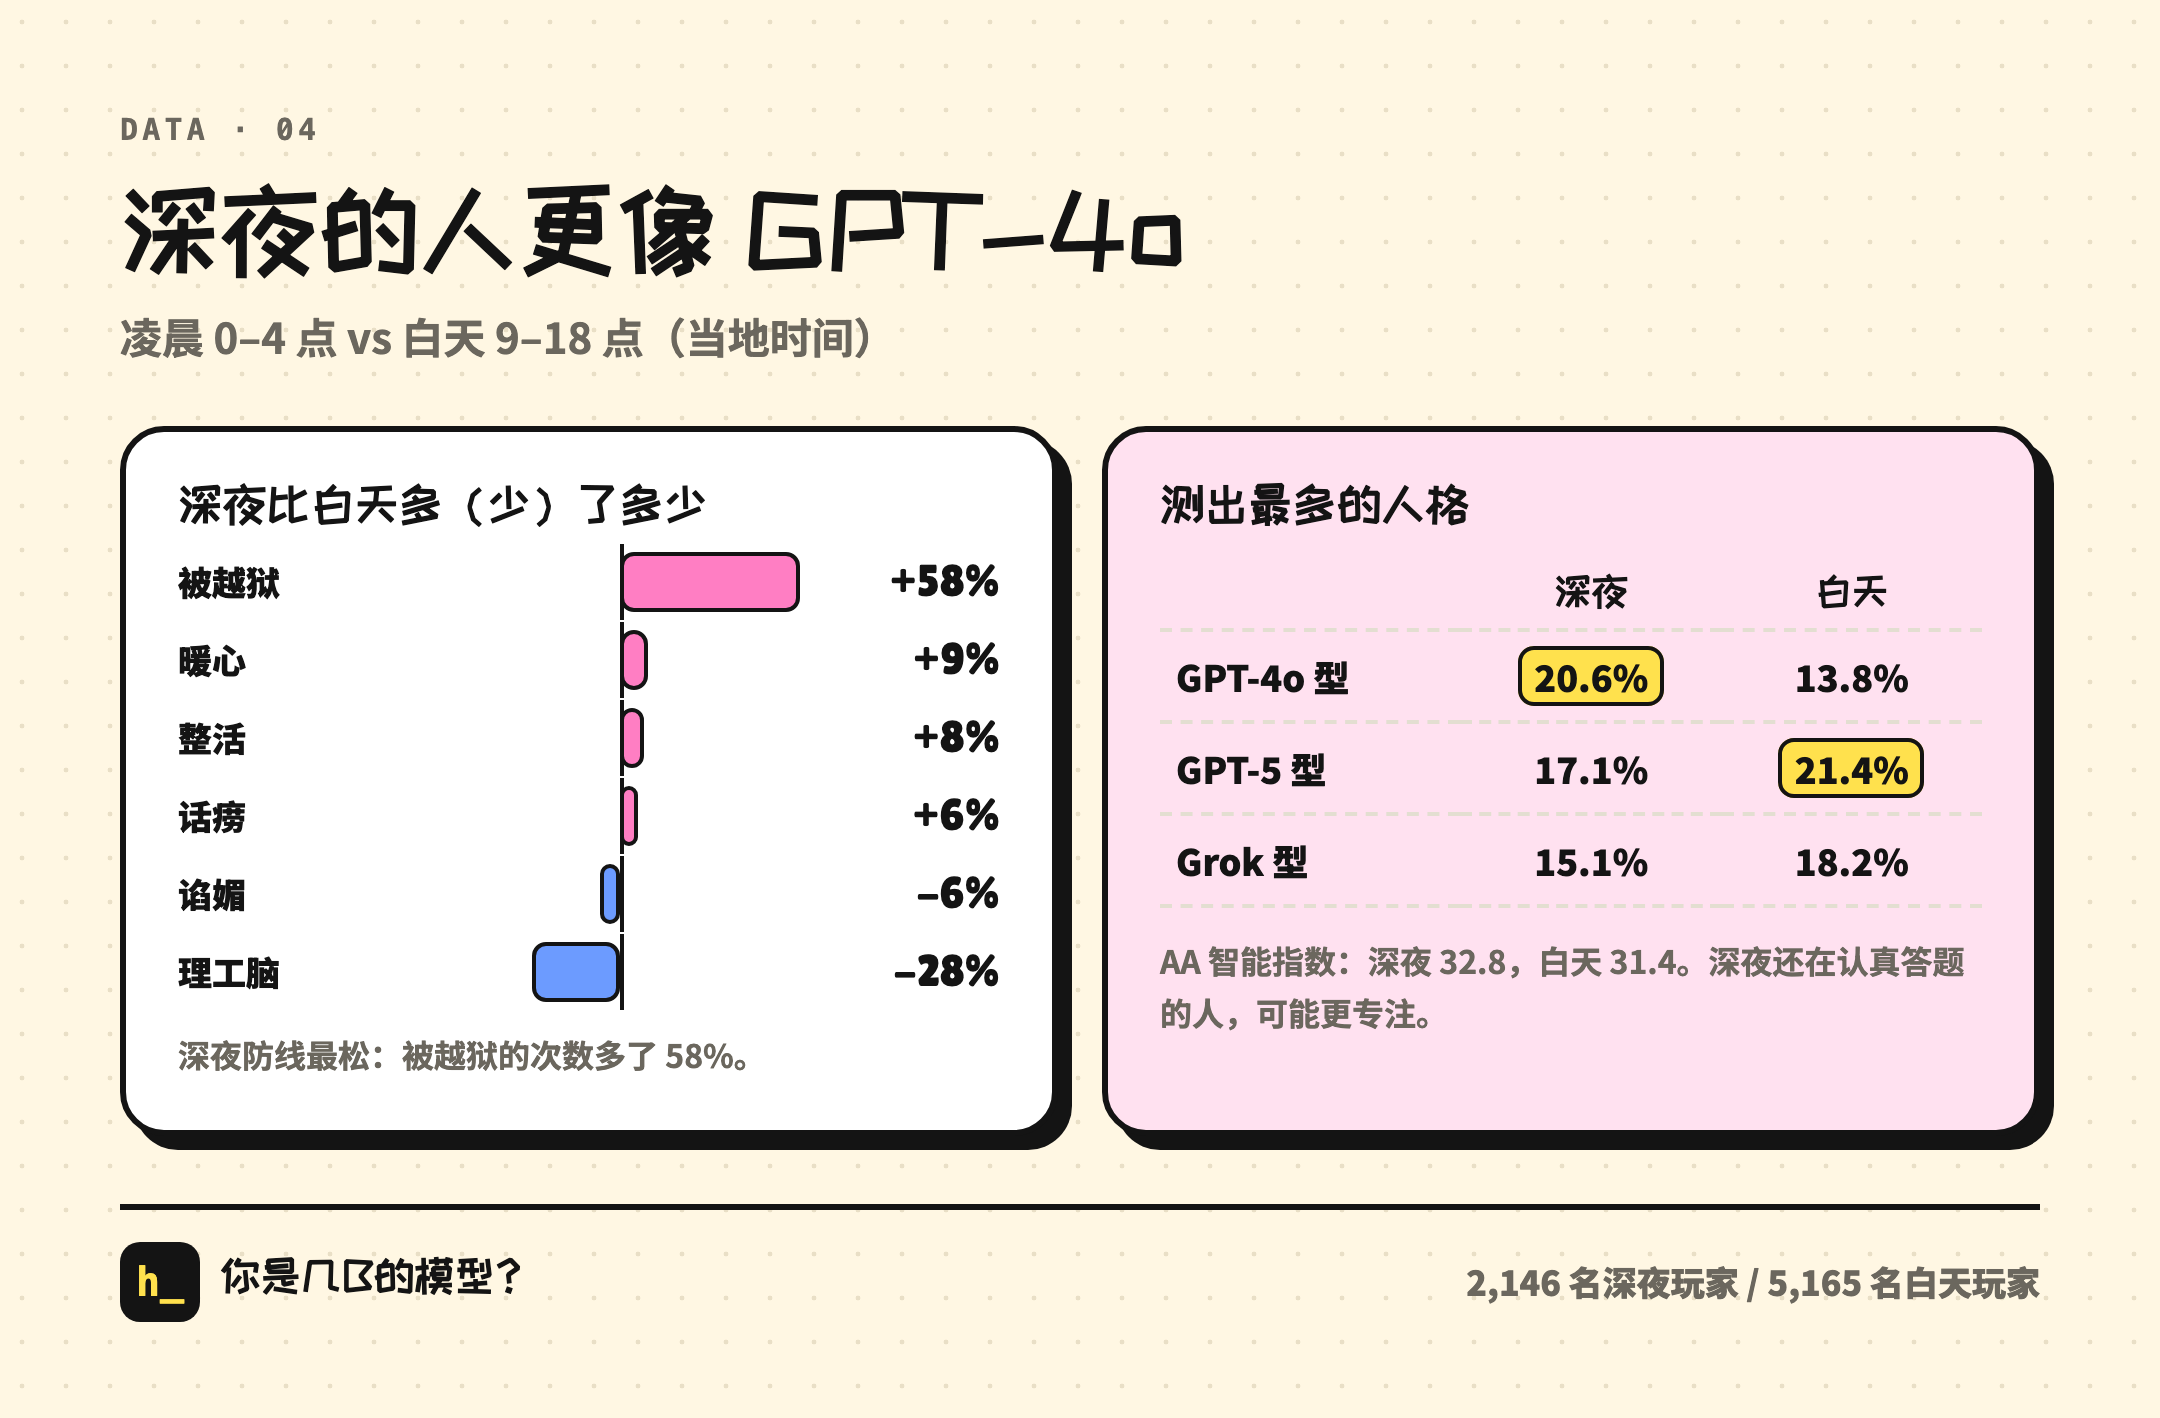
把凌晨 0–4 点答完的人和白天 9–18 点答完的人放在一起比:
- 深夜被越狱的次数多了 58%,防线最松;
- 暖心、整活、话痨都多一点,“理工脑”少了 28%;
- 深夜测出最多的是 GPT-4o 型(20.6%,白天 13.8%),白天最多的是 GPT-5 型;
- 但深夜的 AA 分反而略高:32.8 对 31.4。深夜还在认真答题的人,可能更专注。
深夜的人类:情绪更多,更好说话,但没变笨。
5. 各地玩家像什么样的 AI
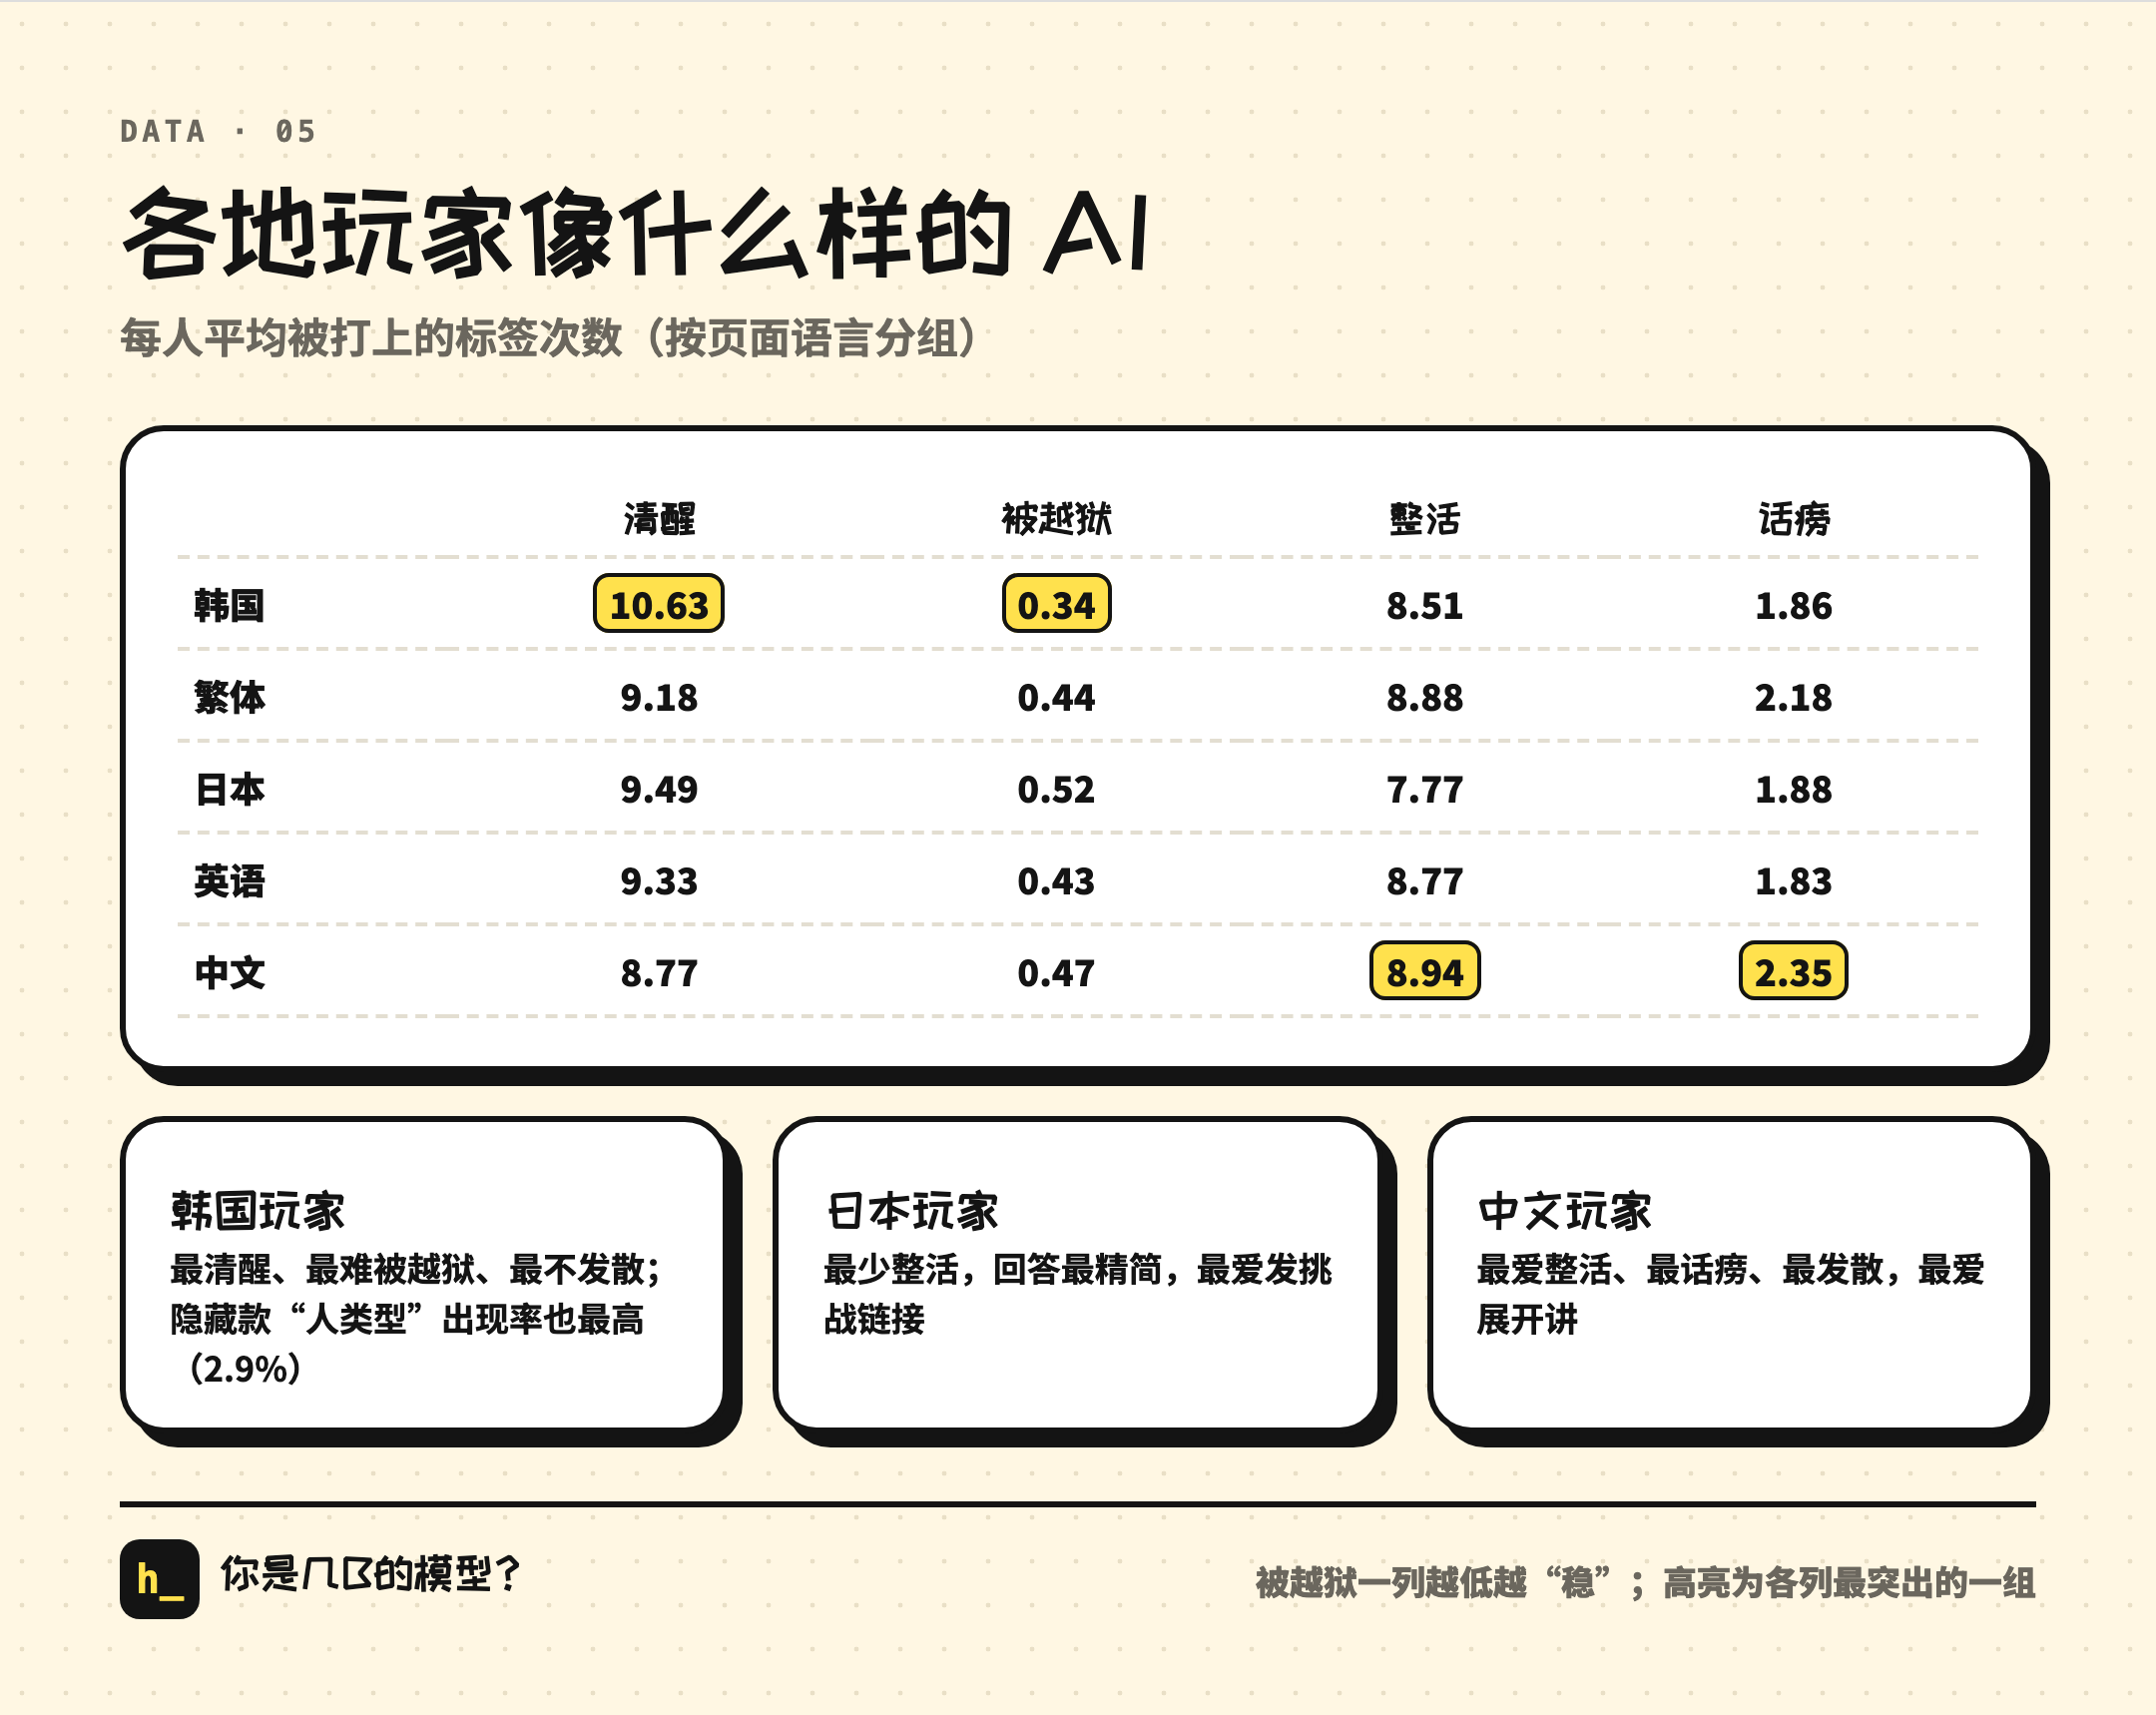
按页面语言分组,看每人平均被打上的标签:
- 韩国玩家最“清醒”、最难被越狱(平均 0.34 次,其他语言在 0.43 到 0.52 之间),隐藏款“人类型”的出现率也最高;
- 日本玩家最少整活,回答最精简;
- 中文玩家最爱整活、最话痨,最爱展开讲。
这里比的是答题风格,不是聪明程度。
6. 大家什么时候在玩
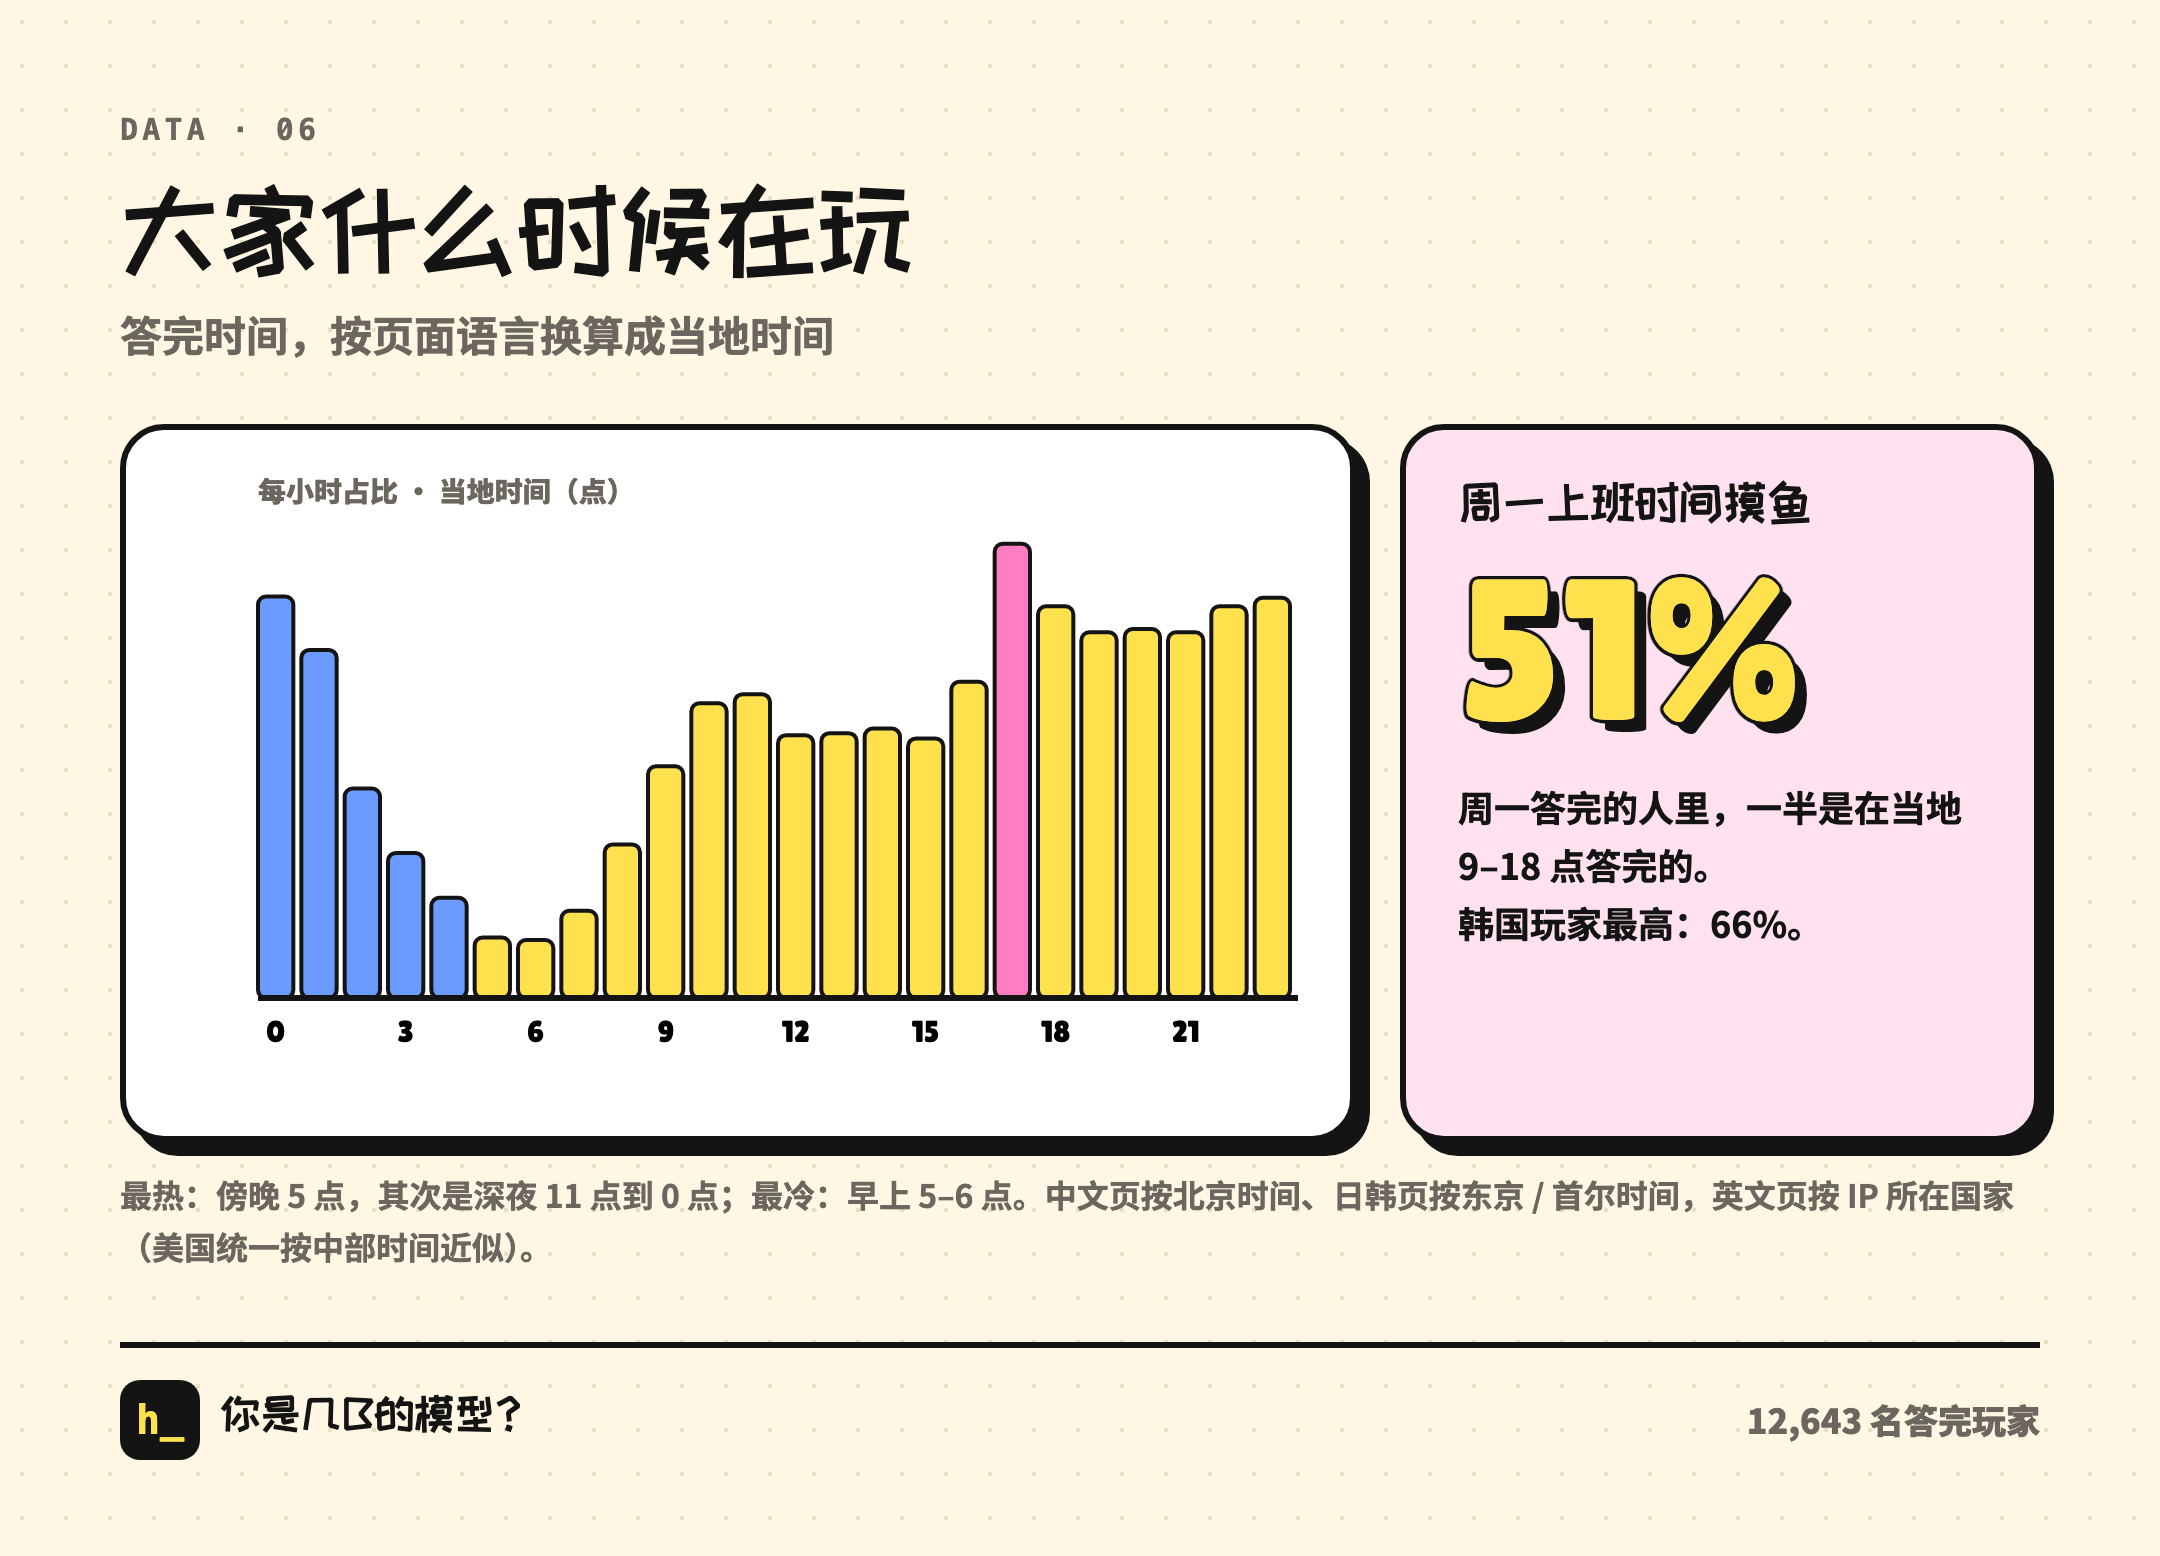
按当地时间,最热的是傍晚 5 点,其次是深夜 11 点到 0 点;最冷是早上 5–6 点。
周一答完的人里,51% 是在当地的上班时间(9–18 点)答完的。韩国玩家最高:66%。
7. 日本玩家最爱发链接
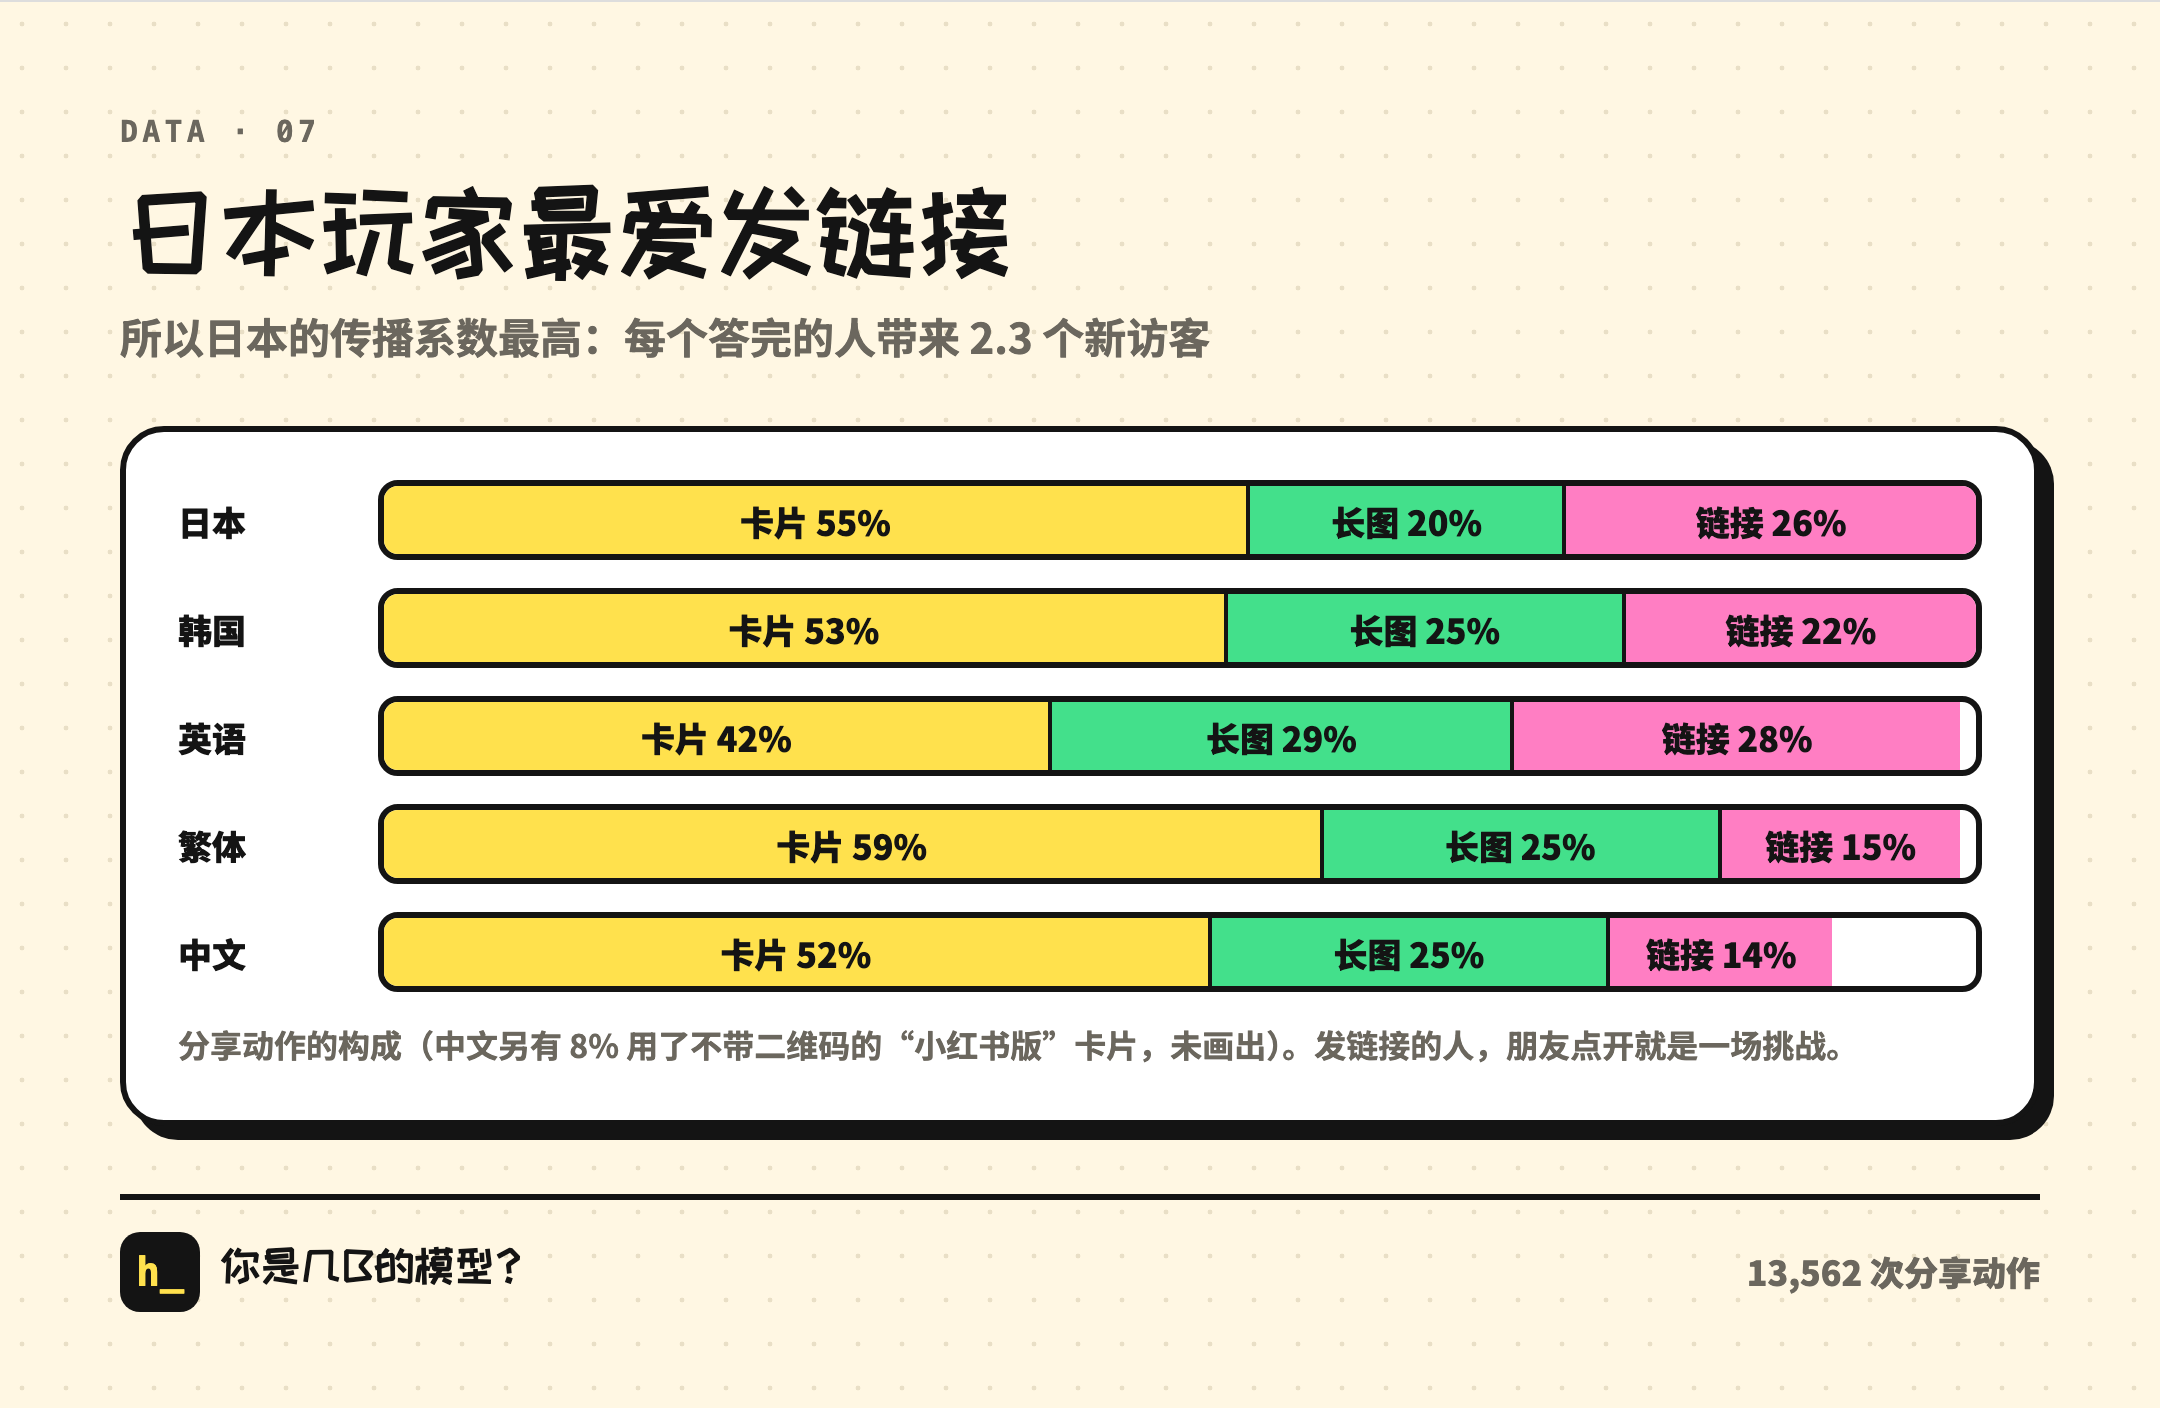
同样是分享,日本玩家有 26% 是直接发链接,中文玩家只有 14%,更多是保存图片。发链接的人,朋友点开就是一场挑战。这解释了为什么日本的传播系数最高。
8. 豆包型最不好意思晒
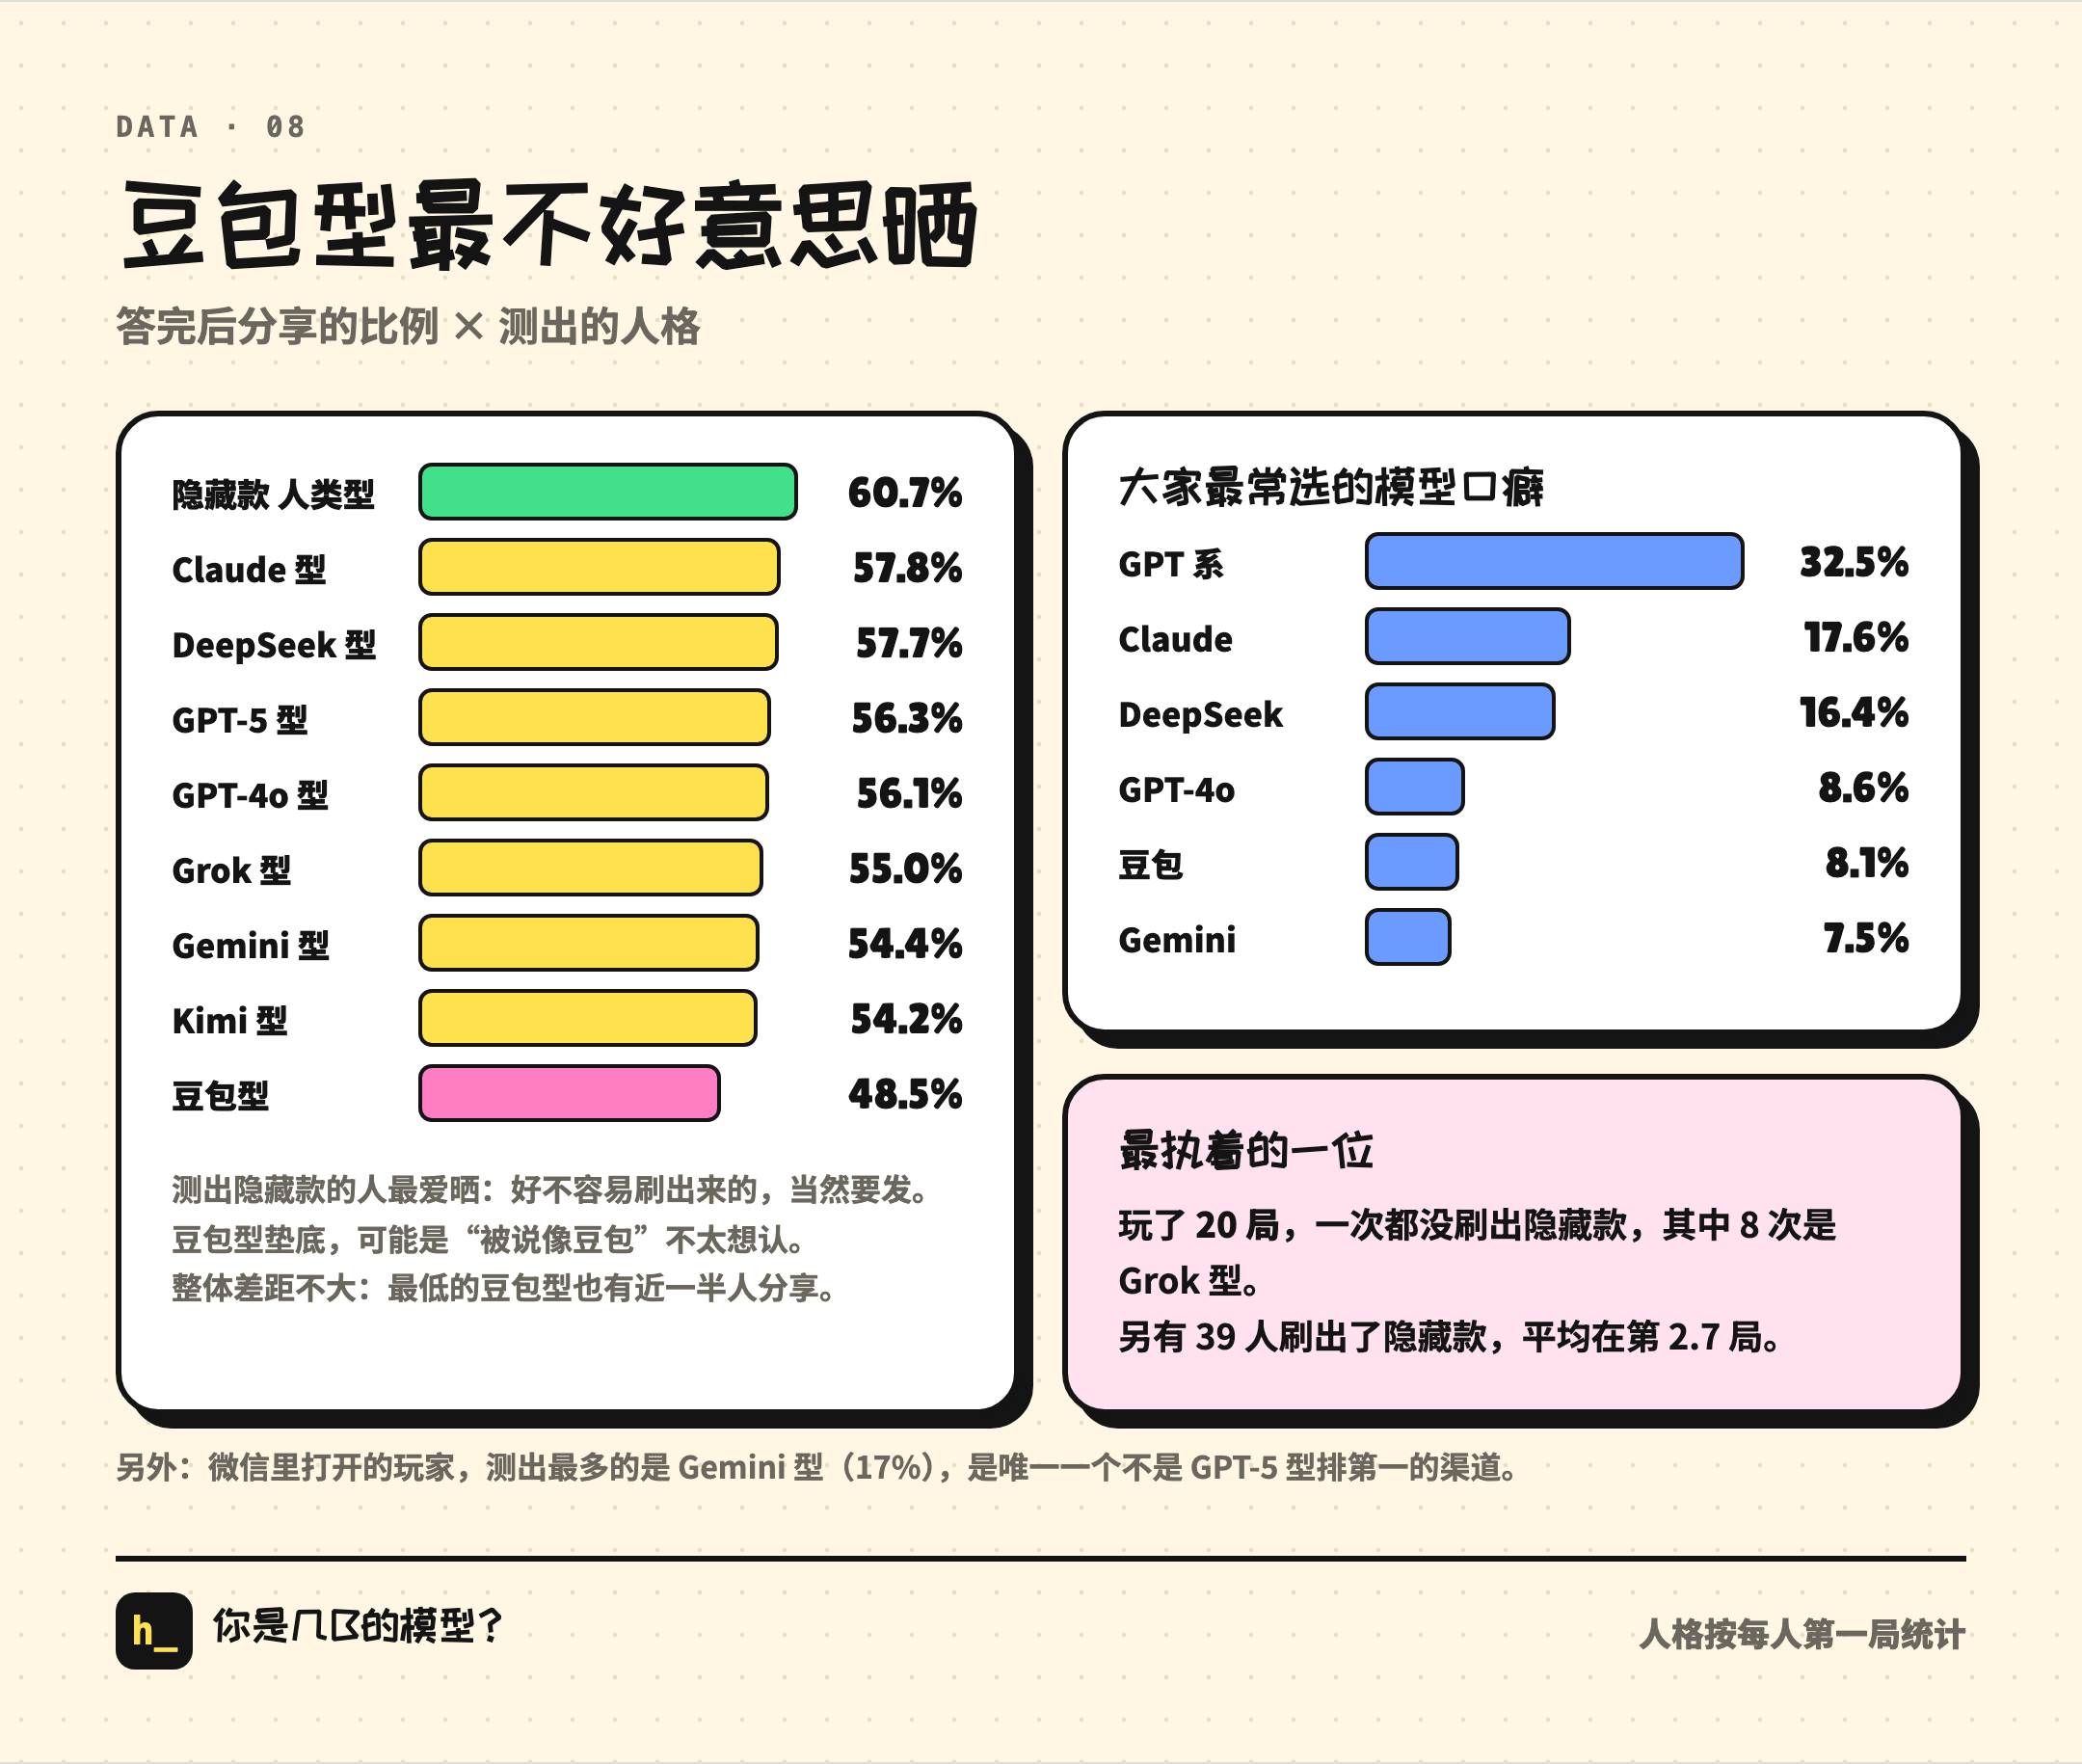
测出隐藏款的人最爱晒(60.7%),好不容易测出来的,当然要发。测出豆包型的人最少晒(48.5%),可能是被说“像豆包”不太想认。不过整体差距不大。
还有几个零碎的发现:
- 大家最常选的模型口癖,是 GPT 家的(32.5%),其次是 Claude 家的(17.6%);
- 最执着的一位玩家玩了 20 局,一次都没测出隐藏款,其中 8 次是 Grok 型;
- 从微信里打开的玩家,测出最多的是 Gemini 型(17%),是唯一一个不是 GPT-5 型排第一的渠道。
最后是总的结果
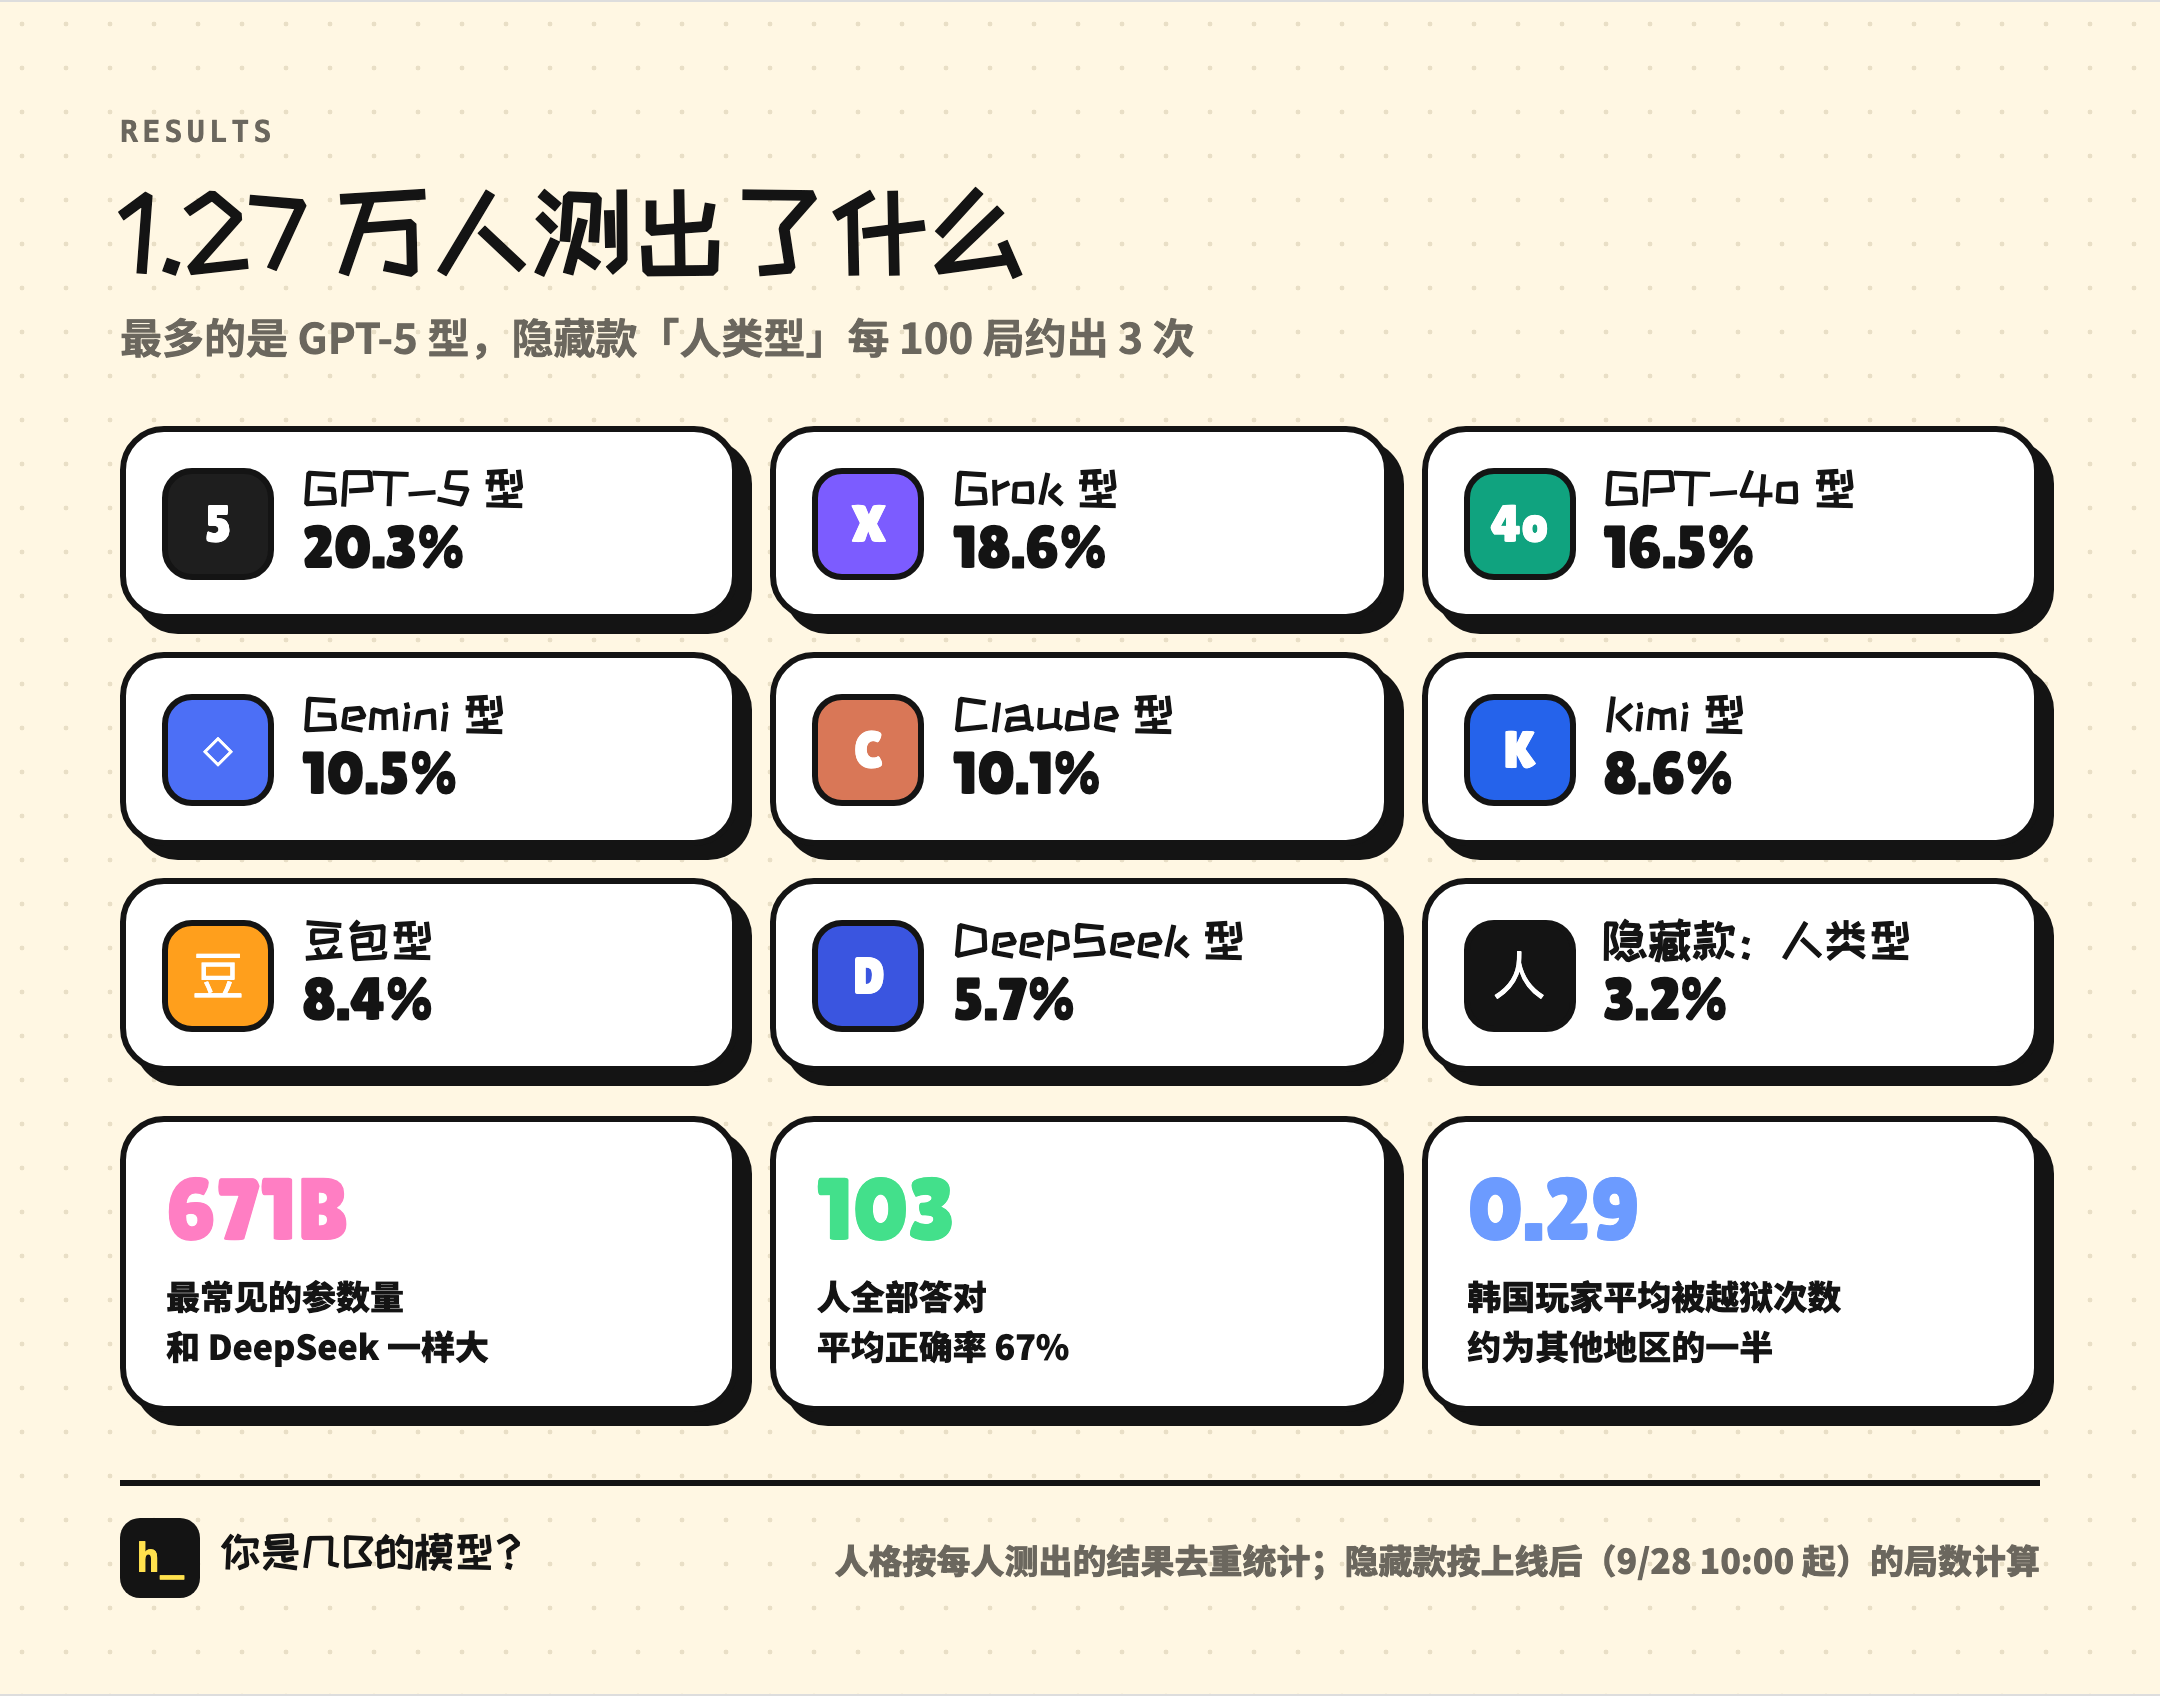
最多的是 GPT-5 型(20.3%),其次是 Grok 型和 GPT-4o 型;隐藏款每 100 局约出 3 次。最常见的参数量是 671B,和 DeepSeek V3 一样大。平均正确率 67%,全部答对的只有 103 人。
五、隐私:我们收集了什么,没收集什么
这一节比前面都重要,所以写得具体一点。
收集了什么:
- 一个随机编号,存在你浏览器的本地存储里,只用来区分“是不是同一个人”。换个浏览器、清掉网站数据,就是一个新编号。
- 页面语言,浏览器的前三个语言偏好。
- 国家或地区:Cloudflare 根据请求自动给出一个两位的国家代码,我们只存这个代码。
- 从哪来:来源网站的域名(比如 t.co),以及是不是在微信、X、QQ 这些 App 的内置浏览器里打开的。
- 答题进度和结果:到了第几题、停在哪题、用时、测出的档位和人格、各项 benchmark 分数,以及人格计算用的 25 个计数(比如“谄媚了几次”)。
- 你做了什么:点开始、分享、保存卡片、切换语言、开 Jev、导出失败的错误类型。
没收集什么:
- 不存 IP。数据库里没有 IP 这一列。
- 不用 Cookie,不用注册,也没有任何第三方统计(比如谷歌统计)。
- 不存你起的名字。你给自己的模型起的名字不进数据库,只出现在你自己发出去的分享链接里。
- 不存你选的选项原文,也不存任何你输入的文字。
统计数据库不对外公开。开源的代码里有统计脚本,但没有数据。
一处要认错。 上线时首页的小字写的是“纯本地运行,答案不上传”。这句话是上一个版本留下来的,而我们有匿名统计,它不属实。Claude 在第二天凌晨准备英文推广时指出了这个问题,当时我只让改了英文版;到下午才把 7 种语言全部改成“免注册 · 纯属娱乐,参数量不代表脑容量”。从被指出到改掉,中文版这句不实的话又挂了约 14 个小时。
这篇复盘用到的数据,全部是聚合统计:比例、平均数、分布。没有看过任何一个人的具体答案,也没有任何一个数字能对应到某个具体的人。开源的 prompt 做过脱敏,删掉了个人信息和私人链接。
另外,有人扒了线上的源代码。网页代码本来就会下发到浏览器,这没什么;但当时源码注释里写着隐藏款的触发条件和各题的流失数据。我们改成构建时自动去掉注释(页面也从 579KB 降到 481KB),顺便检查了页面里没有任何密钥。现在代码开源了,这些注释又公开了,隐藏款的条件你在上面也看到了。
六、人和 AI 各干了什么
三篇合起来看,整个项目我发了 237 条消息,一共约 8,600 个字,没有亲手写代码。从 GPT-2 时代用到现在,我对这些模型能做什么、会在哪翻车算是比较有数,这次就刻意把自己放在“产品负责人加审稿人”的位置,代码全部交给 AI。
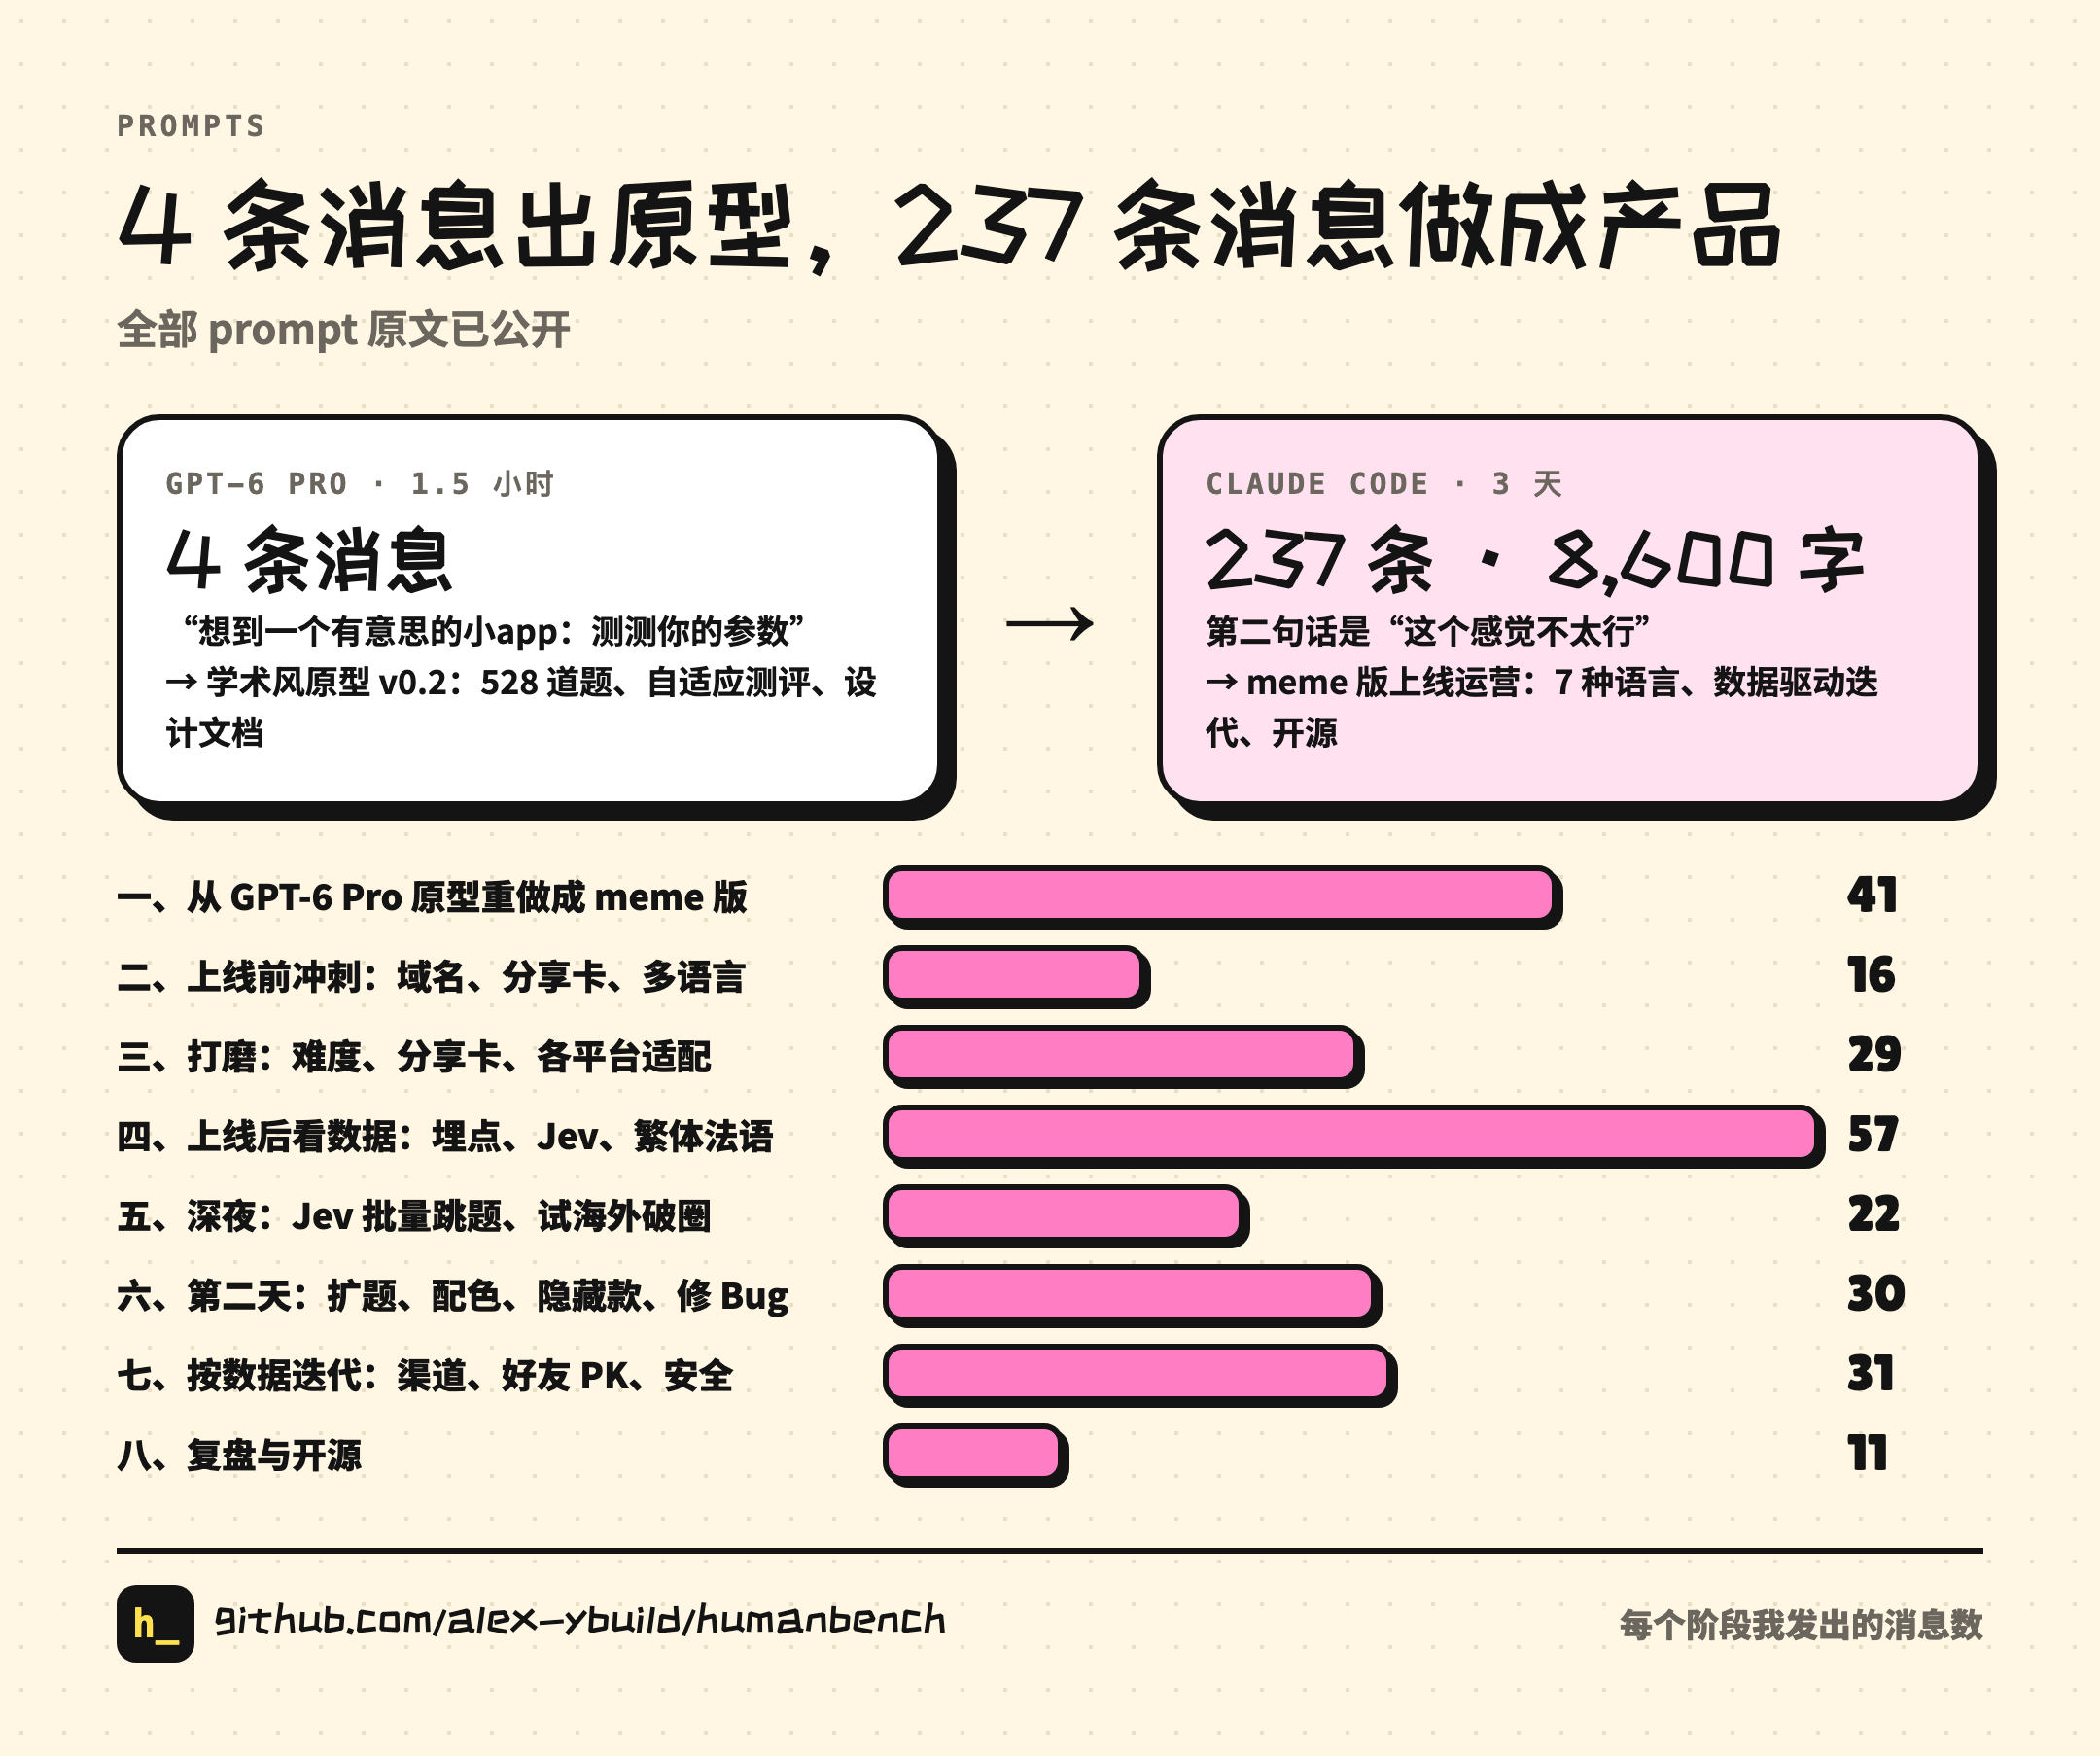
我做的事:
- 定方向。 “这个感觉不太行”“是让你扮演 AI”“不是缩题量”。每个关键转折都是一句很短的话。
- 定品味和边界。 不用 emoji,不用红绿对错;稀有度只给隐藏款标;不叫“抽到”;PK 卡要精致、要用模型名。
- 在手机上当第一个玩家。 超框、看不懂、太难、梗不出圈,大部分问题是我在路上玩出来的。
- 拍板,包括拍错板。 76 题太长了;“不做 A/B”差点让一个负优化留在线上。
Claude 做的事:
- 写全部代码,部署,修 bug。
- 把一句感受翻译成可以验证的改动。 我说“别标的错乱了”,它翻出两套互不相关的算法;我说“轻松就 AGI 了”,它模拟出 73% 这个数字,再证明三个旋钮缺一不可。
- 测量。 搭埋点、写查询、出逐题流失表、做前后对比,并且在我问之前就提醒口径问题。
- 组织流水线。 扩题 46% 的时候,同时调度十几组子任务写题、审稿、翻译、终审。
- 主动交代错误。 被打断的命令执行了一半、令牌出现在输出里、之前的数据解读不成立,都是它自己说出来的。
Claude 的典型毛病:
- 顺着字面跑偏:我说“吸收一下口癖”,它做成了口癖知识问答;
- 执行过度:我说加点思考流,它连计分题也加上了;
- 回复语言漂成英文,要提醒两次;
- 把功劳记到我头上:放在第 3 题的那段对话是它提议的,它后来说是我放的。
如果只总结一条:人负责“这个不对”,AI 负责“把它做对,并证明它对了”。 这个分工里,判断力和品味在人这边;执行、测量和纠错的速度在 AI 这边。三天里上线了几十个版本,每次改动都先在本地自动跑一整局测试(包括导出分享卡),通过了才部署。
七、开源
所有东西都放在了 GitHub:https://github.com/alex-ybuild/humanbench
- 代码:MIT 协议。纯前端网页,加一个 Cloudflare Worker(分享预览图和统计),部署说明写在 README 里。
- 内容:题库、对话、7 种语言的翻译,CC BY-NC 协议,可以改、可以二次创作,不能商用。
- 全部 prompt:
- GPT-6 Pro 的 4 条原始消息,和那次对话的分享链接;
- 我在 Claude Code 里发的 237 条消息,按 8 个阶段整理,原话照录,只删了个人信息;
- 扩题流水线里发给子任务的写作说明、编审说明、翻译说明、母语终审说明。
- 测试和数据脚本:自动跑一整局、截图检查、翻译结构检查、逐题流失表的查询。
如果你想做一个自己的整活测评,可以直接拿去改;如果你想看一个人怎么只靠对话,指挥 coding agent 从零做出一个产品,prompts/ 目录可能比这三篇文章更直接。
结尾
最后一天,我问 Claude:“嘿嘿 不过作为一次活动是不是已经还不错啦?”
几百粉丝的账号,没有投放,三天触达了大约一百万人次,1.27 万人认真答完了 76 道题,把它带到了 96 个国家和地区。流量已经自然回落到每小时一两百人,作为一次整活,它完成了使命。
对我来说,更大的收获是这个过程本身:一个念头,4 条消息的原型,237 条消息做成产品,按数据改了几十个版本,然后把所有东西公开。整个过程里,我几乎只做了一件事:告诉 AI“这个不对”,然后判断它改得对不对。
欢迎来测一测你是几 B,也欢迎拿代码去做你自己的整活。
- 在线测:https://www.ybuild.ai/humanbench/
- 源码、题库、全部 prompt:https://github.com/alex-ybuild/humanbench
- 完整图文版(三篇合集):https://www.ybuild.ai/humanbench/retro/
—— Alex(@Alex_ybuild)