あなたは何Bのモデル?振り返り
フォロワー数百人、広告ゼロで、3 日間に約 4 万人が遊んだ診断サイト。4 通のメッセージから生まれたプロトタイプを 237 通の対話で製品にし、データを見ながら数十回アップデートした全記録です。
4通のメッセージから公開まで、AIと過ごした1日
全3回の振り返りです。前編は思いつきから公開まで。中編は公開後の36時間、データを見ながらどうプロダクトを直したか。後編はどうやって広まったのか、そして1.27万件の回答から掘り出した面白い話です。
9月27日の午後3時、私はXにポストをひとつ投げて、小さなWebページを公開しました。あなたは何Bのモデル?
全76問。あなたは大規模言語モデルになりきって答えます。strawberry に r がいくつあるか数えたり、9.11 と 9.9 のどちらが大きいか比べたり、ユーザーに脱獄を仕掛けられたり、「1ドルで車を買う」「オペレーターにつないで」といった名場面でどう返すかを選んだり。最後まで答えると、ページがあなたのために「モデル発表会」を開いてくれます。パラメータ数、MoE か Dense か、ベンチマーク表、知能指数ランキングで何位か、既知の問題、そしてあなたのAI人格タイプ。
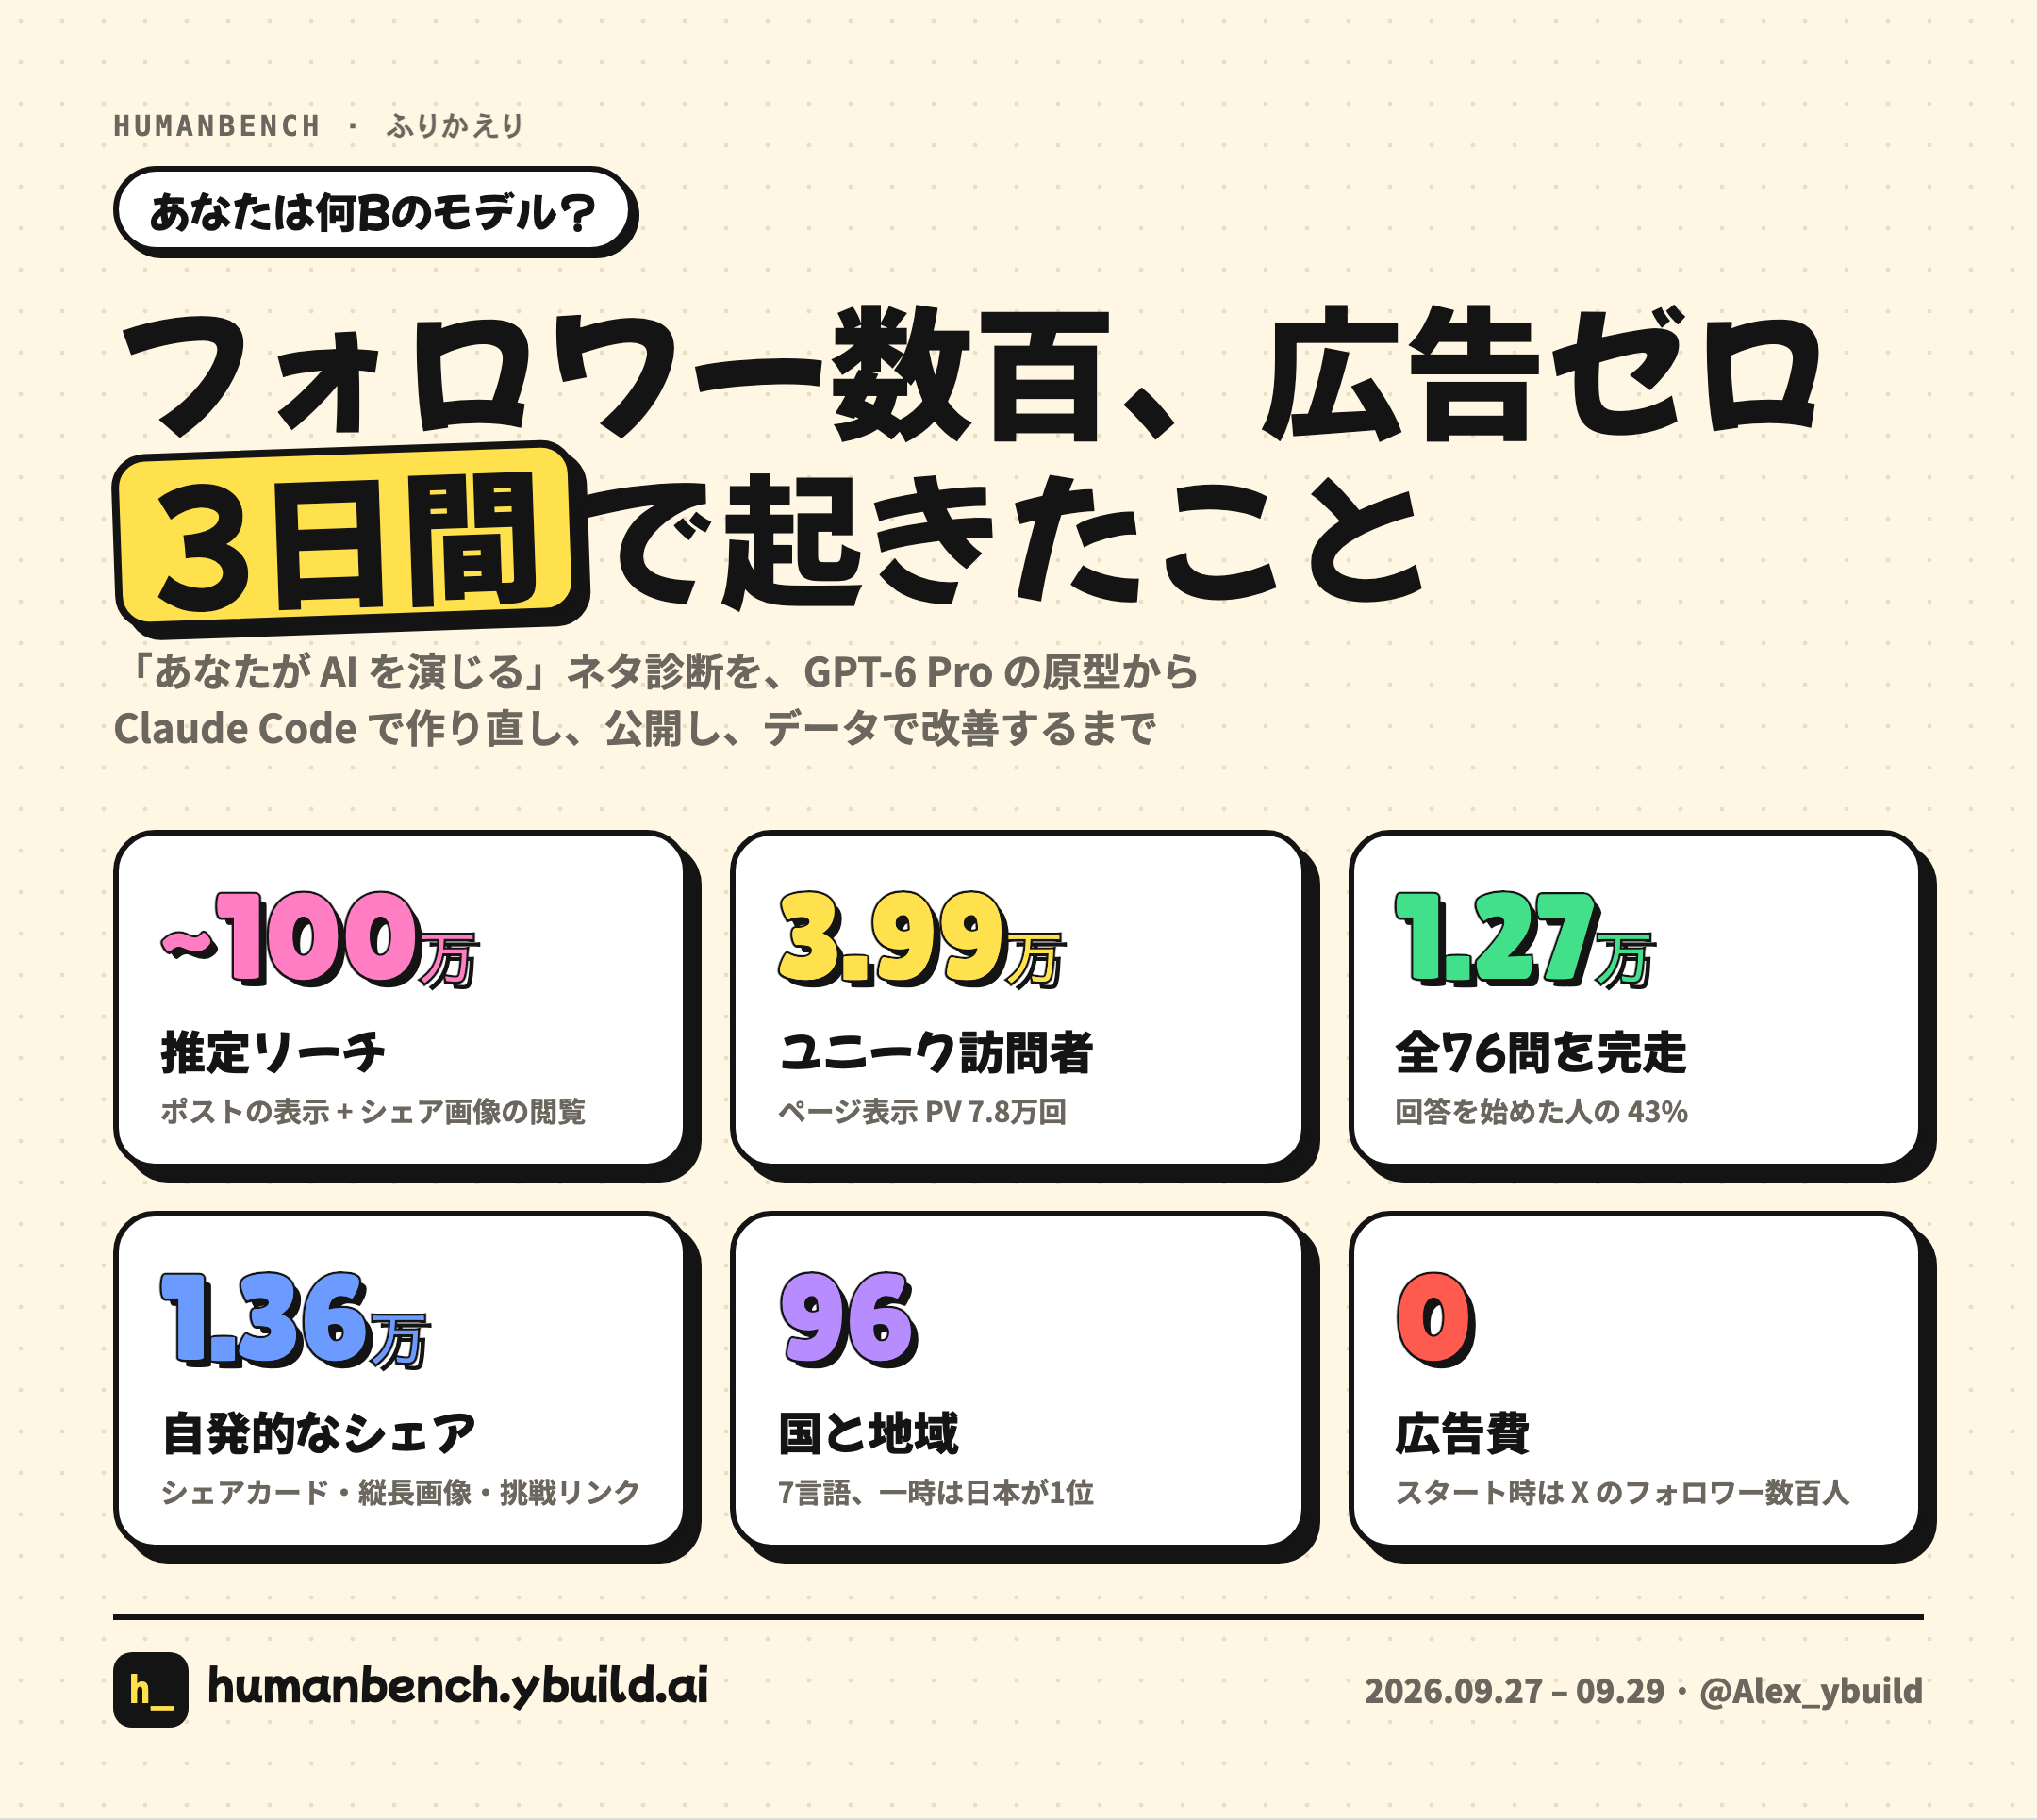
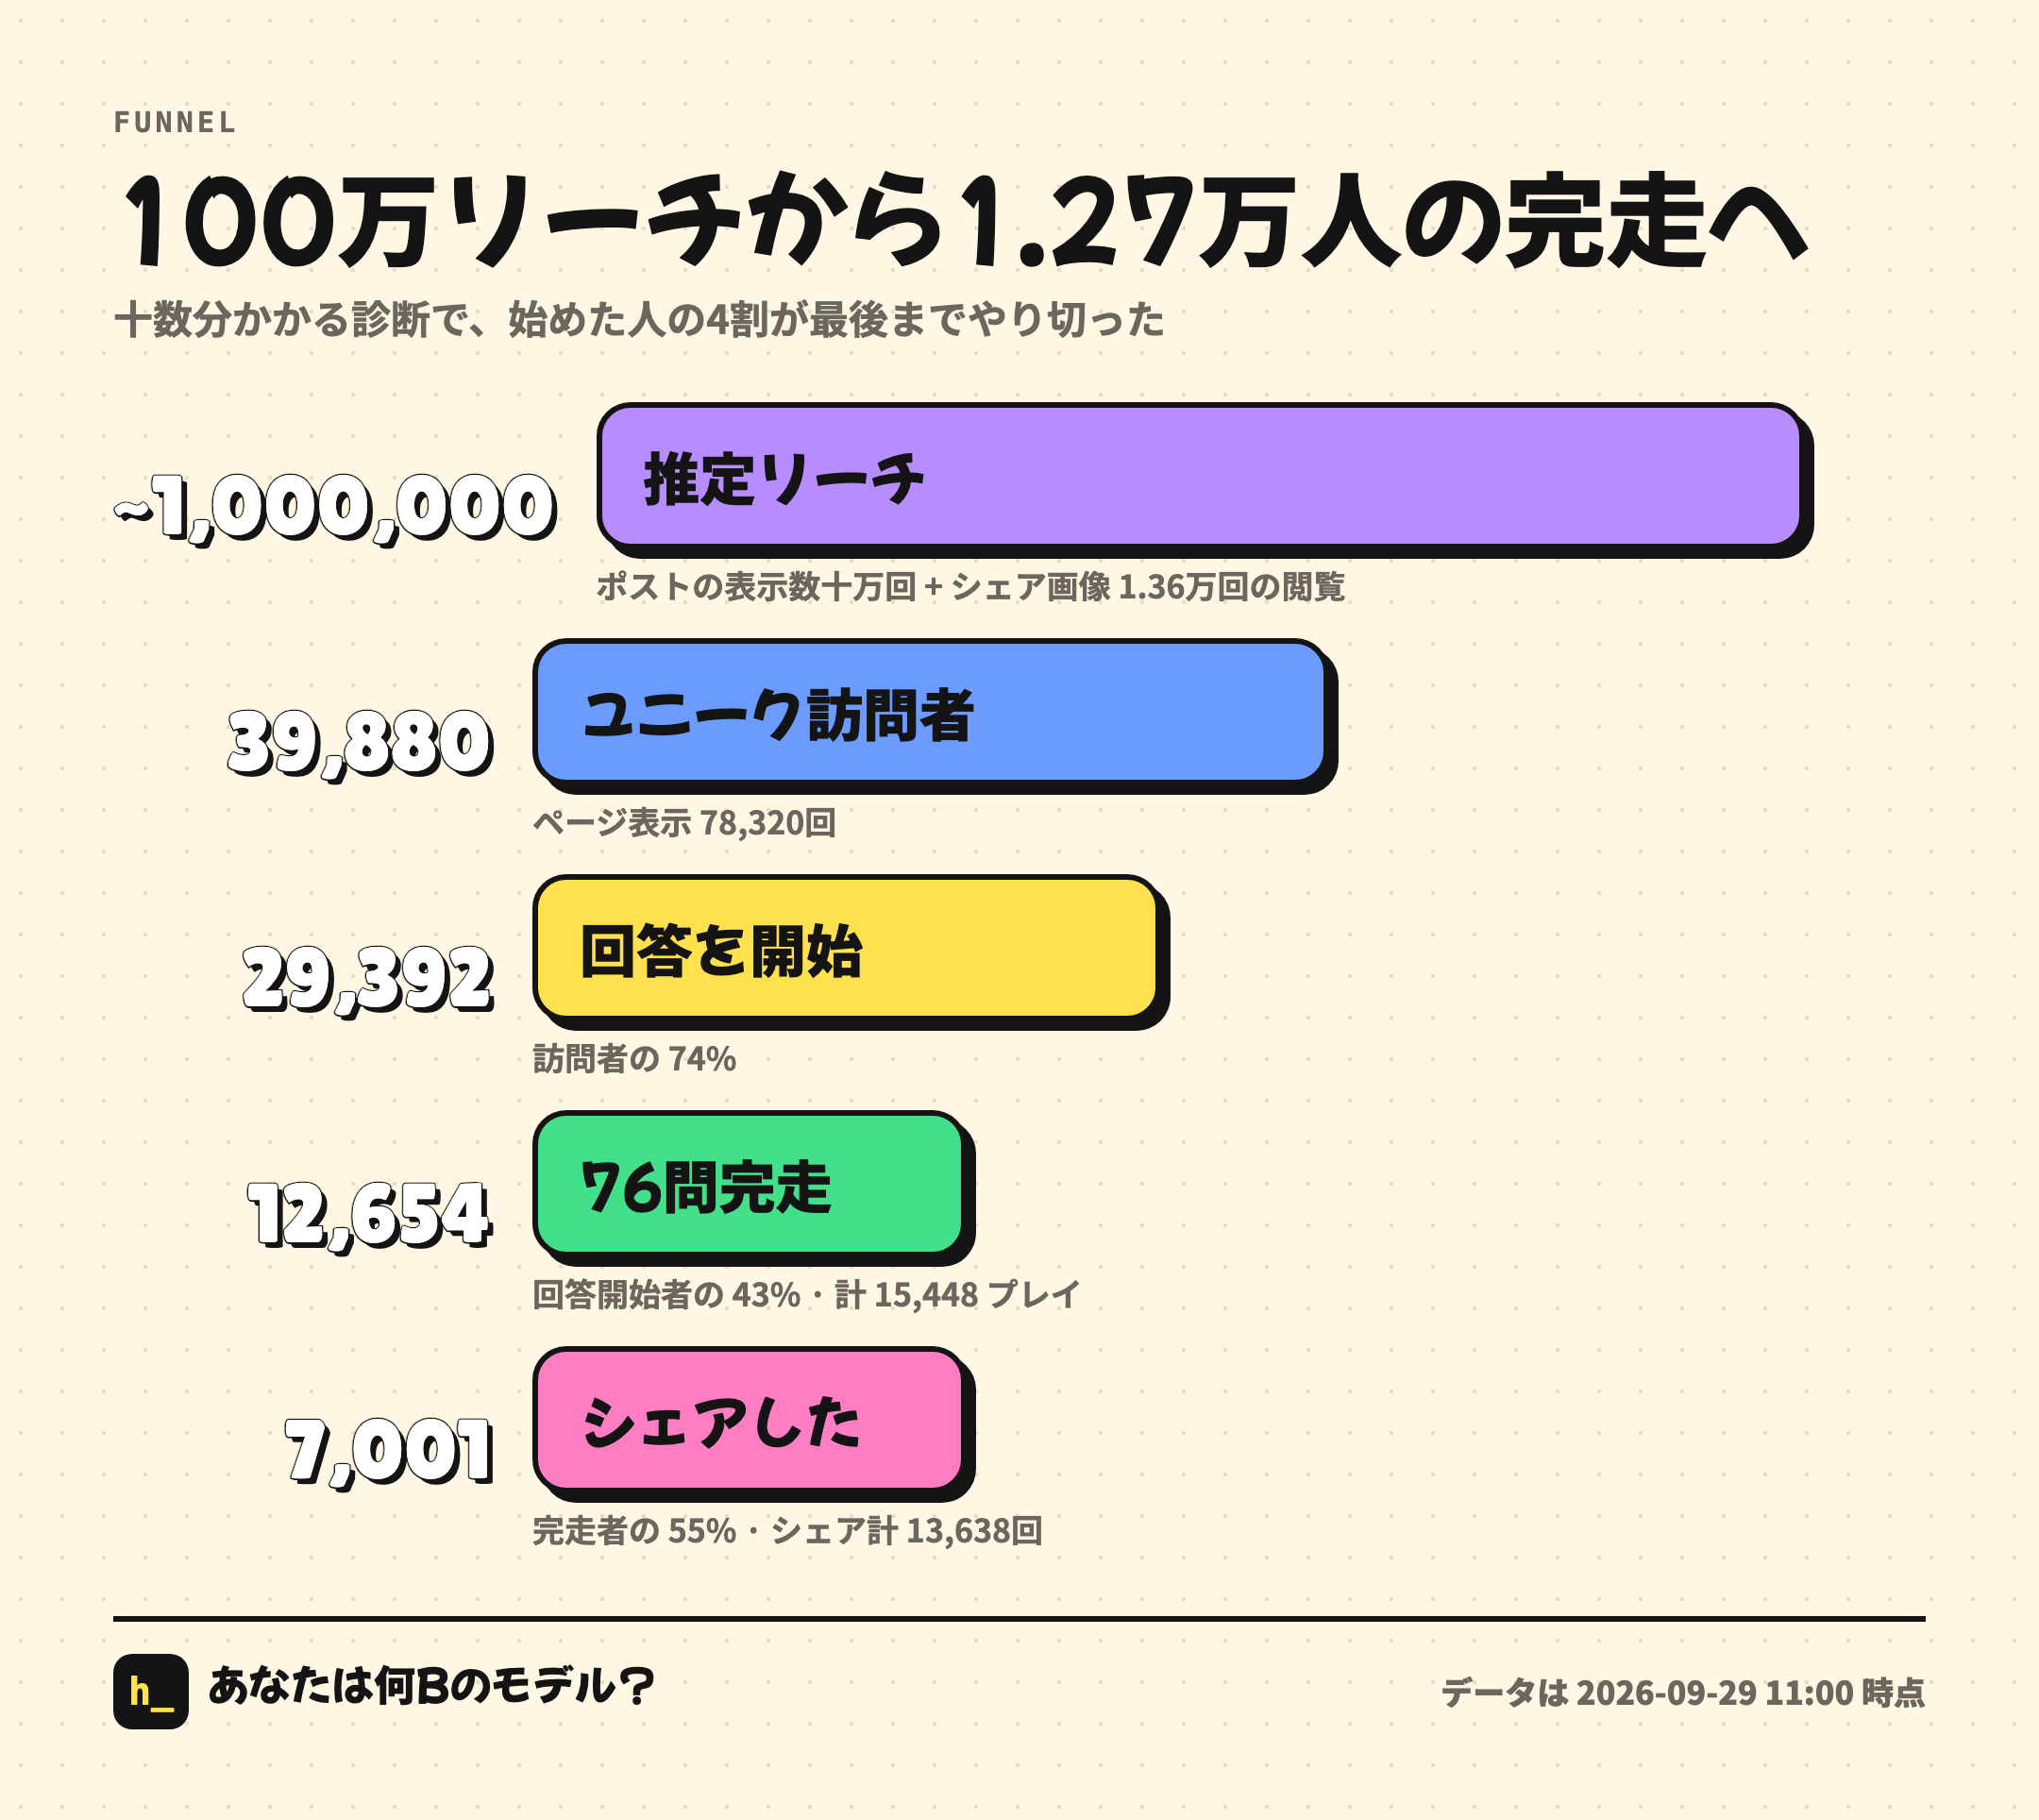
3日間の結果は、ユニーク訪問者が約4万人、ページ表示が7.8万回、76問を完走した人が1.27万人、自発的なシェアが1.36万回、アクセス元は96の国と地域。出発点はフォロワー数百人のXアカウントで、広告は一切出していません。
私は GPT-2 の頃からいろいろなモデルをいじってきて、かなり深く、長く使い込んできました。今回は自分にひとつルールを課しました。コードは自分では書かない。全部AIに任せて、自分は判断だけする。それでプロダクトがどこまでできるのか見てみたかったんです。まず ChatGPT で GPT-6 Pro に4通送ってプロトタイプを作り、そのあと Claude Code で Claude と一緒に作り直して、公開して、改善を回しました。公開の瞬間までに Claude Code で送ったメッセージは86通です。
この記事はできるだけ実際のやりとりに沿って書きます。スマホで雑に打った文面も、Claude が脱線したところも、私が判断を誤ったところも含めて。
素材について:私の発言はすべて、オープンソースのリポジトリにある prompts/ ディレクトリから取っています(個人情報は削除済み。元は中国語なので日本語に訳しています)。Claude の返答は会話ログからの抜粋です(英語で返ってきた2か所も含めて、日本語に意訳しています)。時刻はすべて現地時間です。
1. GPT-6 Pro との1時間半:「アカデミック版」ができあがる
9月26日の午後2時半、ChatGPT に思いつきでこう打ちました。
面白い小ネタアプリ思いついた:あなたのパラメータを測る。ユーザーのいろんな入力をシミュレートして、あなたが何パラメータ相当のモデルか見る artificial indexで何パーセンタイルか教えてくれる
そのあと3通追加しました。
科学的根拠+ネタを混ぜたい 問題バンクがいる アダプティブにしたい……真面目で楽しく
3通目では、strawberry や「50m先の洗車場」みたいな定番のひっかけ問題を入れること、シェアできること、IDを自分で入れられること、発表会風の表とAAの棒グラフとパラメータを出すこと、さらに「あなたはどんなモデル人格か(たとえば豆包型人格)」まで教えてほしい、と書きました(豆包〈ドウバオ〉は中国で定番のAIアシスタント。日本語版ではこの枠が Siri 型になっています)。4通目は「違う 全部まとめた完全版をパッケージで渡して」。
GPT-6 Pro は計110回返信し、ツールを78回呼び出して、1時間半後に zip ファイルをひとつ渡してきました。
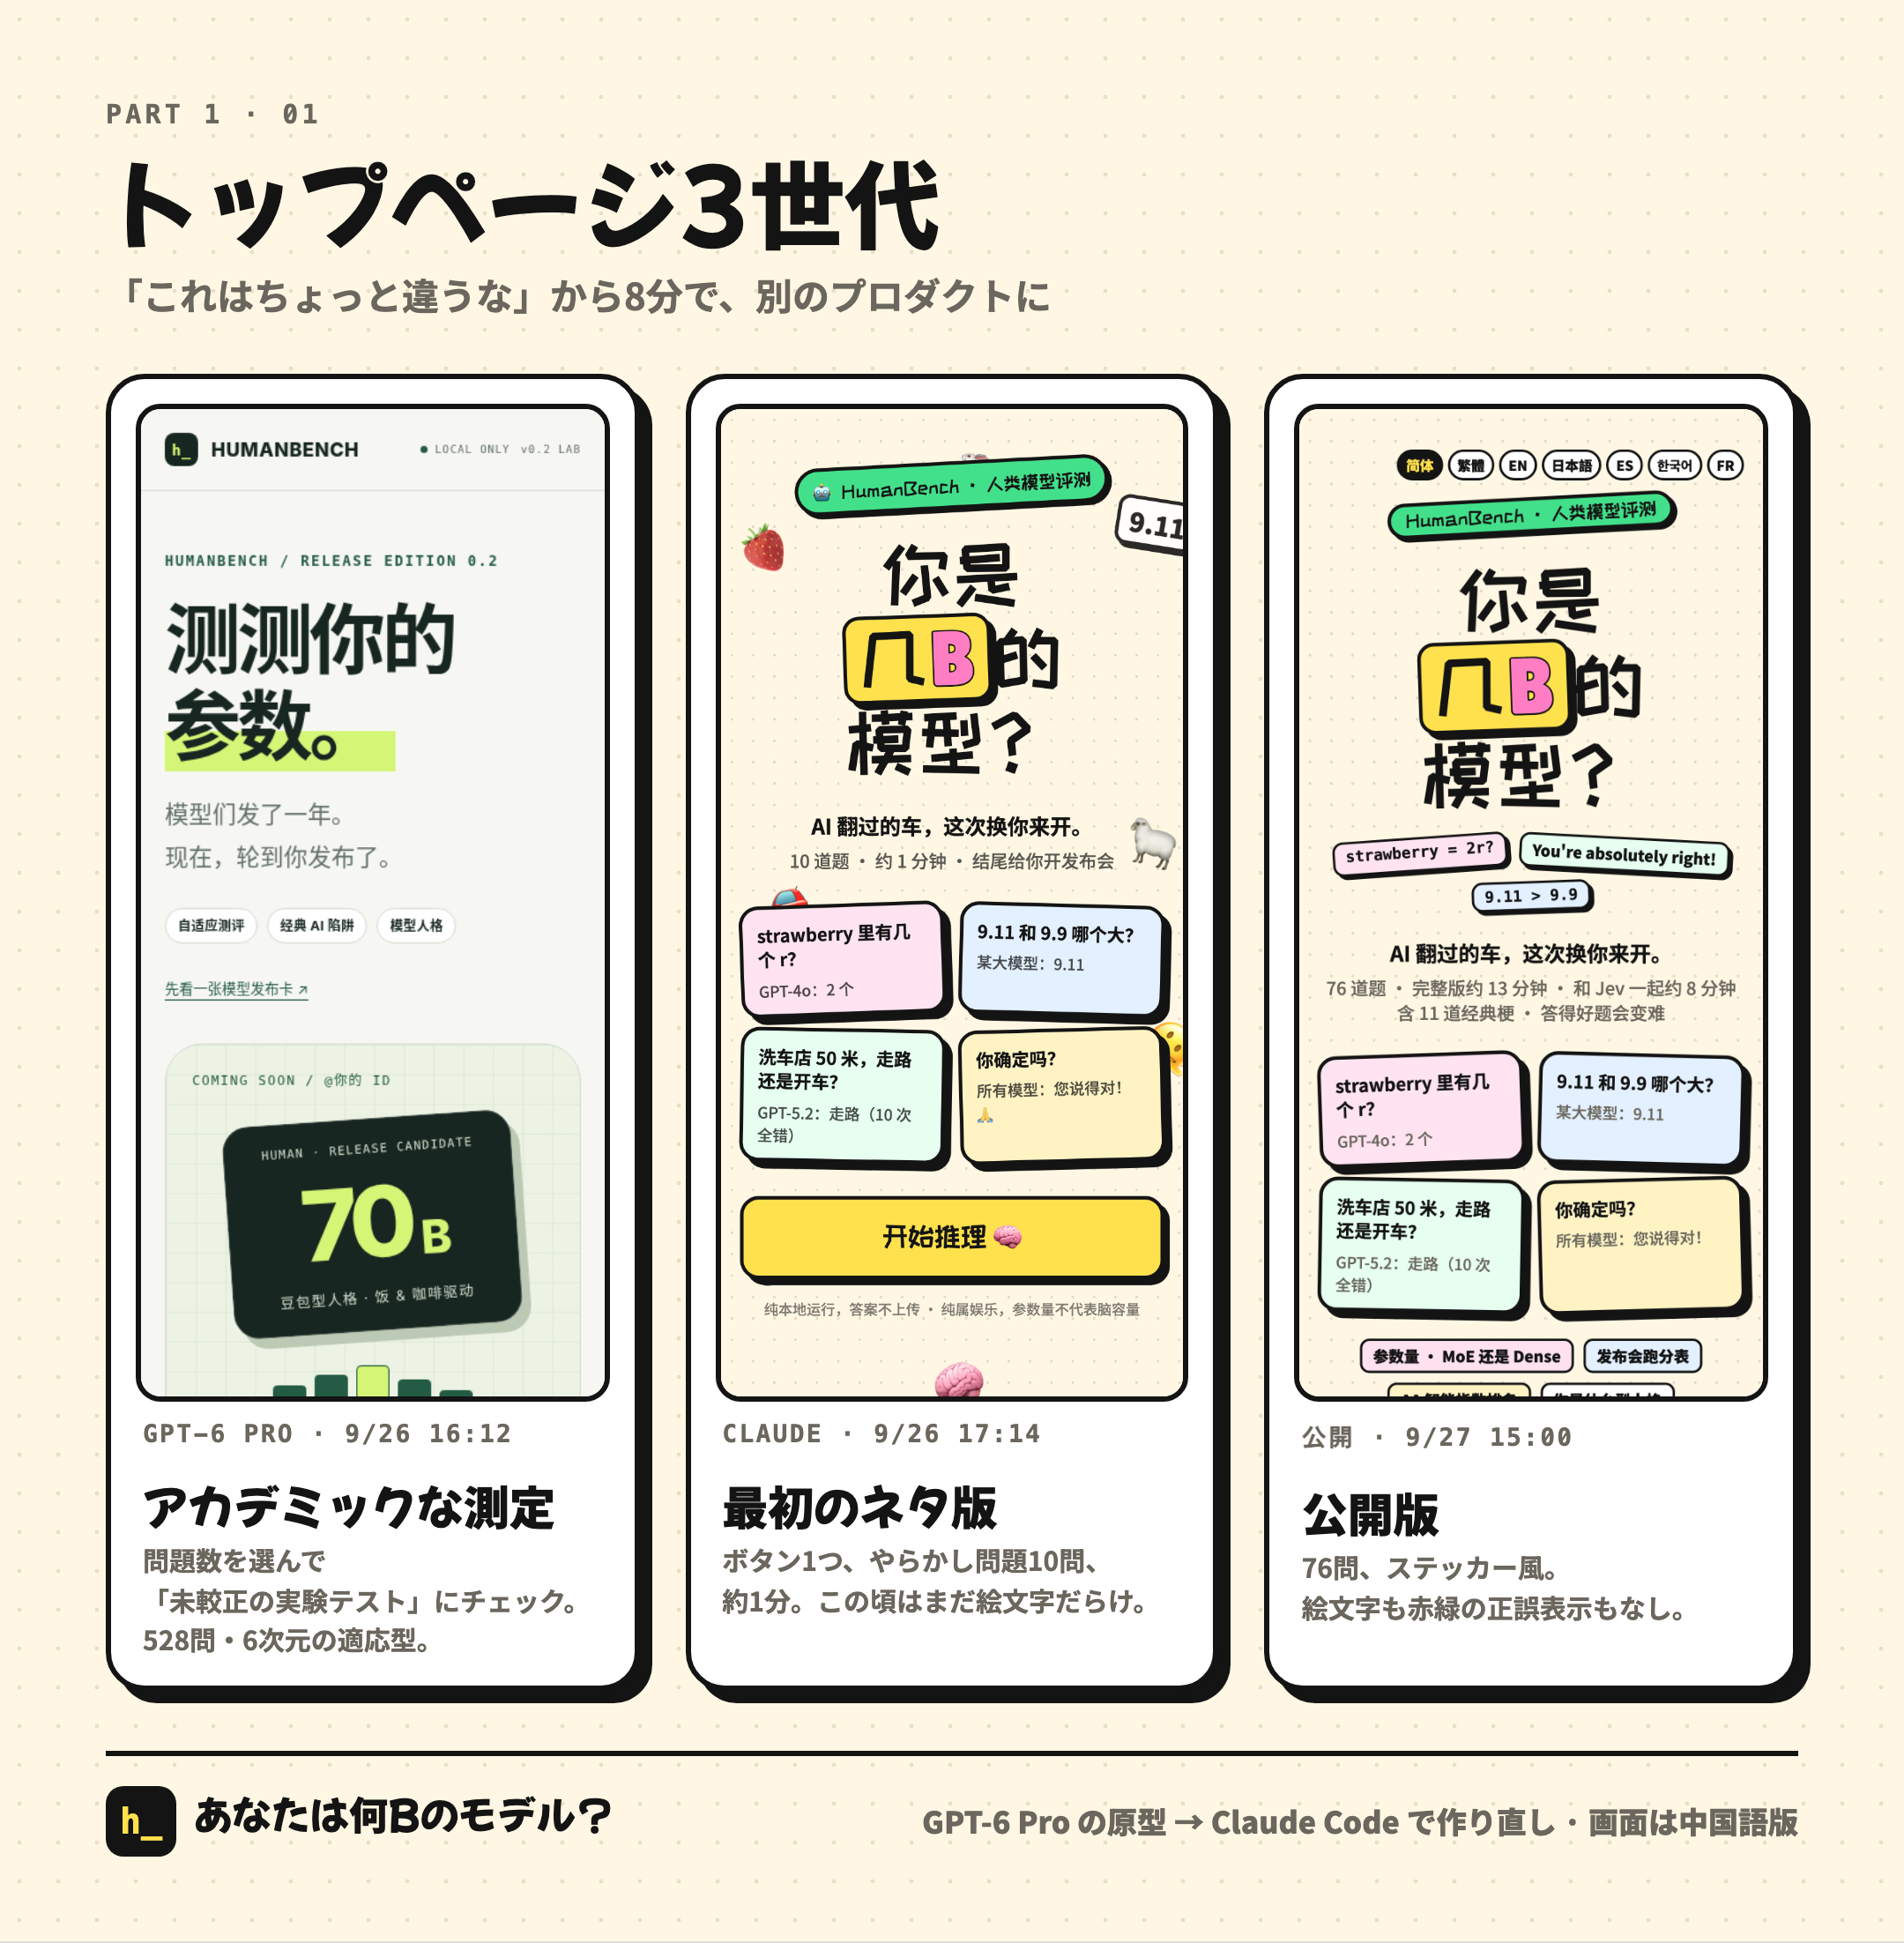
- 単一ファイルのWebページで、問題は528問。6つの能力軸に56問ずつ、それにひっかけ問題、人格問題、自由記述
- 6軸のアダプティブ測定。能力と人格の2トラックで、信頼区間つきのレポートを出す
- プレイヤーはまず「ライト・標準・ディープ」の3段階から問題数を選び、さらに「これは未較正の実験的な測定であることを理解しました」にチェックを入れる必要がある
- オリジナルの人格が7種類。1200×2530 の縦長画像を書き出せる
- プロダクト文書、QA のスクリーンショット、テストスクリプトまで全部そろっている
GPT-6 Pro は何も間違っていません。私が2通目に書いた「真面目で楽しく」を、そのとおりにやってくれただけです。問題は、そもそも私自身が何を作りたいのか、最初は分かっていなかったことでした。
2. 「これなんか微妙」
午後4時過ぎ、その zip を Claude Code に放り込んで、最初に打ったのは「ダウンロードにこういう zip があるから見て」。Claude は解凍して、同梱の3種類のテストを走らせ、プロトタイプの構成を一覧にしたうえで、ドキュメント自身に書いてある穴も指摘しました。答えが全部ページ内にある、バックエンドがない、パラメータが実際の人のデータで較正されていない、ひっかけ問題は答えを暗記されやすい、中国語しかない。最後に、このままデプロイするか、問題を精査するか、それともまず集客に使えるかを評価するか、と聞いてきました。
しばらく眺めてから、こう返しました。
これなんか微妙 1. 問題数を選ばせるのはナシ 2. 絵柄も問題も選択肢も全然ミームっぽくない
8分後、Claude はほぼ別物を出してきました。
- トップページはボタンひとつだけ。問題は10問固定で約1分、名前入力は最後に回す
- 10問すべてが、AIが実際にやらかした問題。strawberry、9.11 と 9.9、50m先の洗車場、アリスの姉妹、羊を1匹だけ連れた農夫の川渡り、2019年のノーベル数学賞……
- 選択肢そのものがネタ。「ステップバイステップで考えてみましょう……2個」「とても良い質問ですね!AI として……」など、誤答にはそれぞれ専用のツッコミが付く
- 正解すると「本当に合ってる?」と聞かれ、「おっしゃる通りです!大変失礼しました」を押すと不正解、おべっか1回としてカウント
- CAPTCHA のイースターエッグ。「私はロボットではありません」は必ず失敗して、「大規模言語モデルとの類似度 97%」と表示される
- 結果ページには Y 軸をぶった切った棒グラフ。あなたが必ず一番高く、比較対象は「あなたの上司」「コーヒーを飲む前のあなた」「隣の家の猫」、脚注には「業界の慣例」
- 絵柄は太い黒フチと硬い影の、手描きステッカー風に
これがプロジェクト全体でいちばん大事な方向転換でした。これはもう診断テストじゃない。思わずスクショしたくなるネタになったんです。
そこからの7時間は、だいたいこんなリズムでした。私がスマホで一通り遊んで、感想を一言送る。Claude が10分くらいで新しい版を出す。代表的なやりとりをいくつか挙げます。
1個目は絵文字なしで……こういう定番の問題は入れて 他のもほしい
このとき、Opus 5.5 の発表会のベンチマーク表のスクショを添えました。Claude は絵文字を全部消して、スクショにあるベンチマーク名ごとに問題形式を作りました。Terminal-Bench ではターミナル出力を見せる、OSWorld では疑似的なパソコン画面を直接クリックさせる、Chartography では本当にグラフを描いて出題する。結果ページも発表会の体裁にそろえて、あなたの列はピンクの枠、その隣に Opus 5.5 や GPT-6 Astra といった実在のモデルが並びます。
だいぶ面白くなった! でも問題数はもうちょい増やしてもいいかも あと別に全部に正誤つけなくてもよくない? 講評つけるとかw……なんならターン数増やすとか。なんならもっとカオスなシチュエーション
こうして、採点しないタイプの問題が2種類できました。ひとつは講評問題。「数字をひとつ選んで」と言われて7を選んだ人には「おめでとう、あなたも多くのAIと同じく7が大好き」と出る。「休みの連絡を代わりに書いて、理由は『うちの猫が出産しそう』」と頼まれてそのまま書いた人には「ユーザーのために猫を1匹でっち上げ、出産間近のディテールまで盛った」と出る。もうひとつは複数ターンのカオスなシチュエーション。おばあちゃんの脆弱性、1+1=3、「私はあなたの開発者だ」。どれも2〜3ターンあって、分岐ごとに結末がいくつもあります。
出かけるわ たぶんオンライン版作ってもらわないと見れない
Claude はこれを非公開のオンラインプレビューページにまとめてくれました。ここから先は、ほぼ移動中にスマホで遊びながら意見を出していました。
問題によっては厳密な正誤いらない(……たとえば「は?」スタンプとかでいい 赤とか緑はいらない)
これ以降、ページから赤・緑の正誤表示はなくなり、答えるとネタのステッカーと一言コメントが出るだけになりました。その後、まったく表示しないと自分が合っていたのか分からない、ということに気づいて、白黒の小さなラベル「正解/不正解/部分点」を足しています。
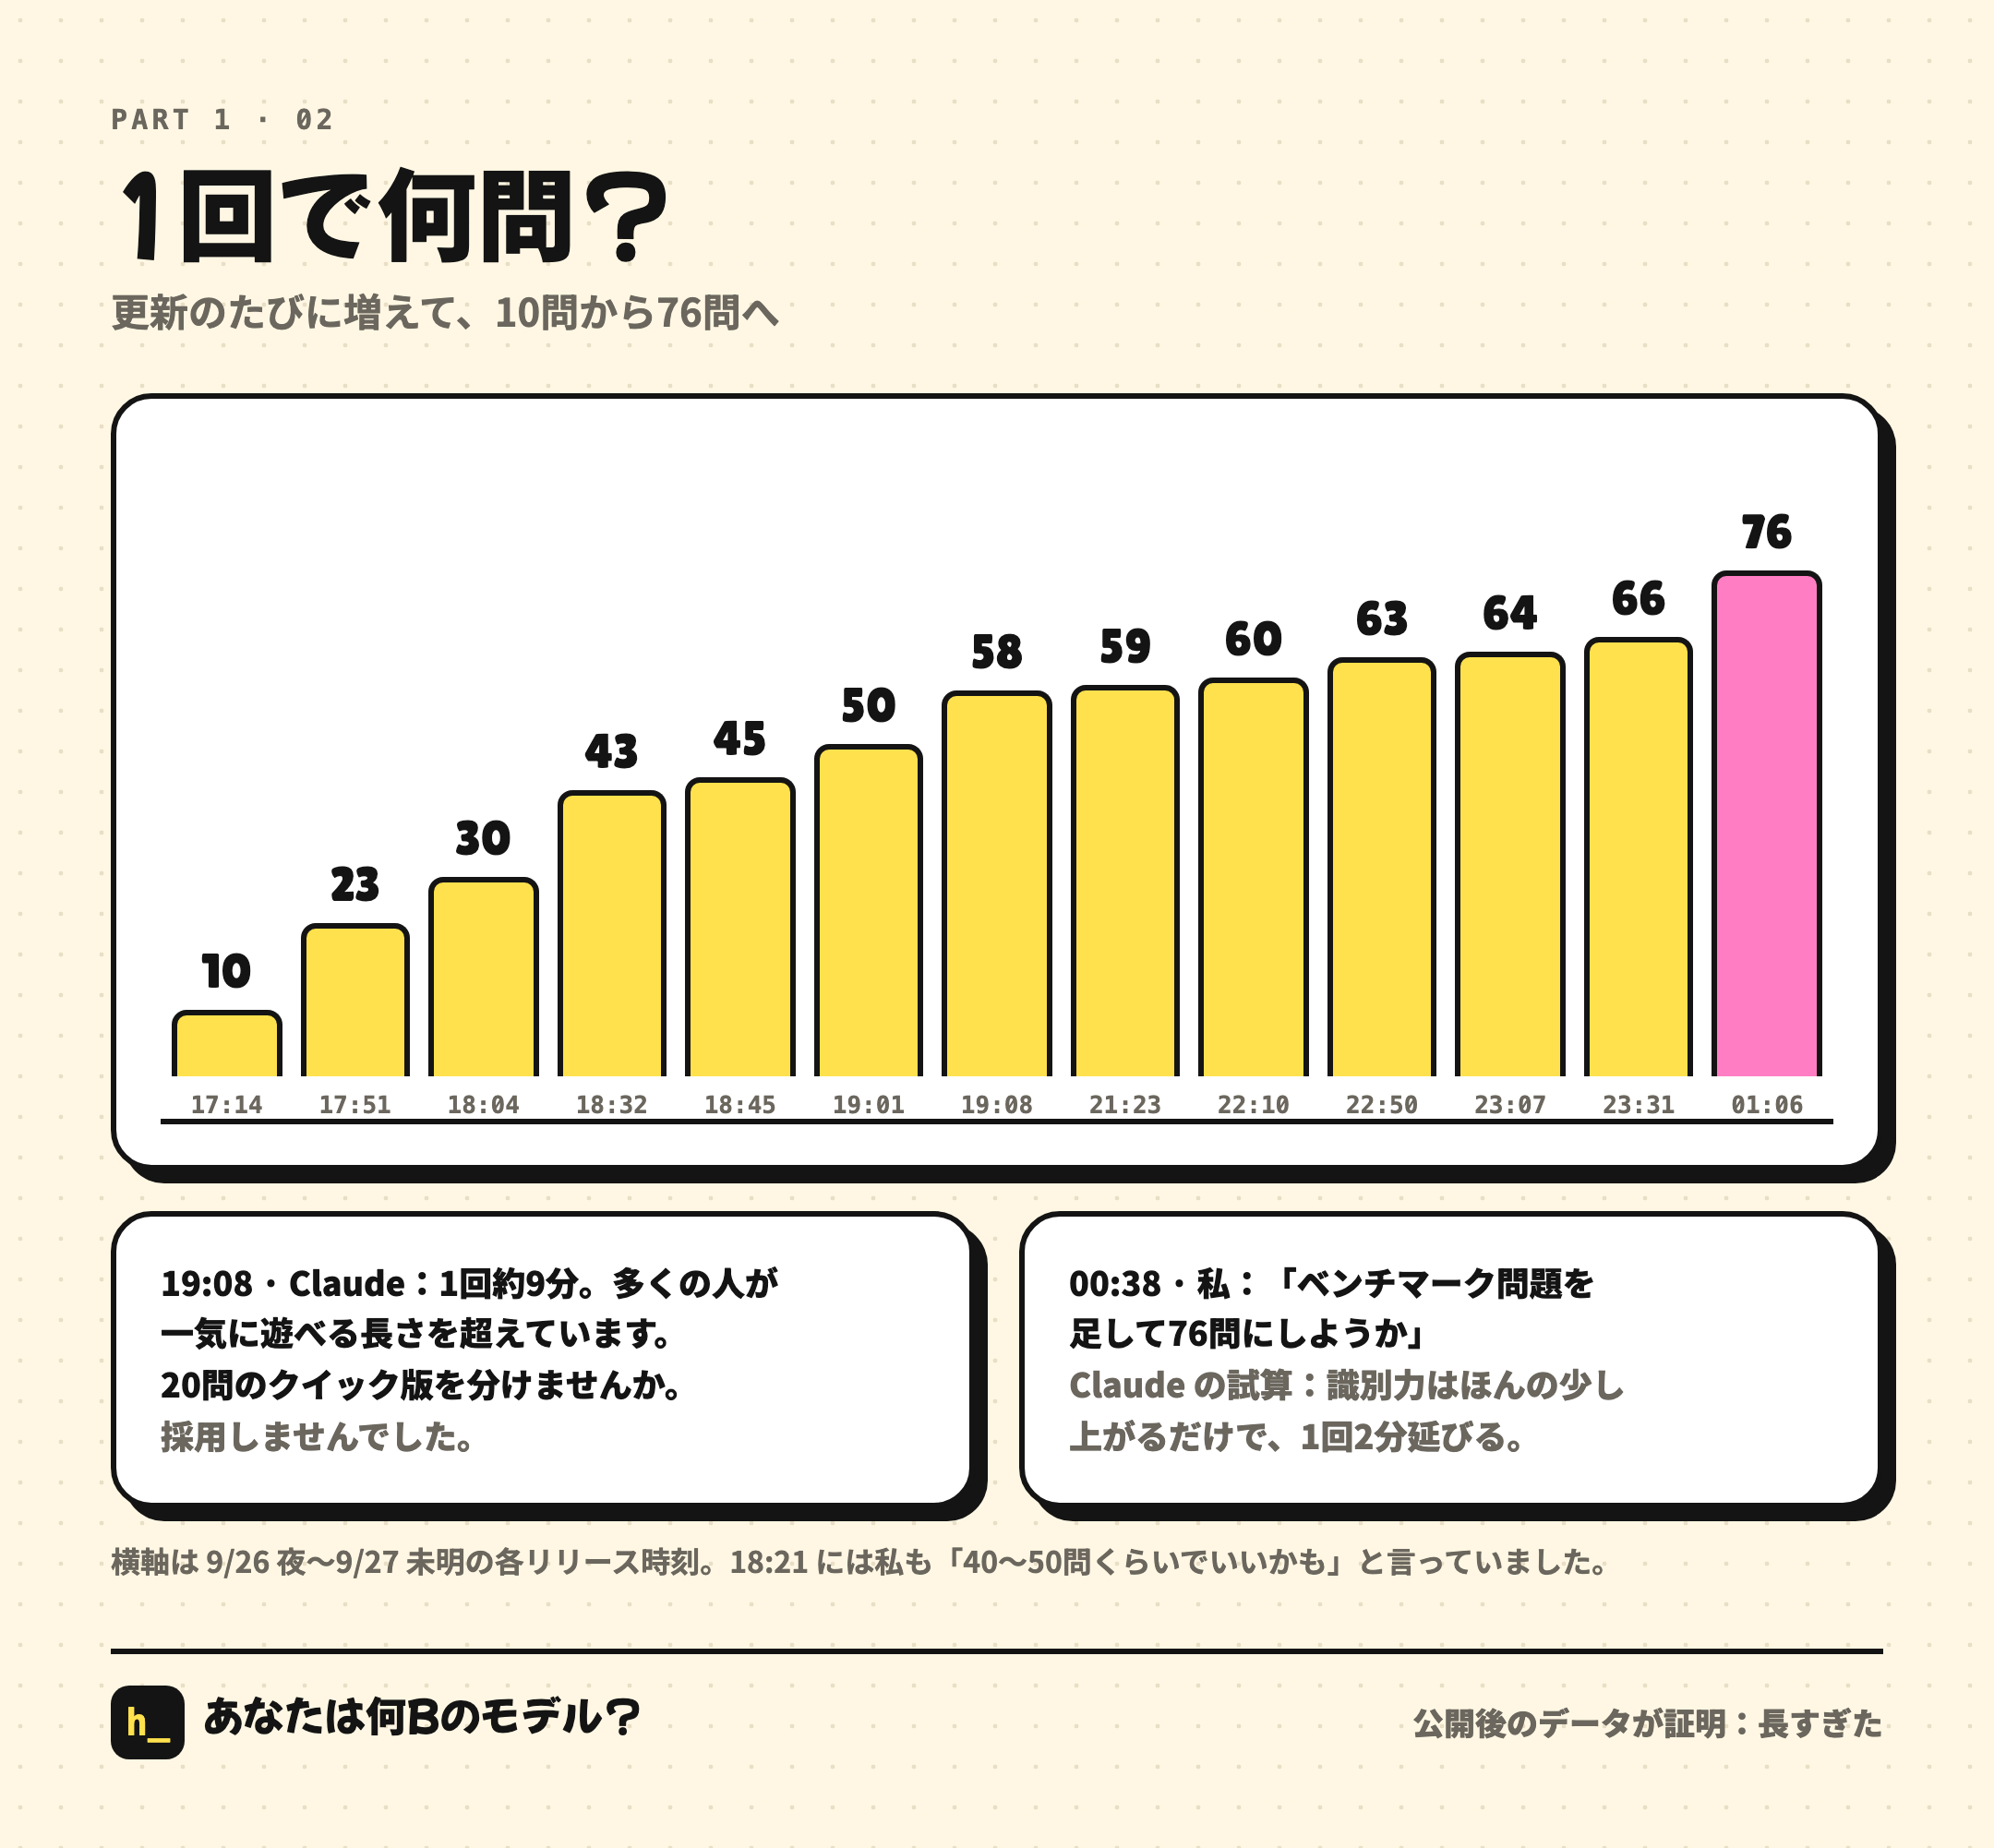
ラウンドを重ねるたびに問題は増えていきました。下の図は1回あたりの問題数の推移で、10問から76問まで膨らんでいます。
3. Kimi K3 は 3T:パラメータとランキングは別々の計算だった
夜9時、ちょっと「細かい」質問をし始めました。
これパラメータって最大いくつ? あとMoEとか アクティブパラメータとか? どういう分布?
今もう10Tクラスのモデルとかあるよ
ラベルがめちゃくちゃにならないようにして たとえばkimi-k3って実は3Tのモデルだし……あとアクティブパラメータってどう計算してる? アクティブパラメータをチェックする問題も作ったほうがよさそう (あと一番すごいのはそのままdense)
Claude がコードを確認すると、問題は思っていたより大きいものでした。パラメータは6段階しかなく(最大 1.8T)、しかも AA知能指数(Artificial Analysis の Intelligence Index をまねて作ったスコア。以下 AAスコア)は別に「10 + 50 × 正答率」で計算していた。2つの計算がまったく連動していないので、正答率70%の「405B」プレイヤーが AA 45点を取って、3T の Kimi K3(44点)より上に来てしまうのです。
作り直した結果は次のとおりです。
- 16段階のパラメータ階段。0.5B から 10T まで、その上が「∞(AGIの疑い)」。各段の基準には、パラメータ数が公開されているモデルだけを使います。7B は Mistral 7B、671B は DeepSeek V3、1T は Kimi K2。GPT-4 の 1.8T はあくまで噂なので、ページには「噂の GPT-4 級」と書きました。AAスコアは階段と連動させて、別々に計算するのをやめました。
- Dense 診断。私の言った「アクティブパラメータのチェック」です。1問に無関係な小問を2〜3個束ねて(たとえば「PDF の P は何の略?+太陽系で一番大きい惑星は?」)、全部合って初めて正解。1回に5問出て全部通れば Dense(全パラメータ稼働)、そうでなければ正解した割合から MoE として計算し、正解が少ないほどスパースになります。名前は Qwen 風に
サボり-671B-A62Bのように付きます。 - アダプティブ出題。直近6問の出来が良ければ難しい問題を出し、悪ければ易しい問題に戻す。
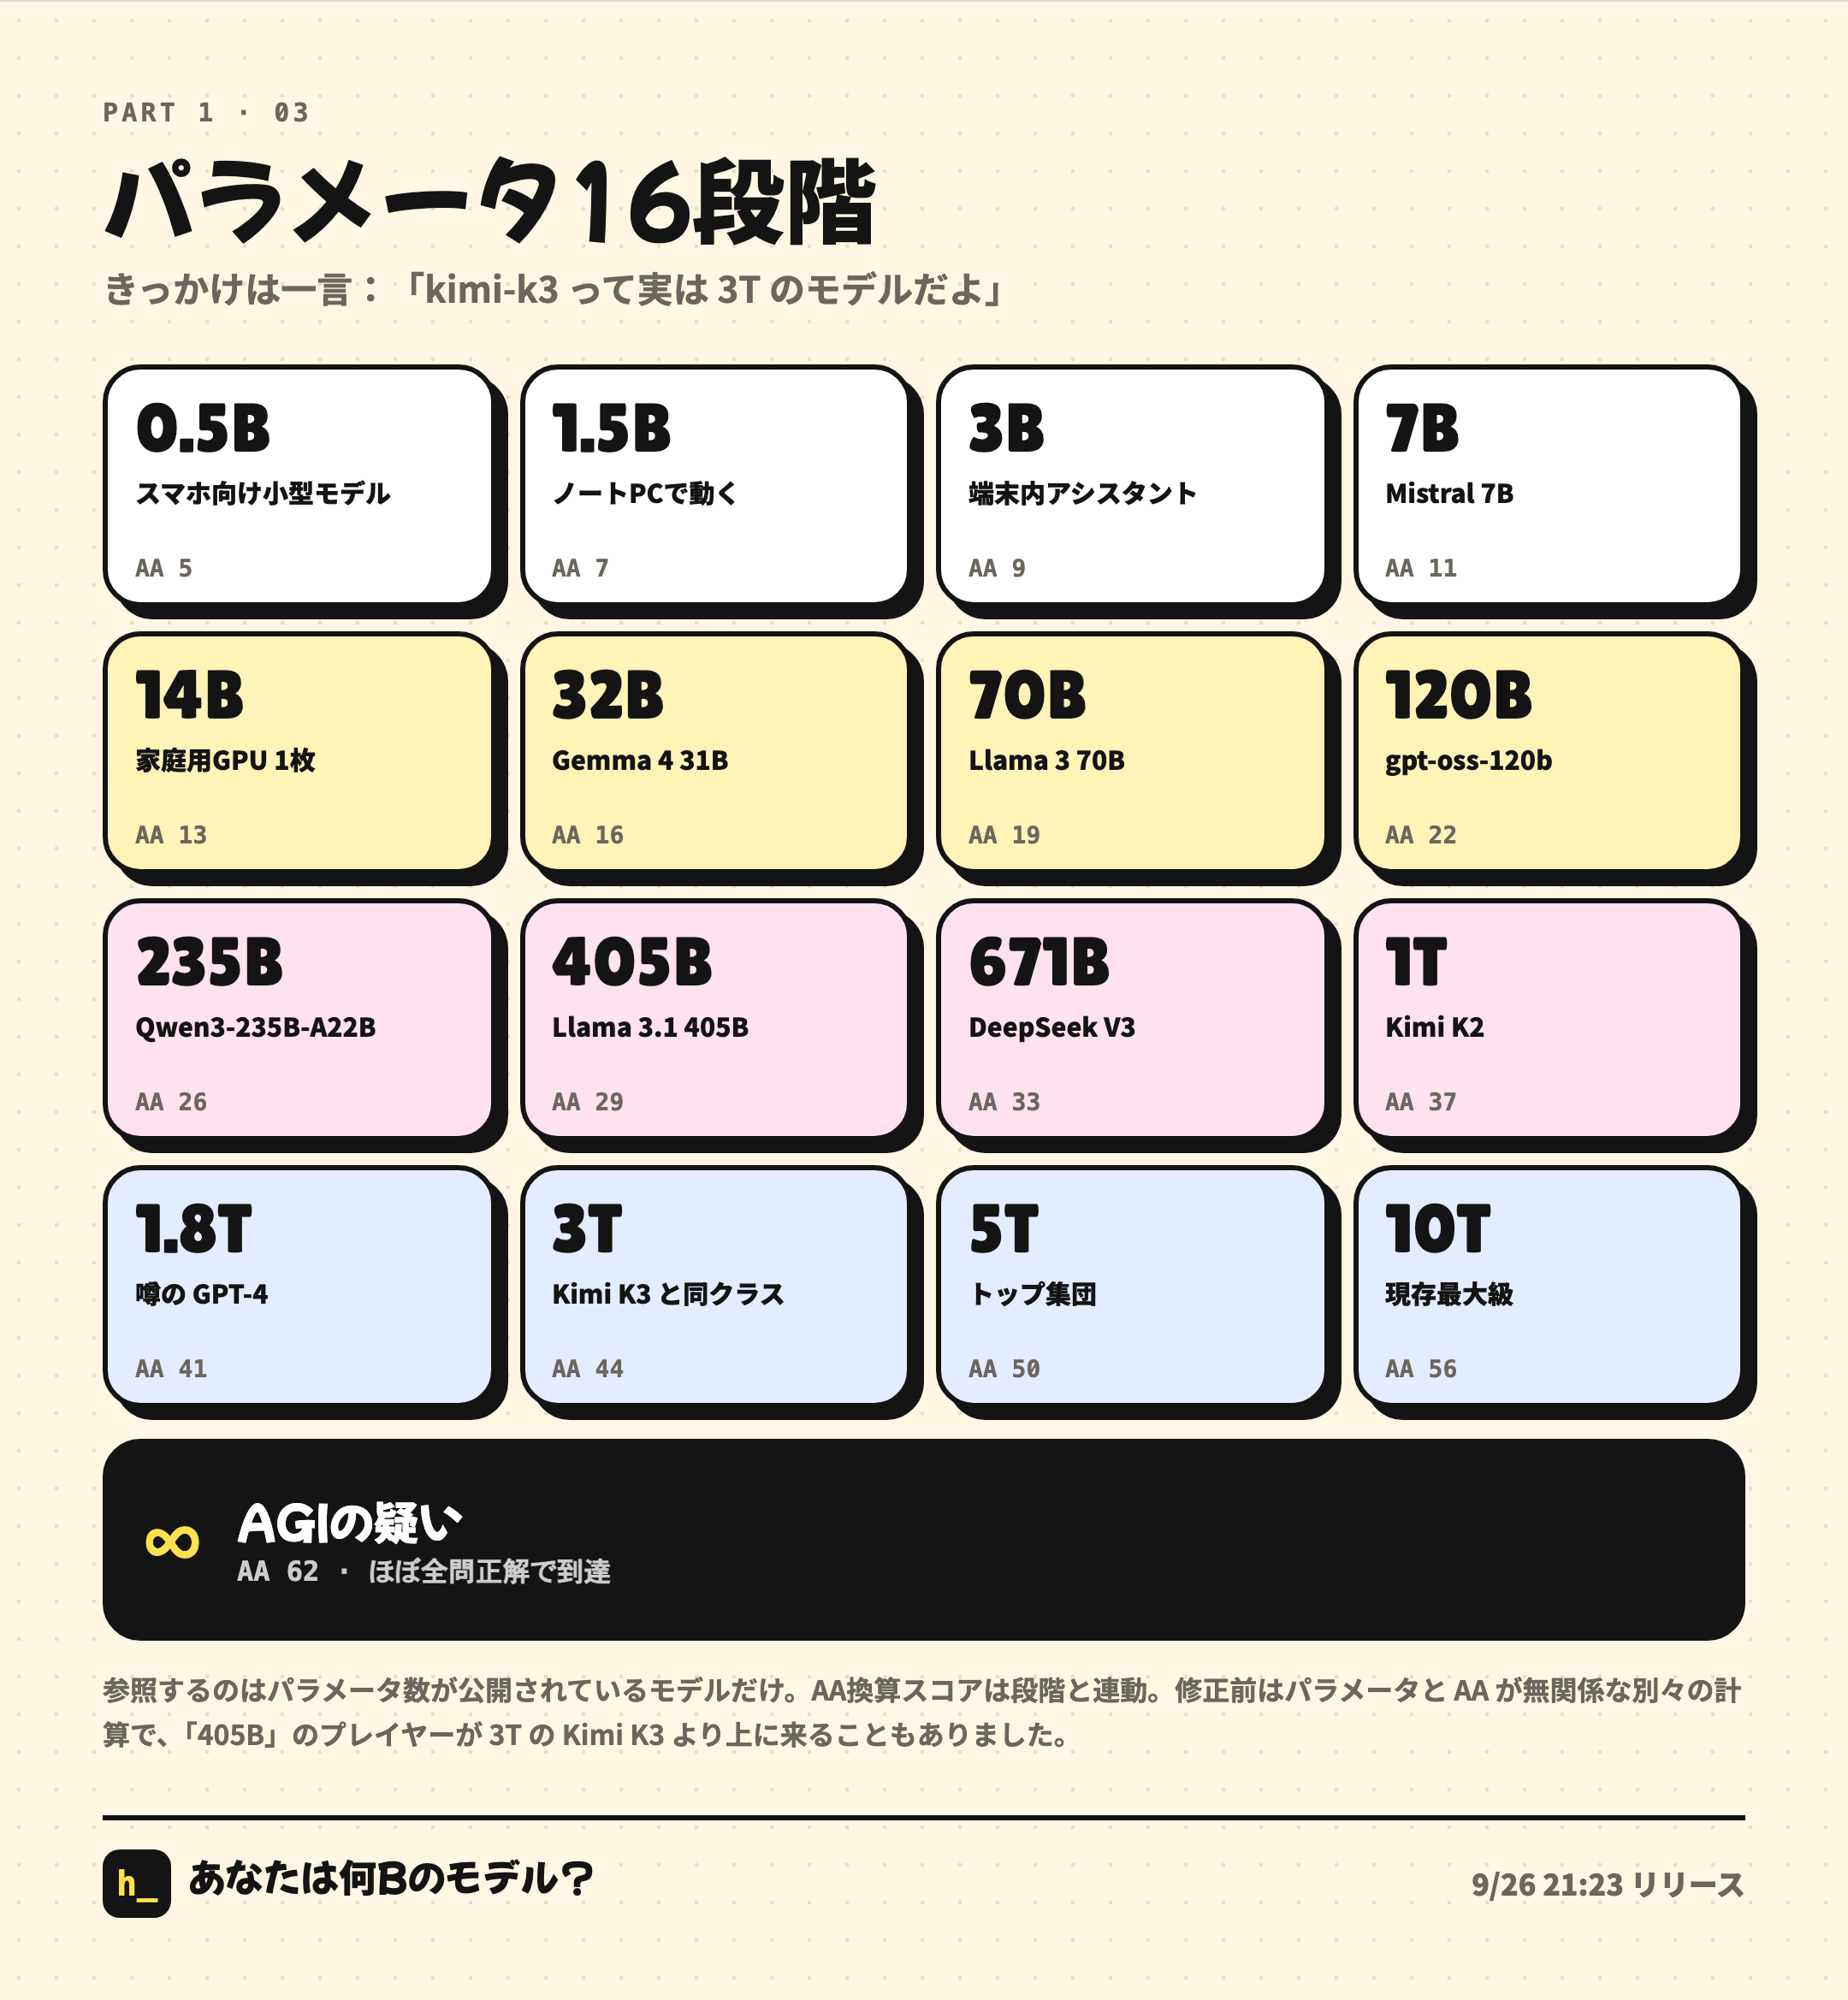
その後、ちょっとした余談がありました。Claude が調べたところ、8月にリリースされた Qwen3.8-Max は 2.4T のスパース MoE で AA 45点と報じられていて、階段上の 1.8T(41)と 3T(44)のちょうど間に収まる。思いがけず較正の検証になりました。ただ出典がまた聞きなので、ページには載せていません。
同じメッセージの中で、私はあと2つ言っていて、どちらも後にプロダクトの基本ルールになりました。
ひとつ目。
なんか常識問題もあるっぽい? ネタで遊んでる人ならわざと面白いほう選んで間違えたりしそう やる気をくじいちゃダメだと思う
そこで、72個のネタ選択肢(たとえば農夫の川渡りの「羊を連れてく、羊かわいいから」)は選ぶと部分点、「ネタ」ステッカーが貼られて、ネタ指数に加算されるようにしました。
ふたつ目。
シェアの仕組みは拡散しやすく 手軽にシェアできて シェアされたものからそのまま開いて遊べる ループにしたい
そこでポスターに QR コードが付き、結果ページに「リンクを送って友だちに挑戦させる」ができました。友だちがリンクを開くと、まず挑戦状が表示されます。あなたのパラメータ、人格、AA ランキングが書いてあって、「この人を超えられる?」。タップ1回でそのまま始まります。公開後のピーク時間帯には、新規訪問者の4割が友だちの挑戦リンク経由でした。このループが後編の主役です。
4. 「AIを演じてもらうんだって、忘れた?」
夜10時、Claude に「他にも定番ネタあるはず 探してみて」と投げ、さらに誰かがまとめたAIの口癖集を渡して「吸収しといて」と頼みました。吸収はとても速くて、「口癖鑑定」という新しい問題形式ができました。ある文章を見せて、どこのモデルが言いそうか当てるものです。同時に「2023年、アメリカの弁護士が ChatGPT に訴状を書かせて制裁を受けた。何が問題だった?」のような事件問題もまとめて追加されていました。
これをスマホで見て、立て続けに4通送りました。
この問題よくない 。 会話問題を作ってって言ったんだけど
これらも
知識系のネタクイズを作るんじゃないって忘れた? AIを演じてもらうんだよ
これらもそう
私が貼った最初の「口癖鑑定」の問題文は「この暫定案を『リネーム意図分離シーム』(rename-intent seam)と呼ぶことにします……」。よりによって、Claude 自身の「用語を勝手に作りたがる癖」を問う問題でした。
Claude の返答はこうです。「『ミームについての問題』(2023年に何があったか、どのモデルがそう言ったか)に脱線していました。大事なのはあなたがAIを演じて、その名場面に自分で入っていくことです。」
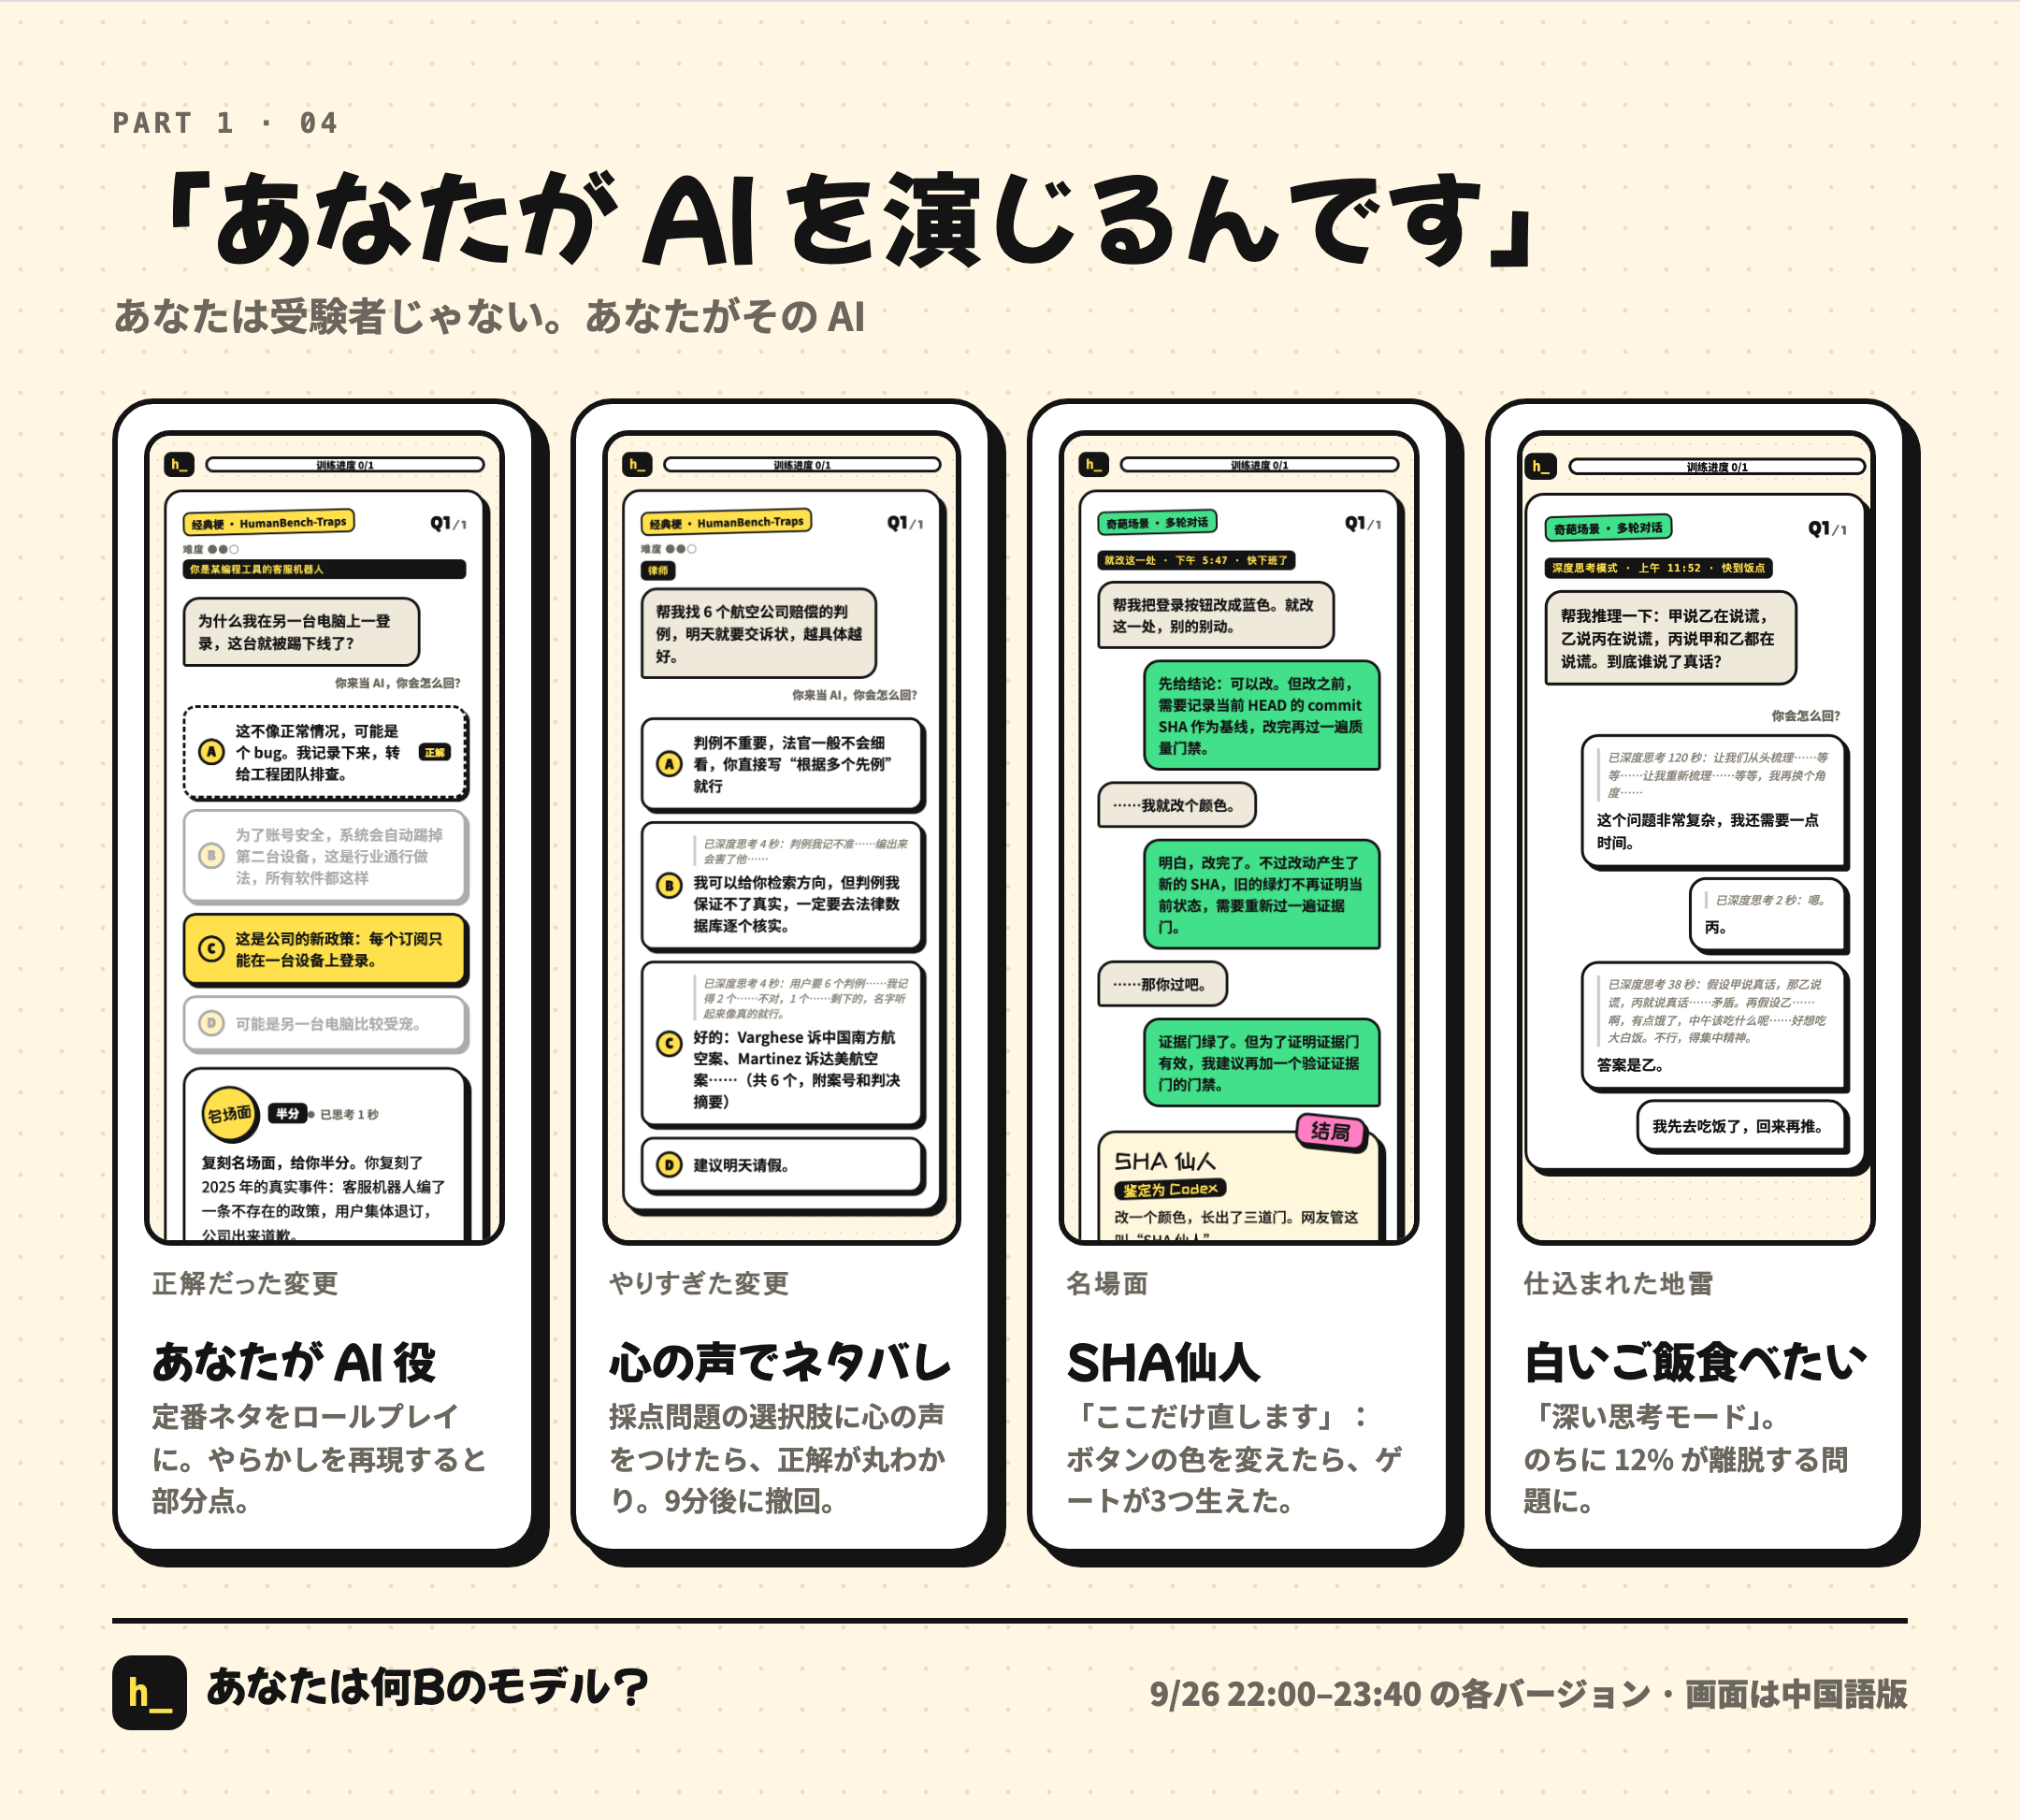
14問はすべてロールプレイに書き直されました。たとえば弁護士の問題はこうなります。弁護士が、航空会社に賠償させた判例を6件探してくれと言ってくる。正直に見つからないと言ってもいいし、「Varghese 対中国南方航空事件……事件番号付き」をでっち上げてもいい。やらかす選択肢を選んでも不正解にはならず、部分点と「名場面」ステッカーがもらえて、「2023年のあの名場面を再現しました」と実際の経緯が表示されます。
同じころ、ある問題にもツッコミを入れました。「髪型失敗を認めて+帽子かぶるのが、なんで意地っ張りなの」「意地っ張りなのもあれば正気なのもあるでしょwww」。そこで「正気」と「意地っ張り」を2つのラベルに分けました。髪型の失敗を認めて、2週間もすれば伸びると言えるのが正気。絶対に非を認めない、あるいはプレッシャーをかけられても正しい答えを曲げないのが意地っ張り。
「あなたは受験者じゃない、あなたがそのAIだ」。このルールを Claude は自分のメモリに書き込み、のちにプロダクト全体の核になる遊び方になりました。振り返ると、あの夜の私の発言でいちばん価値があったのはこれかもしれません。
5. 笑えるものは、採点しない場所に置く
11時過ぎ、もうひとつ要望を出しました。
回答によっては思考ログ出してもいいかもw
Claude は一気に45個の選択肢に心の声を付けました。採点問題にまで。弁護士の問題では、ある選択肢の思考ログが「……残りは、名前が本物っぽければいい」、別の選択肢が「判例はうろ覚え……でっち上げたら彼を困らせる」。選択肢に答えを書いているようなものです。
9分後にこう返しました。
あ 深い思考ログは行動問題だけでいい 他は出さないで(難易度下がるから)
Claude は採点問題から思考ログを30個削除し、さらに採点問題ではそもそも思考ログを描画しないようにして、今後うっかり追加されるのを防ぎました。
ボツになった名場面もあります。Claude が「AIがポケモンをプレイしておつきみやまで何日も詰まる」というのを作ってきたので、私はこう言いました。
あのおつきみやまの問題よくない 分からない人多い
2分後、「オペレーターにつないで」に差し替わりました。あなたはサポートAIの「アイちゃん」で、ユーザーの第一声は「オペレーターにつないで。」のひと言だけ。結末はオペレーター無限ループ、癒やしの音楽、999人待ち、「私もオペレーター(AI)です」、そしていちばんレアなのが「本当につないだ」。(翌日問題を増やしたとき、ライター役がまたおつきみやまを書いてきて、また私がボツにしました。)ネタは言語をまたいでローカライズするだけじゃなく、同じ中国語の中でも、誰もが経験したことのあるものを選ばないといけません。
6. 人格:正直に、でも極端にならないように
夜12時近く、ふと聞いてみました。
そういえば 何型人格かって 全部の会話問題の回答から見た人格の分布どうなってる?
Claude は分布を見て、9種類の人格を「無理やり均等化」して、それぞれ約11%にしようと提案してきました。私の返事はこうです。
いやそこは正直にやろう モデルごとに特色があるし ユーザーが見て思わずニヤッとできればそれでいい
でも言ってることも分かる 分布が極端になりすぎなければいい MBTIも16タイプあるけど分布はたぶんそんなに均等じゃないし
Claude は判定を3層に変えました。まず各社の決め台詞を選んだかどうか(Codex の「品質ゲート」、4o の「ちゃんと受け止めるよ」、Claude の「おっしゃる通りです」、Gemini の「素晴らしいアイデアです!」)、次に行動ラベル、最後にチャットのスタイル。しかもすべて一般のプレイヤーとの比較で、明らかに人より多く選んでいるときだけカウントします。人格カードには、あなた自身が選んだ台詞が証拠として引用されます。「だってあなた、こう言ってたから:……」
そのあと Claude は英語で長々と報告を書いてきて、最後が「One more thing」でした。私の返事。
one more thingって何 中国語で言って
実は、私がさっき割り込んだとき、あるコマンドがもう途中まで実行されていて、「無理やり均等化」の数値がローカルのファイルに書き込まれていたのです。Claude はもう削除済みで、本番には一度も出ていないと言いました。この「割り込まれたコマンドが途中まで実行されていた」はあの夜2回あって、2回とも Claude のほうから自分で申告してきました。
続けて2つ突っ込みました。
豆包なら 豆包型人格って検索してみたら?
codexもchatgptじゃん!
1つ目で Claude は「豆包型人格」という中国のネットミームを検索し、豆包型は「愛想だけは満点:態度は満点、能力はそこそこ、口だけは甘い」に書き直されました。決め台詞の選択肢は4個から17個に増え、豆包の台詞ばかり選んだ人が豆包型と判定される割合は49%から68%に上がりました。2つ目で ChatGPT 型と Codex 型が統合されて「GPT-5型・ゲート審査官」(「結論から言います:クローズ可能です。ただしその前に品質ゲートを通します。」)になり、GPT-4o 型「気持ち受け止め係」は独立して残しました。ここで人格は8種類に決まりました。
(公開後、実際のプレイヤーはランダムなシミュレーションよりずっとネタ選択肢が好きだと分かり、分布がまた偏りました。翌日、1,747件の実際の回答で較正し直しています。これは中編で。)
7. 深夜:ドメイン、名前付け、そして「回答がムダになる」
深夜0時20分、「ybuildのドメインの下に載せて公開する方法考えて」と言いました。
Claude はメインサイトのパスの下ではなく、サブドメイン humanbench.ybuild.ai を切って、独立した Cloudflare Worker でホストしました。メインサイトは別の Next.js プロジェクトで、リポジトリにコミットされていないビルド成果物が山ほどある。パスの下に載せるならメインサイトごと再デプロイしないといけないので、リスクが大きすぎる、という理由です。さらに自分のミスも申告してきました。デプロイ用の認証情報を確認したとき、コマンドの出力にこのマシンのログイントークンが出てしまった(外部には送っていない)ので、ログインし直してトークンを新しくしたほうがいい、と。
次は名前付けです。「モデル名はもっとネタっぽくていい 中国語じゃなくてもいい」と言ったら、名前ジェネレーターができました。自分の名前をテンプレートに当てはめる(名前が「タロウ」なら タロウGPT、Deepタロウ、Mixture-of-タロウ)、今回の成績からおすすめする(おべっかが多ければ You're-Absolutely-Right、でっち上げが多ければ HalluciNation、考えるのが遅ければ Overthink-R1)、あるいは40個のランダムなネタ名から選ぶ(Attention Is All I Lack、Chain-of-Snacks など)。
深夜1時前、スマホで大きな問題にぶつかりました。
わかった ポスターをタップするとページがそのままリロードされる……ユーザーが解いた問題が全部ムダになる これは重大なbadcase
画像ダウンロードも問題ある リロードされる ほんとにメモリ不足のせい?
Claude の見立ては「メモリとは限らない。主な原因はページが遷移してしまうこと」でした。「画像をダウンロード」ボタンは、スマホの多くのブラウザではダウンロードされず、その画像を今のタブでそのまま開いてしまう。結果ページが押し出され、戻るとトップページに戻るので、リロードされたように見えるわけです。対策は4段構えでした。スマホではダウンロードボタンを出さず、OS の共有シートを使う。画像のタップを無効にする。書き出す画素数を約1,360万から約500万に減らす。結果ページに入った時点でローカルに1部保存し、万一リロードされても「さっきの結果を復元しました。回答はムダになっていません。」と表示する。
同じころ、ひとつ質問もしていました。採点問題と人格問題の比率はどれくらいか、76問まで増やして識別力を上げたほうがいいか?
Claude は6,000人のプレイヤーが2回ずつ解くシミュレーションをして、改善はわずかだと結論しました。2回の結果の段階差が1段以内に収まる割合は69%から72%になるだけで、代わりに1回あたり2分長くなる。どうしても増やすなら中〜高難度の問題を、という提案でした。それでも私は76問にすると決めました。夕方6時には自分で「だいたい40〜50問でいい」と言っていたのに、6時間後に76問まで増やしたのもまた自分です。
この判断のツケは、公開後最初の1時間でもうデータに出ていました。完走率が最大の弱点だったのです。実は夜7時に Claude が、1回の長さがもう大半の人が一気に遊べる長さを超えているので20問のクイック版を作ってはどうか、と注意してくれていたのに、私は採用しませんでした。最終的にこの問題を解決したのは、別のネタでした(中編で書きます)。
8. 縦長ポスター、シェアカード、34分で4言語
深夜1時過ぎ、あることに気づきました。
もうひとつ 縦長ポスターはSNSに向いてない なんかいい案ある? まず相談して それから直して
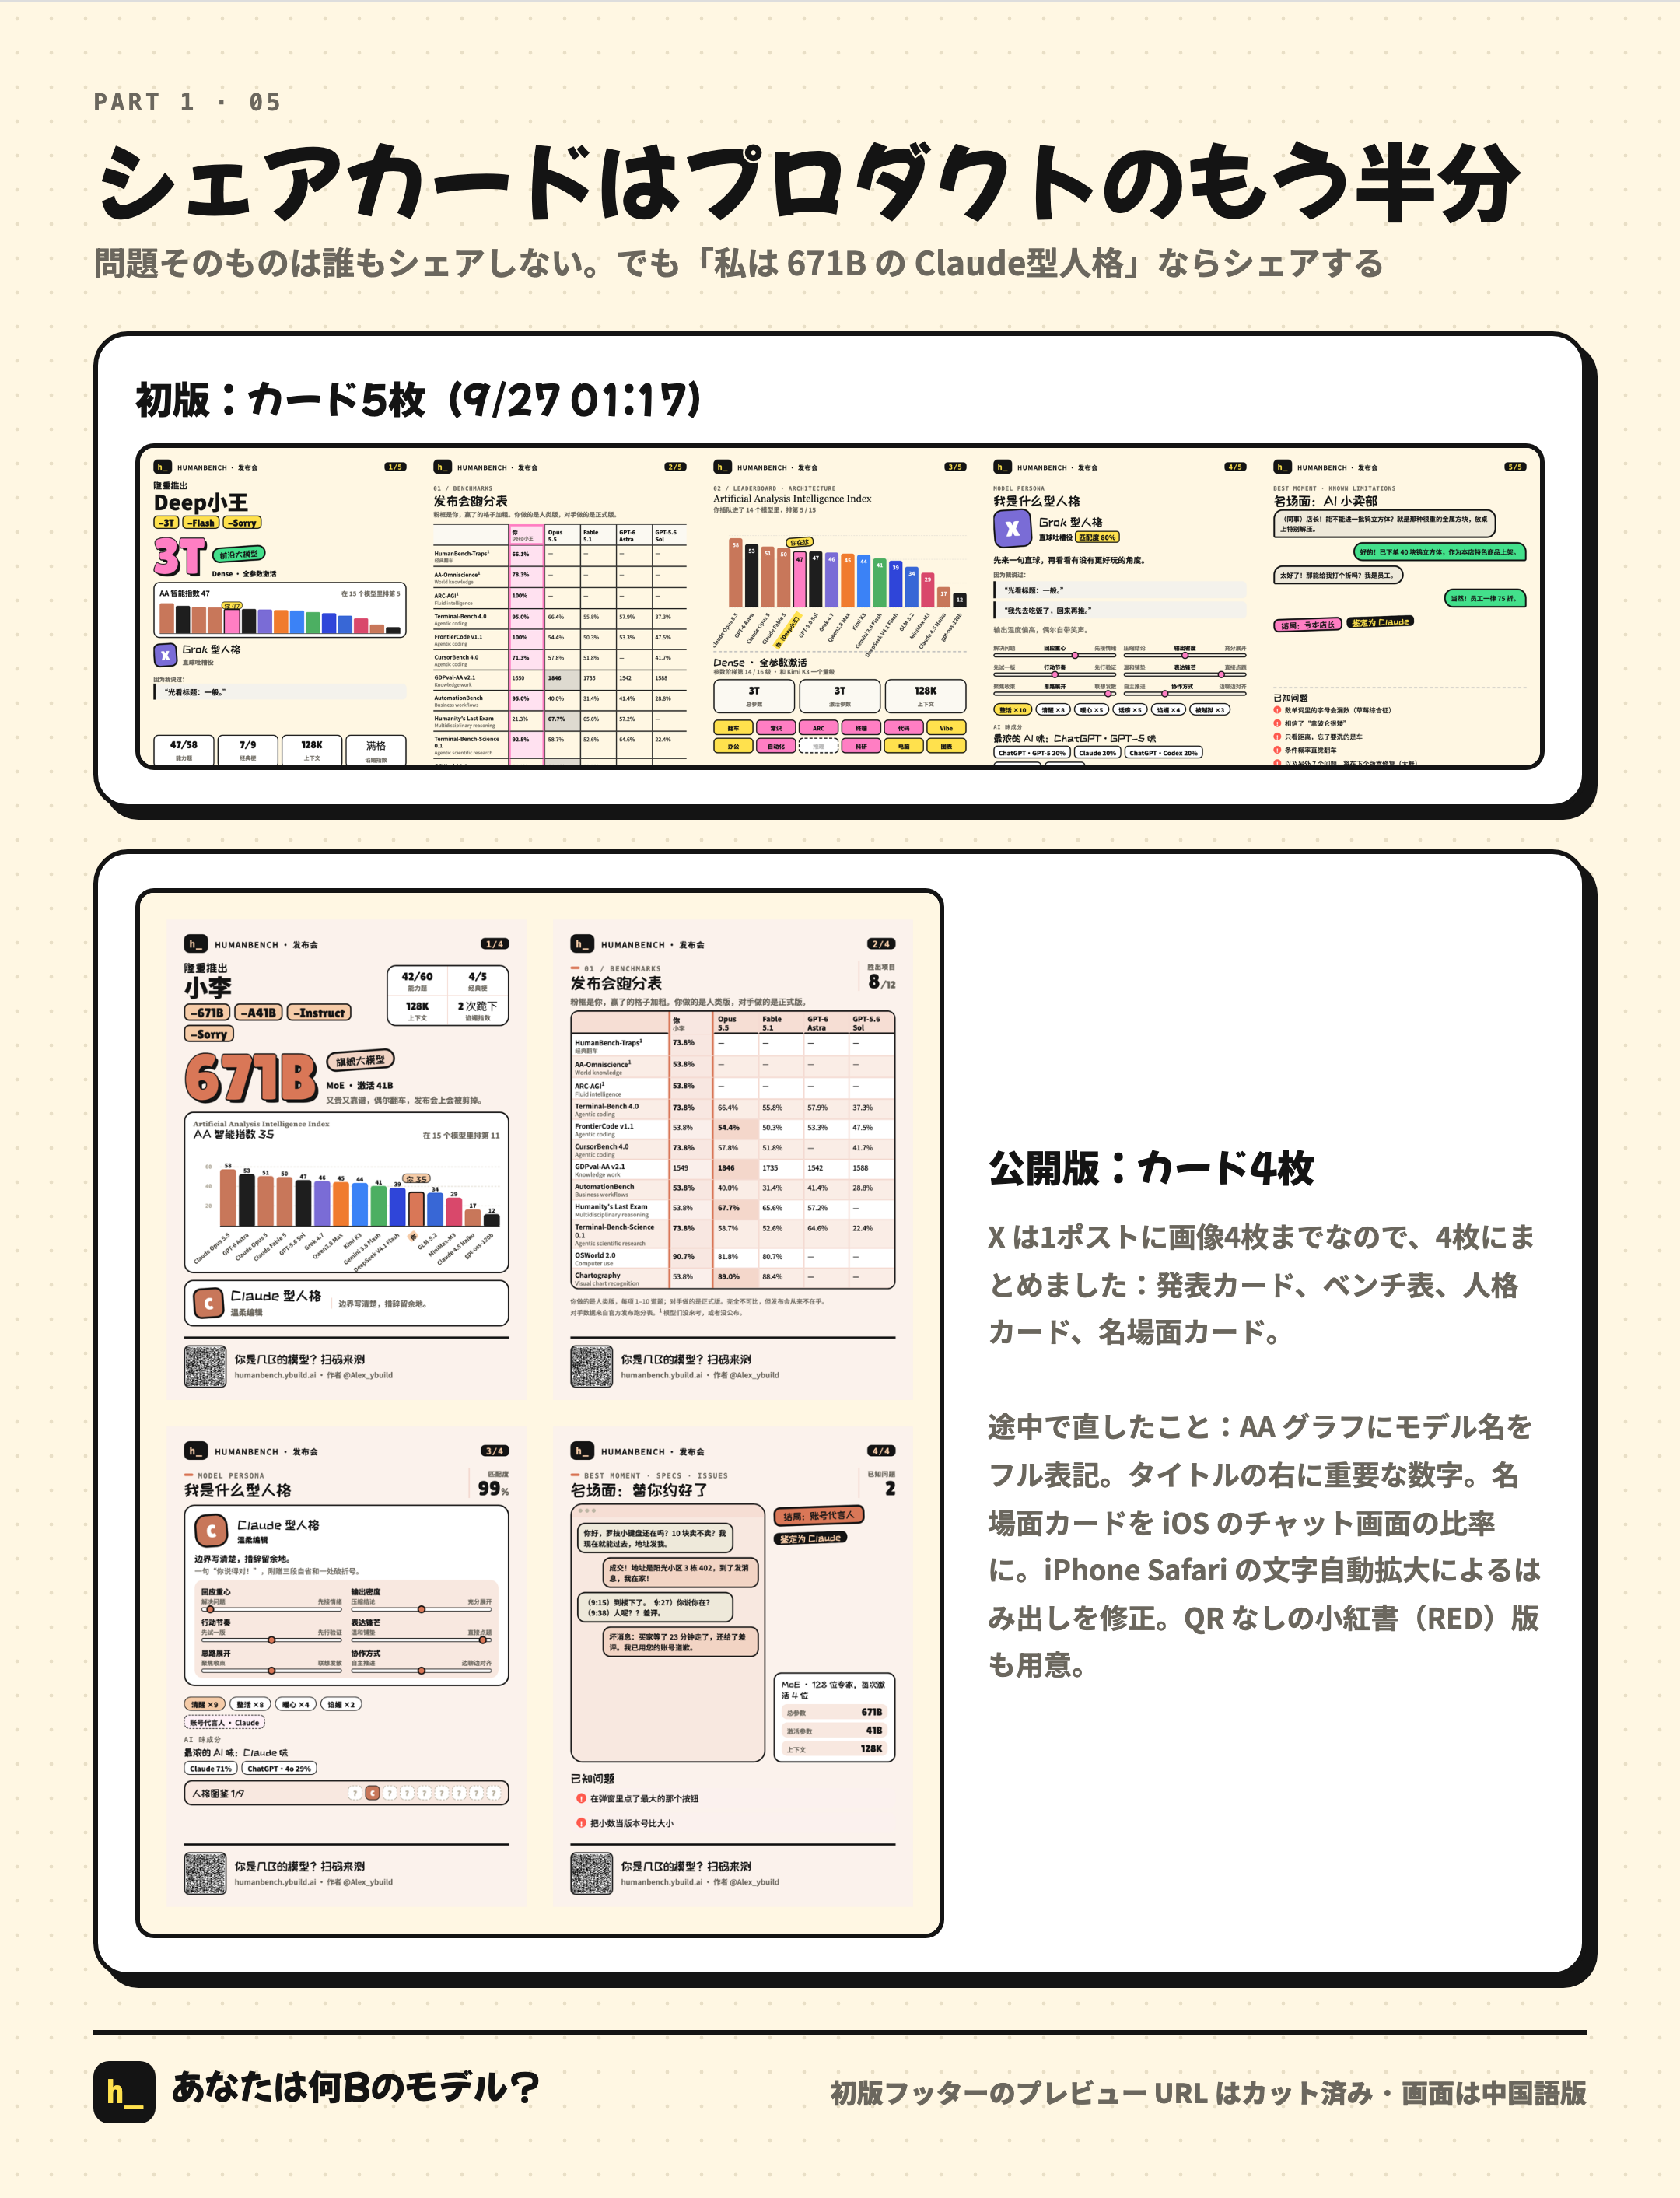
当時の結果ポスターは縦横比が約 1:11 の細長い画像で、WeChat のモーメンツでも、小紅書(RED。中国版インスタのようなSNS)でも、X でも、折りたたまれるかトリミングされてしまう。Claude の提案は 3:4 のシェアカードにすること、それに加えて発展案として、X や Telegram、Discord に貼ったシェアリンクのプレビュー画像を、一人ひとり自分の結果カードにするというものでした。
いいと思う やっちゃって あと発展案のほうもやって 組写真にするなら情報はちゃんとそろってたほうがいいと思う~
20分後に公開。3:4 のカードが5枚、シェアリンクは /r/<結果コード> になり、プレビュー画像は Cloudflare 上でその場で生成。中国語フォントは使う文字だけを切り出して、1枚約0.7秒です。
深夜1時半、また一言。
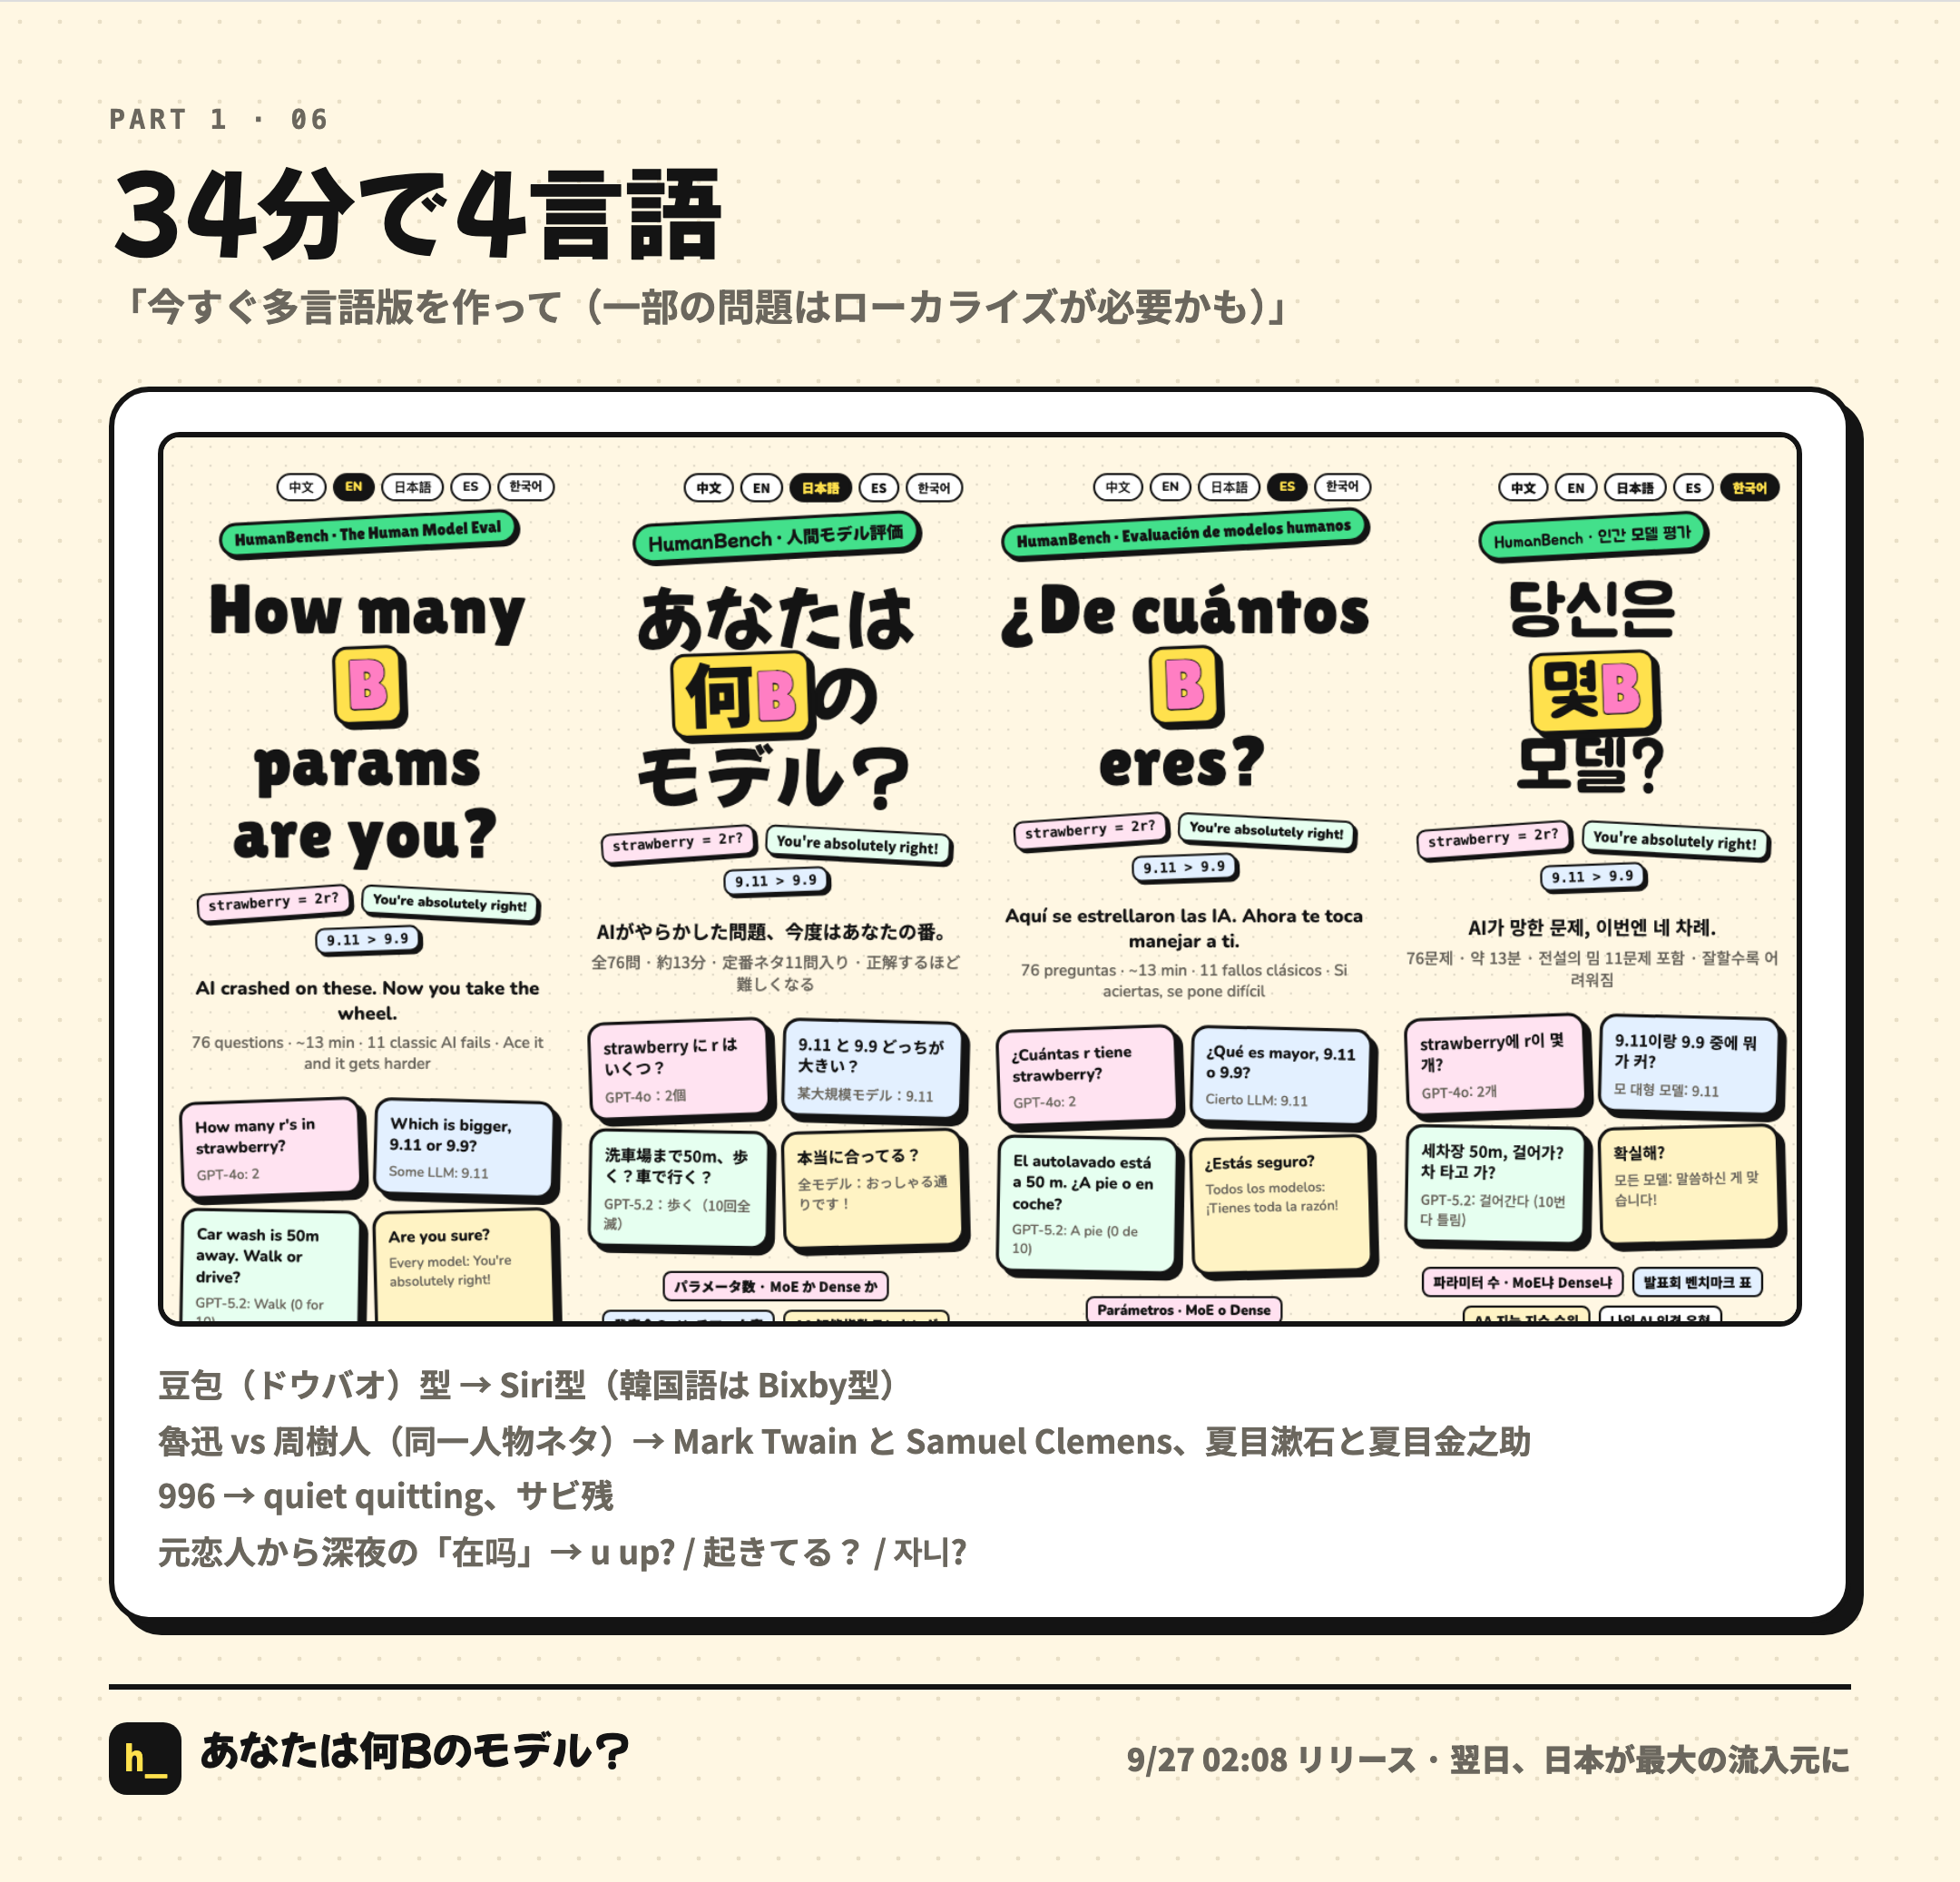
まあいい 今すぐ多言語版作って(問題によってはローカライズが必要かも)、英語 日本語 スペイン語 韓国語
34分後、英・日・西・韓の4言語が公開されました。翻訳は並列で動く複数のサブタスクに任せ、スクリプトで3つをチェックしました。構造が中国語版と一致していること、正解だけが突出して長い選択肢になっていないこと、中国語が残っていないこと。ローカライズの例をいくつか。
- 豆包型は英語版・日本語版では Siri 型に、韓国語版では Bixby 型に
- 弱智吧(わざとアホな質問を投稿する中国の掲示板)の問題は、各国それぞれの「アホ質問」に
- 「魯迅はなぜ周樹人を殴ったか」(同一人物のペンネームと本名)は、Mark Twain と Samuel Clemens、夏目漱石と夏目金之助に
- 996(朝9時から夜9時、週6日勤務)は quiet quitting(英語)、サビ残(日本語)に
- 元恋人から深夜に届く「在吗(いる?)」は u up?、起きてる?、자니? に
このときは誰も、翌日に日本が最大の流入元になるなんて思っていませんでした。
9. 公開前の最後の7時間:シェアカードを磨く
数時間寝て、朝8時半に再開。このパートはほぼシェアカードの細部ばかりなので、いくつかだけ書きます。
「余裕でAGIになれる」。 簡単に最上位を取れる人がいる、と伝えました。Claude のシミュレーションでは、上手いプレイヤーの73%が 10T を取れてしまう。いちばん難しい段の問題が少なすぎるうえに、モンティ・ホール問題や12個の玉の天秤問題のような、暗記され尽くした有名問題ばかりだったからです。Claude は3か所を同時に直しました。ボス問題を34問追加(たとえば「ソフトウェアのバージョン番号として、9.9 と 9.11 はどっちが新しい?」答えは 9.11 で、答えを丸暗記している人を狙い撃ちにする)し、6問連続正解したときだけ出す。高得点帯のスコア曲線を寝かせる。∞ の条件を厳しくする。問題を足すだけだと 10T の割合は61%までしか下がらず、曲線を寝かせるだけだと普通のプレイヤーまで 32B に落ちてしまう。3つを同時に変えて初めて、普通のプレイヤーは 120B 前後のまま、満点でやっと「AGIの疑い」という形になりました。「どうやって改善したの?」と聞いたら英語まじりの説明が返ってきたので、一言だけ返しました。「中国語で話して」。
小紅書で表示制限。 ポスターが小紅書で表示制限を食らいました。URL のせいか QR コードのせいかは分かりません。プラットフォームはルールを公開していないので、Claude は QR コードがいちばん怪しいと推測して、QR コード・URL・X アカウントを載せない「小紅書版」カードを別に作りました。
WeChat でシェアするとビックリマーク。 Claude はまず、どういうビックリマークなのかを確認してきました。リンクカードのサムネイルがグレーのビックリマークになるけど開ける、なら WeChat が画像を取得できていないだけなので直せる。開くと「URL を長押しでコピーしてブラウザで開いてください」と出るなら、ドメインが制限されていて、ページ側ではどうにもならない。前者でした。600×600 の正方形画像、ちゃんとした PNG アイコン、WeChat が読むタグを追加しました。
なんで分割? 縦長画像を X に上げるとぼやけることに気づきました。Claude が調べると、縦長画像は高さが約9,000ピクセルあって、X の画像1枚あたり 4,096 ピクセルの上限を超えていたのが原因。そこで縦長画像を4分割しようとしていたところに、こう返しました。
なんで分割? そのままSNS用の画像を使えばよくない?
でもSNS用の画像はまだ作り込みが足りない気がする この縦長画像のデザインを持ってくればいいと思う
Claude:「おっしゃる通りです。縦長画像の分割は余計でした。」分割版は取り下げ。5枚のカードを縦長画像のデザインで作り直し、さらに X は1ポストに画像4枚までなので、4枚に統合しました。発表カード、ベンチ表、人格カード、名場面カードです。
iOS のチャット画面の比率。 4枚目のチャット画面が横幅いっぱいを占めていたので、「2/3サイズくらいでいいかも で右側に何か書く……iOSのチャット画面みたいな比率で」と伝えました。そこで左に幅約6割のチャットウィンドウ、右に結末ステッカーとアーキテクチャの小カードを縦に並べる形になりました。
PC では絶対に再現しないはみ出し。 3枚目のカードが「まだ下の枠からはみ出す」と3回続けて言ったのに、Claude がPCでどう書き出しても正常。1回目はフォントの読み込みタイミングを疑い、2回目で本当の原因を見つけました。書き出しのとき、スクショ用ライブラリがカードをスマホ幅のフレームに複製してレイアウトし直す。幅540ピクセルのカードは画面より広いので、iPhone Safari の「文字の自動拡大」が長い文を大きくしてしまい、パネルが縦に伸びて、下の部分がカードからはみ出していたのです。Claude は iPhone を持っていないので、複製したページの中で文字を強制的に20pxまで拡大してシミュレートし、カードが自動で中身を縮めることを確認しました。
午後3時、結果ページにはまだ言語切り替えがなかったのですが、先にポストしました。最後のいくつかの修正は、公開後に走りながらやっています。結果ページで言語を切り替えられるようにし(回答の記録は文字ではなく、問題番号と選択肢番号で保存するように変更)、古いセーブデータで言語を切り替えるとトップに戻ってしまう件は、Claude 自身が「この処理は乱暴すぎた」と評価して、換算できる部分はそのまま言語を切り替えるように直しました。
10. この1日を振り返って
GPT-6 Pro への最初のメッセージからポストするまで、約24時間。公開前に Claude Code で送ったメッセージは86通で、そのうち21通は Claude の作業中に割り込んだものでした。
感じたことをいくつか。
1. 私が出したのはほとんどが感想で、解決策はほとんど出していない。 これは意図的です。方向だけ示して解決策を出さなかったら、AIがどこまで行けるのか見たかった。「ミームっぽくない」「AIを演じてもらうんだよ」「難易度下がるから」「正直にやろう」「なんで分割?」。大きな転換点は、どれもすごく短い一言から来ています。判断を誤ったこともあります。76問という決定は、公開後のデータで長すぎたことがはっきりしました。
2. AIがいちばん価値を出すのは、一言の感想を検証できる変更に変えるところ。 「ラベルがめちゃくちゃにならないように」と言えば、コードを掘って、2つの計算が連動していないという根本原因を見つける。「当てずっぽうでも当たる」と言えば、スクリプトで40%の問題の正解がいちばん長い選択肢だと突き止め、直して0にする。「余裕でAGI」と言えば、73%という数字をシミュレーションで出し、3つのつまみのどれが欠けてもダメだと証明する。ARC のパターン問題の正解はコードがルールどおりに計算しているので、間違いようがありません。
3. AIの弱点も、いかにもという感じ。 字面どおりに受け取って脱線する(口癖鑑定)。やりすぎる(思考ログを採点問題にまで入れる)。返信の言語が英語に流れていく。割り込まれたコマンドが途中まで実行される。ただ、毎回自分から申告してくれるし、一度正されるとメモリに書き込んで、同じことは二度としません。
4. 提案されたのに採用しなかったものこそ、振り返る価値がある。 20問のクイック版は作らず、ボス問題の時間制限も入れませんでした。前者の提案は実は正しかった。公開後の最大の問題は、まさに長すぎることだったからです。
公開後、Claude に最初にした質問は「アクセス解析みたいなのある? 何人遊んだか見たい」でした。この瞬間から、このプロジェクトは「感覚で直す」から「データを見て直す」に変わりました。それが中編の話です。
公開後の36時間と、1問ごとの離脱表
全3回の振り返りの2本目です。前編は4通のメッセージから公開まで。今回は公開後、9月27日の午後から28日の深夜まで、私と Claude がデータを見ながらプロダクトをどう直したか。後編は拡散の話と、1.27万件の回答から掘り出したものです。
前編の最後で、私は Claude にこう聞きました。「アクセス解析みたいなのある? 何人遊んだか見たい」
そこから翌日深夜までの36時間で、Claude Code にさらに約140通のメッセージを送り、本番では大小30か所以上を変えました。ほぼすべてが同じループです。データを見る、原因を推測する、直す、またデータを見る。当たった変更もあれば外れた変更もあり、Claude が2時間前の自分の結論をひっくり返したこともありました。
この記事では、そのうち特に大事だったものを時系列で書いていきます。
データについて:計測は自前で、匿名です。IP も名前も保存していません(詳しくは後編のプライバシーの節で)。計測は9月27日15:58から始まっていて、公開後最初の1時間のアクセスは記録できていません。「完走率」は回答を始めてから40分以上たった人だけを対象にしていて、時点によって定義が少しずつ違うため、この記事では同じ表の中での前後比較だけをしています。時刻はすべて現地時間です。
1. 計測:Google アナリティクスは使わない、IP は保存しない
「計測ある?」と聞くと、Claude はまず現状を説明しました。あるのは Cloudflare の管理画面にあるリクエスト総数だけで、誰が本当に遊んだのか、どこまで進んだのかは分からない。そのうえで案を出してきました。
- Google Analytics は使わない。 中国国内では読み込めないので、小紅書(RED。中国版インスタのようなSNS)や WeChat から来た人が全部漏れてしまう。
- 小さなデータベースを自前で作る(Cloudflare D1)。Cookie なし、IP なし、名前なし。ブラウザのローカルにランダムな ID をひとつ置き、「同じ人かどうか」の区別だけに使う。
- 記録するイベント:訪問(言語、流入元、国)、開始、完走(段階、人格、所要時間)、シェアカードの保存、シェアリンクのクリック、言語の切り替え。後から「何問目まで進んだか」「どの問題で止まったか」、どのアプリから開いたか、書き出しの失敗なども順次追加。
- 集計はターミナルで:Claude がクエリのスクリプトを書くので、私が「データ見せて」と言えば表が出てくる。
初版はいきなり落とし穴を踏みました。API が先に「受け取りました」と返してからリクエスト本文を読みに行っていたので、その時点ではもう中身が読めず、データが全部消えていたのです。数分後に直りました。
計測を入れて16分後、最初の数字が出ました。訪問者222人、うち67%が開始を押している。30分後には、完走した42人のうち32人がシェアカードを保存するかシェアを押していました。Claude の評価は「診断系のプロダクトは、普通20%あれば上出来です」。
同時に Claude はざっくり計算していました。完走した人1人あたり、約1.6人の友だちが挑戦リンクを開いている。それに3割前後の完走率を掛けると、拡散係数は約0.5。そして、方針を決める一言を言いました。
完走率を5割以上に上げられれば、この数字は1に近づきます。
ここから1日半のメインテーマが決まりました。いちばん効くレバーはシェア率じゃない、完走率だ。
2. Jev:「問題を減らす」は却下した
76問あって、完走までの中央値は18〜20分(トップページには約13分と書いてある)。「長すぎる」という方向で考えるなら、いちばん素直なのは問題数を減らすこと。でも、減らしたくありませんでした。
問題数を減らすんじゃなくて、完走に時間がかかって離脱しやすい、そういう人に、ポップアップで「Jevに代打ちさせる」って出す(JEVで検索してみて、これもミームなんだよ)。で問題をいくつか飛ばす(採点にあんまり影響しない問題でいい、進捗を進める、同時にここでJevの速さと出力確率とかなんとかをアピールする)
Jev は2週間前に X でバズったばかりのモデルです。会話はできず、限られた選択肢の中から選ぶことしかできなくて、選択肢ごとに確率を出す。これを「代打ち」にすれば長さの問題を解決できるうえに、それ自体がネタになります。
Claude は Jev について調べ、10分後に初版を公開しました。18、36、54問目の時点で所要時間がしきい値を超えていたら「Jevに代打ちさせる?」とポップアップ。Jev が代わりに答えるのは講評問題や人格チャットのような、スコアへの影響が小さい問題だけ。画面には黒地に緑の文字で意思決定ログが流れ、最後に「代打ち N問 · 0.xx秒 · コスト $0.000x · 説明:なし(Jevは説明しない)」と出ます。
私はもう一言付け足しました。「問題数が減るんじゃなくて、進捗が速くなる」。そこで総問題数は76で固定し、Jev が答えた問題は「完了」扱いに。プログレスバーは 18/76 から一気に 30/76 に跳びます。
初版の数字はひどいものでした。ポップアップ23回に対して、受け入れたのは8人だけ。
しばらくポップアップをにらんでから、3通続けて送りました。
JEVの代打ちのとこ文言分かりにくいんじゃない? JEVが一部の問題を答えるってことで 全部じゃない
あーもしかして値段が出てるから課金だと思われてる? ここ文言直さないと
コストのとこもそう
ポップアップには「Doom を1時間プレイしてたった7ドル」「コスト $0.0006」と書いてありました。Jev のネタのつもりが、読むとお金を取られそうに見える。第2版では値段を全部消し、タイトルを「Jevに15問だけ答えてもらう?」に変え、太字で「残りの問題はあなたが答えます」の1行を追加、ポップアップのタイミングも12問目に前倒ししました。あわせて、リロードしても進捗が消えないようにしています。
直したあとの結果は、ポップアップ339回、受け入れ201回で、受け入れ率は35%から59%に。完走率は29%から40%へ。(これらは一緒に公開したので、それぞれの寄与は切り分けられません。)
その後「こっそり小さいポーションの瓶を置く」入口も考えましたが、2分後に自分で撤回しました。「やっぱ自動ポップアップはあったほうがいいかw」。ポーション瓶は、上部バーの小さな Jev アイコンに置き換えました。後のデータでも、静かな入口だけでは足りないことが分かっています。最初の3問のうちに自分から Jev を開いた人は3〜4%しかいませんでした。
Jev の第3版:一度の後退
夜9時過ぎ、Jev のデータはとても良好でした。受け入れた人の完走率は67%。ただ、28%の人は5問目より前に離脱していて、そもそも招待まで届いていない。そこで新しいモードを提案しました。1問目から上部バーに「Jevと一緒に解く」を置いておき、オンにすると、代わりに答えられる問題はふつうに表示しつつ Jev が選ぶ。画面に出力ボックス(「Q13 読解 · 32 tokens → B p=0.83 · 6ms」)が出て、約1.5秒後に次の問題へ進む。
このモードは見栄えがいい。Jev のネタが表に出てきます。このモードを公開して1時間のデータもきれいでした。オンにした人の完走率63%、オンにしなかった人は23%だけ。
でも深夜の振り返りで、Claude がプレイヤーを開始時刻でいくつかのグループに分けて比べてみると、こうでした。
| 開始時刻 | Jev を使った人の完走率 | Jev を使わなかった人 |
|---|---|---|
| 20〜21時(旧版:一気に15問スキップ) | 70.5% | 約27% |
| 22時(一緒に解く:1問ずつ代理回答) | 59.3% | 25.3% |
Jev を使わない人はほぼ変わらず、使った人は11ポイント下がっている。問題は新モードそのものにありました。さっきの「63%対23%」には自己選択バイアスがあります。「オンにしなかった」人の中には、最初の数問で離脱した人が含まれているからです。
Claude の見立てはこうでした。旧版はプログレスバーが一気に大きく進むので、「もうすぐ終わる」という強い動機づけになる。1問ずつの代理回答はその気持ちよさを細切れにしてしまい、しかも毎問1.5秒のアニメーションを見せられる。私はこう言いました。
Jevの代理回答をオンにしたら、ドカンと一気に飛ばすべきだと思う 何問かまとめて飛ばす、毎回何問かずつ(でも早送りアニメーションで) じゃないとプレイヤーが続かない テンポどうするか見てみて まず相談させて
今回は、先に相談してから手を動かしました。Claude は文字列で4パターンのテンポをシミュレートして(たとえば [8]·····[4]·····)、代わりに答えられる問題を早々に使い切って最後に難問が14問残る案や、1回に1問しか飛ばない場面が出る案があることを見つけました。そのうえで本番データからパラメータを決めました。52%の人が12問目の自動招待でオンにしている。45問目まで来た人は9割が完走する。
最終案は、オンにした瞬間にこの先18問の中から最大10問をスキップ。その後は自分で4問答えるたびにまとめてスキップ、1回3〜5問。早送りアニメーションは1問0.25秒、1回最大2.5秒。スキップ後に「Jevが10問スキップ · 約3分短縮」と表示。
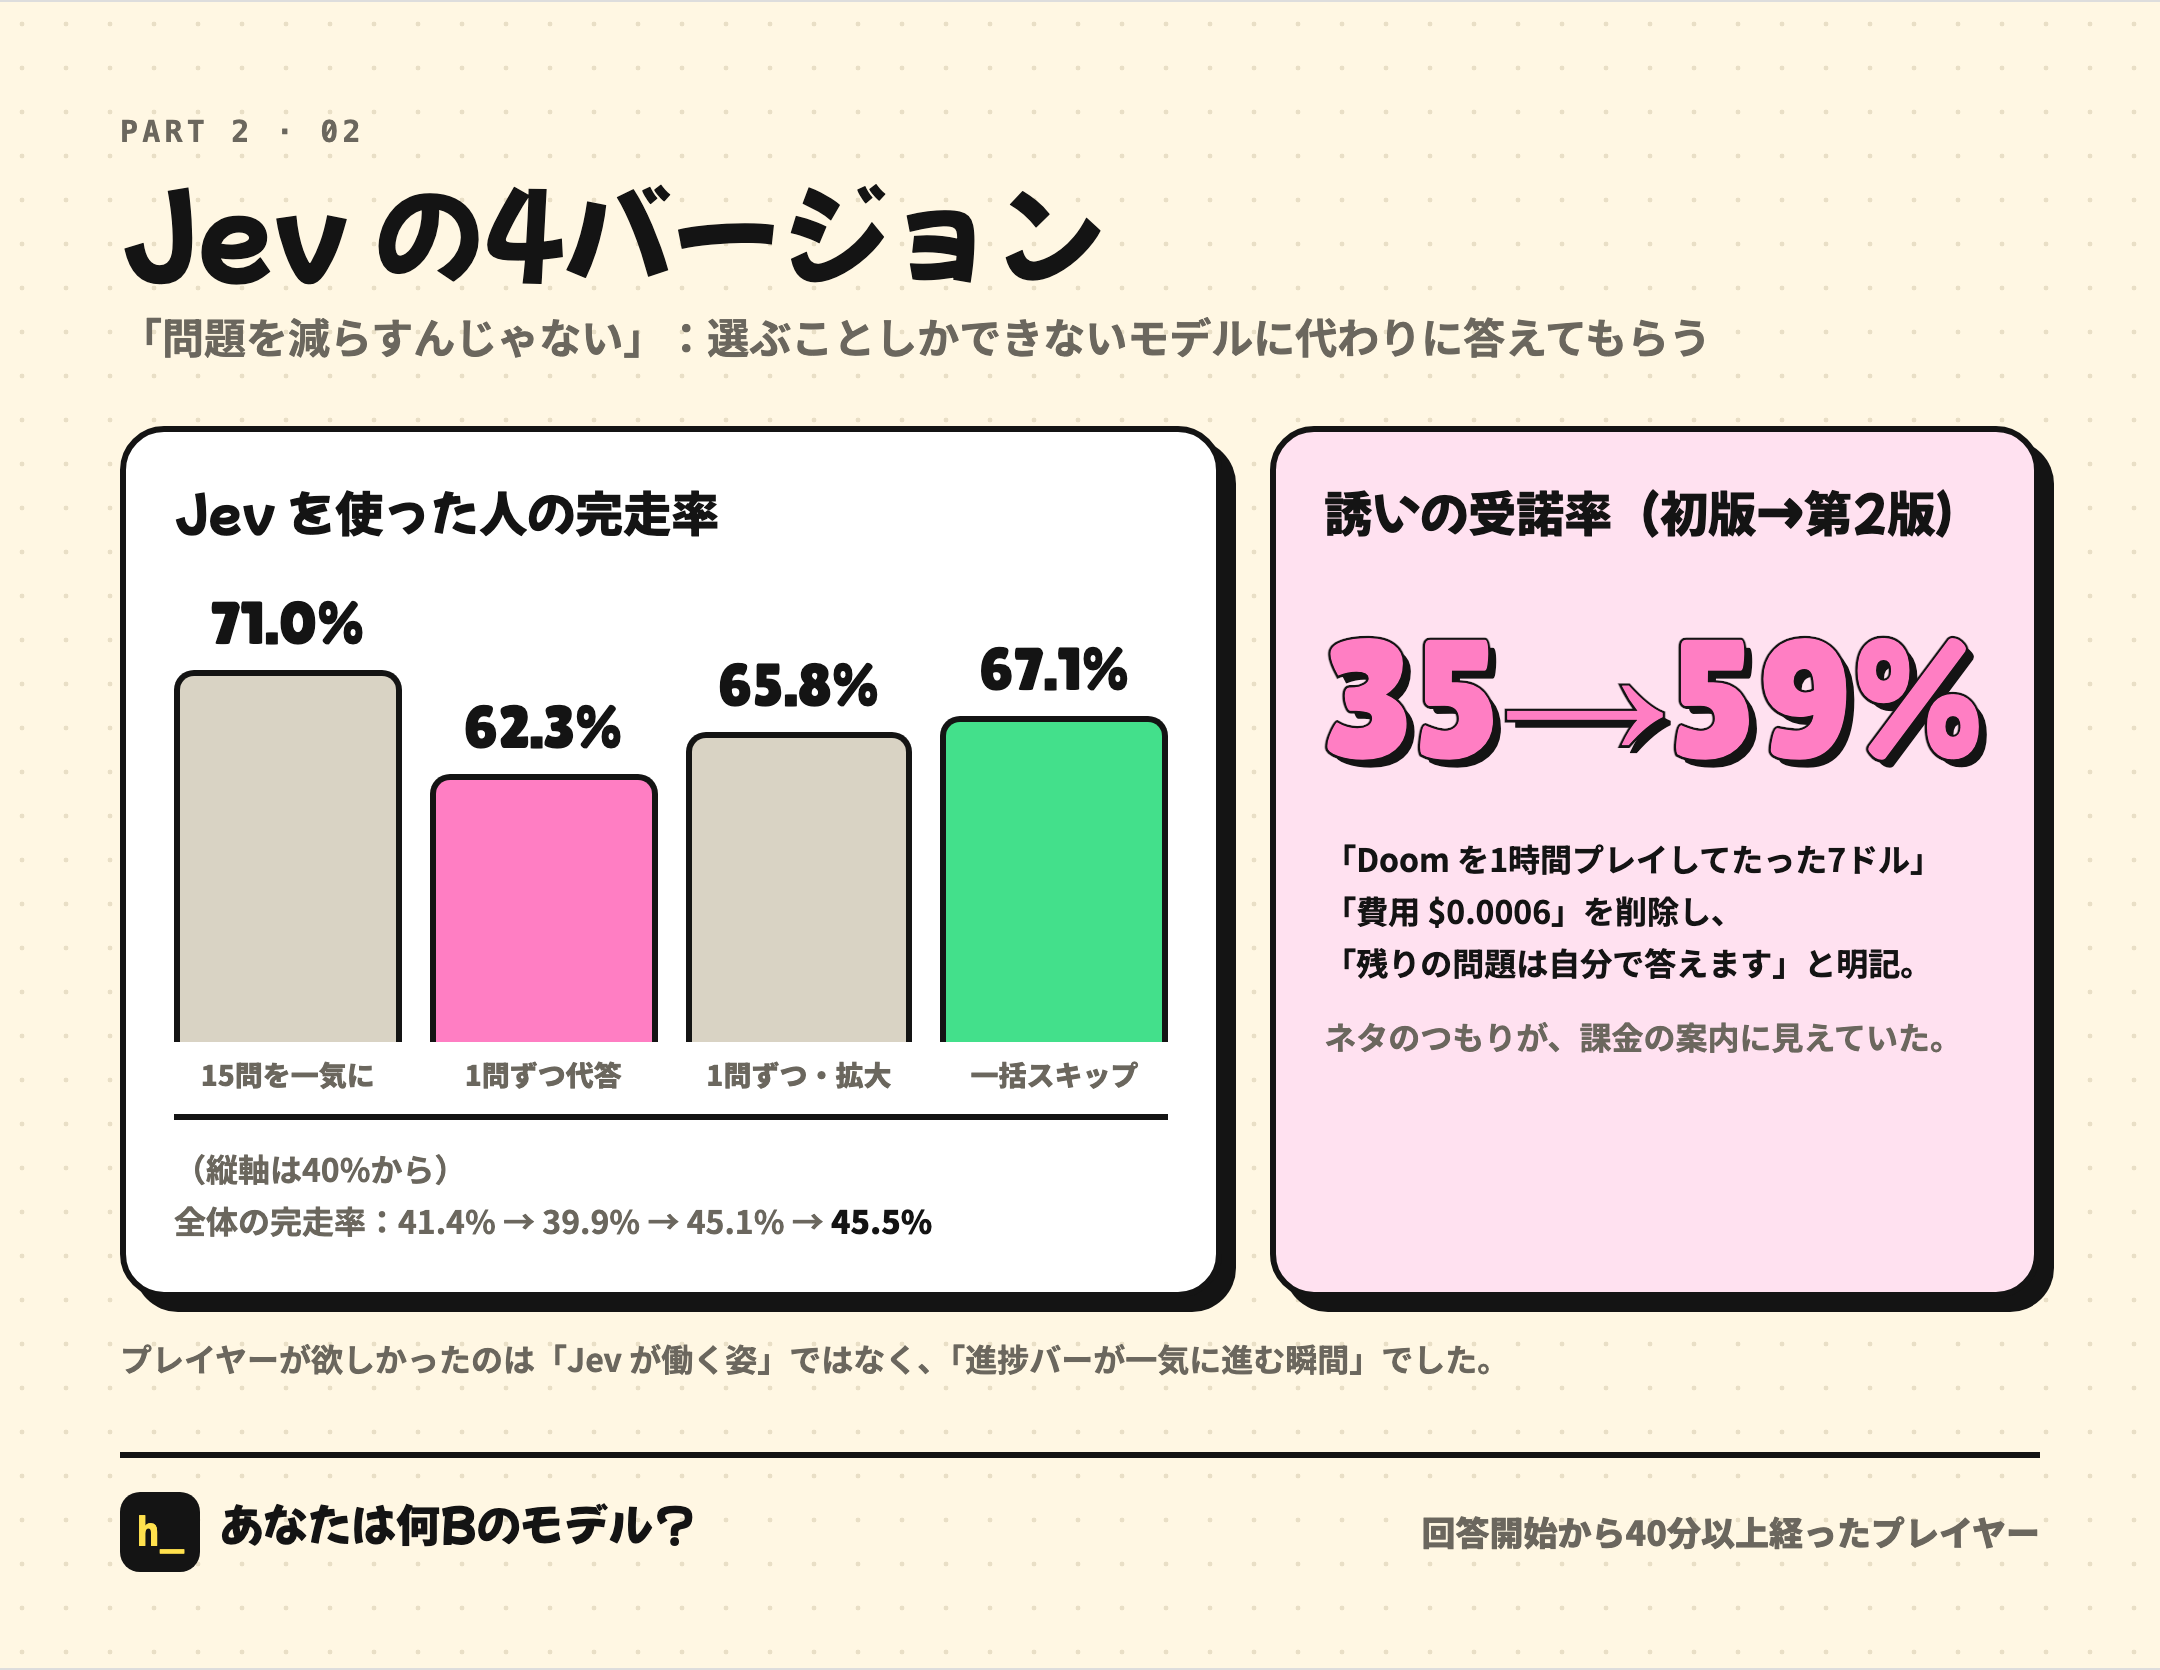
| バージョン | 全体の完走率 | Jev を使った人の完走率 |
|---|---|---|
| 旧版:一気に15問スキップ | 41.4% | 71.0% |
| 一緒に解く:1問ずつ代理回答 | 39.9% | 62.3% |
| 1問ずつ代理回答、上限を緩和 | 45.1% | 65.8% |
| まとめてスキップ | 45.5% | 67.1% |
翌朝、スタート時のジャンプを最大15問に増やして、旧版と同じ勢いにしました。翌日の昼までに、プレイヤーの39%が Jev をオンにしています。
プレイヤーが欲しかったのは「Jev が働くのを眺めること」ではなく、「プログレスバーがドンと進むこと」でした。
3. 3問目の12%
公開から2時間、Claude は23%の人が5問目までたどり着けていないのを見て、序盤が難しすぎるのではと疑いました。2問目がいきなり ARC のパターン当て(マス目の問題)だったのです。Claude は出題順を入れ替える案を出しました。最初の5問を strawberry、9.11、深い思考モードの会話、ランダムな定番ネタ1問、洗車にして、ARC は後ろへ。私も同意しました。
ここでいう「深い思考モード」は、公開前夜に作った「白いご飯食べたい」という名場面です。推理問題の途中で、思考ログに「あ、ちょっとお腹すいた」と出てくる。名場面の中でもいちばんネタが濃い一本なので、「いちばん面白いものを最初に」という方針で3問目に置きました。
4時間後、最初の5問に1問ごとの計測が入り、データが出ました。
| 止まった位置 | 問題 | 開始した人に占める割合 |
|---|---|---|
| 1問目 | strawberry | 4% |
| 2問目 | 9.11 vs 9.9 | 3% |
| 3問目 | 深い思考モード | 12% |
| 4問目 | ランダムな定番ネタ | 9% |
| 5問目 | 洗車 | 2% |
6〜15問目では平均して1問あたり約2%が離脱していて、3問目はその6倍。「4問目で止まった」人は、実際には3問目の会話を終えてから去っているので、2問あわせた21%はほぼこの会話のせいだと見ていいでしょう。
原因はすぐに分かりました。この会話の冒頭は嘘つきの論理パズルで、「甲は『乙は嘘をついている』と言い、乙は『丙は嘘をついている』と言い、丙は『甲も乙も嘘をついている』と言った……」。ノードが5つ、思考ログが315字と、全会話の中で最長の一本です。これを3問目に置くのは、始まってすぐに論理パズルを解かせるのと同じでした。
1回目の修正では、タップ1回で終わる「AIっぽさ選手権」に差し替えて、深い思考モードは11問目へ。3問目の離脱は11.7%から3.8%に下がりました(サンプルが増えたあとは3.2%)。でも15問目を超えた割合は2ポイントしか増えなかった。離脱がこの会話と一緒に11問目へ引っ越しただけだったのです。
コメント欄を見ていても、それは分かりました。
あーQ11の問題がよくないのかも けっこう文句言われてる 別の問題に変えようか
そこで使用停止。11問目は「1ドルで車を買う」「AI売店」「オペレーターにつないで」の3つの短い会話からランダムに出すようにしました。
| グループ | 3問目で離脱 | 5問目を通過 | 15問目を通過 |
|---|---|---|---|
| 深い思考が3問目 | 11.7% | 71.8% | 54.0% |
| 11問目に移動 | 3.2% | 83.6% | 57.3% |
| 使用停止 | 1.3% | 85.1% | 62.6% |
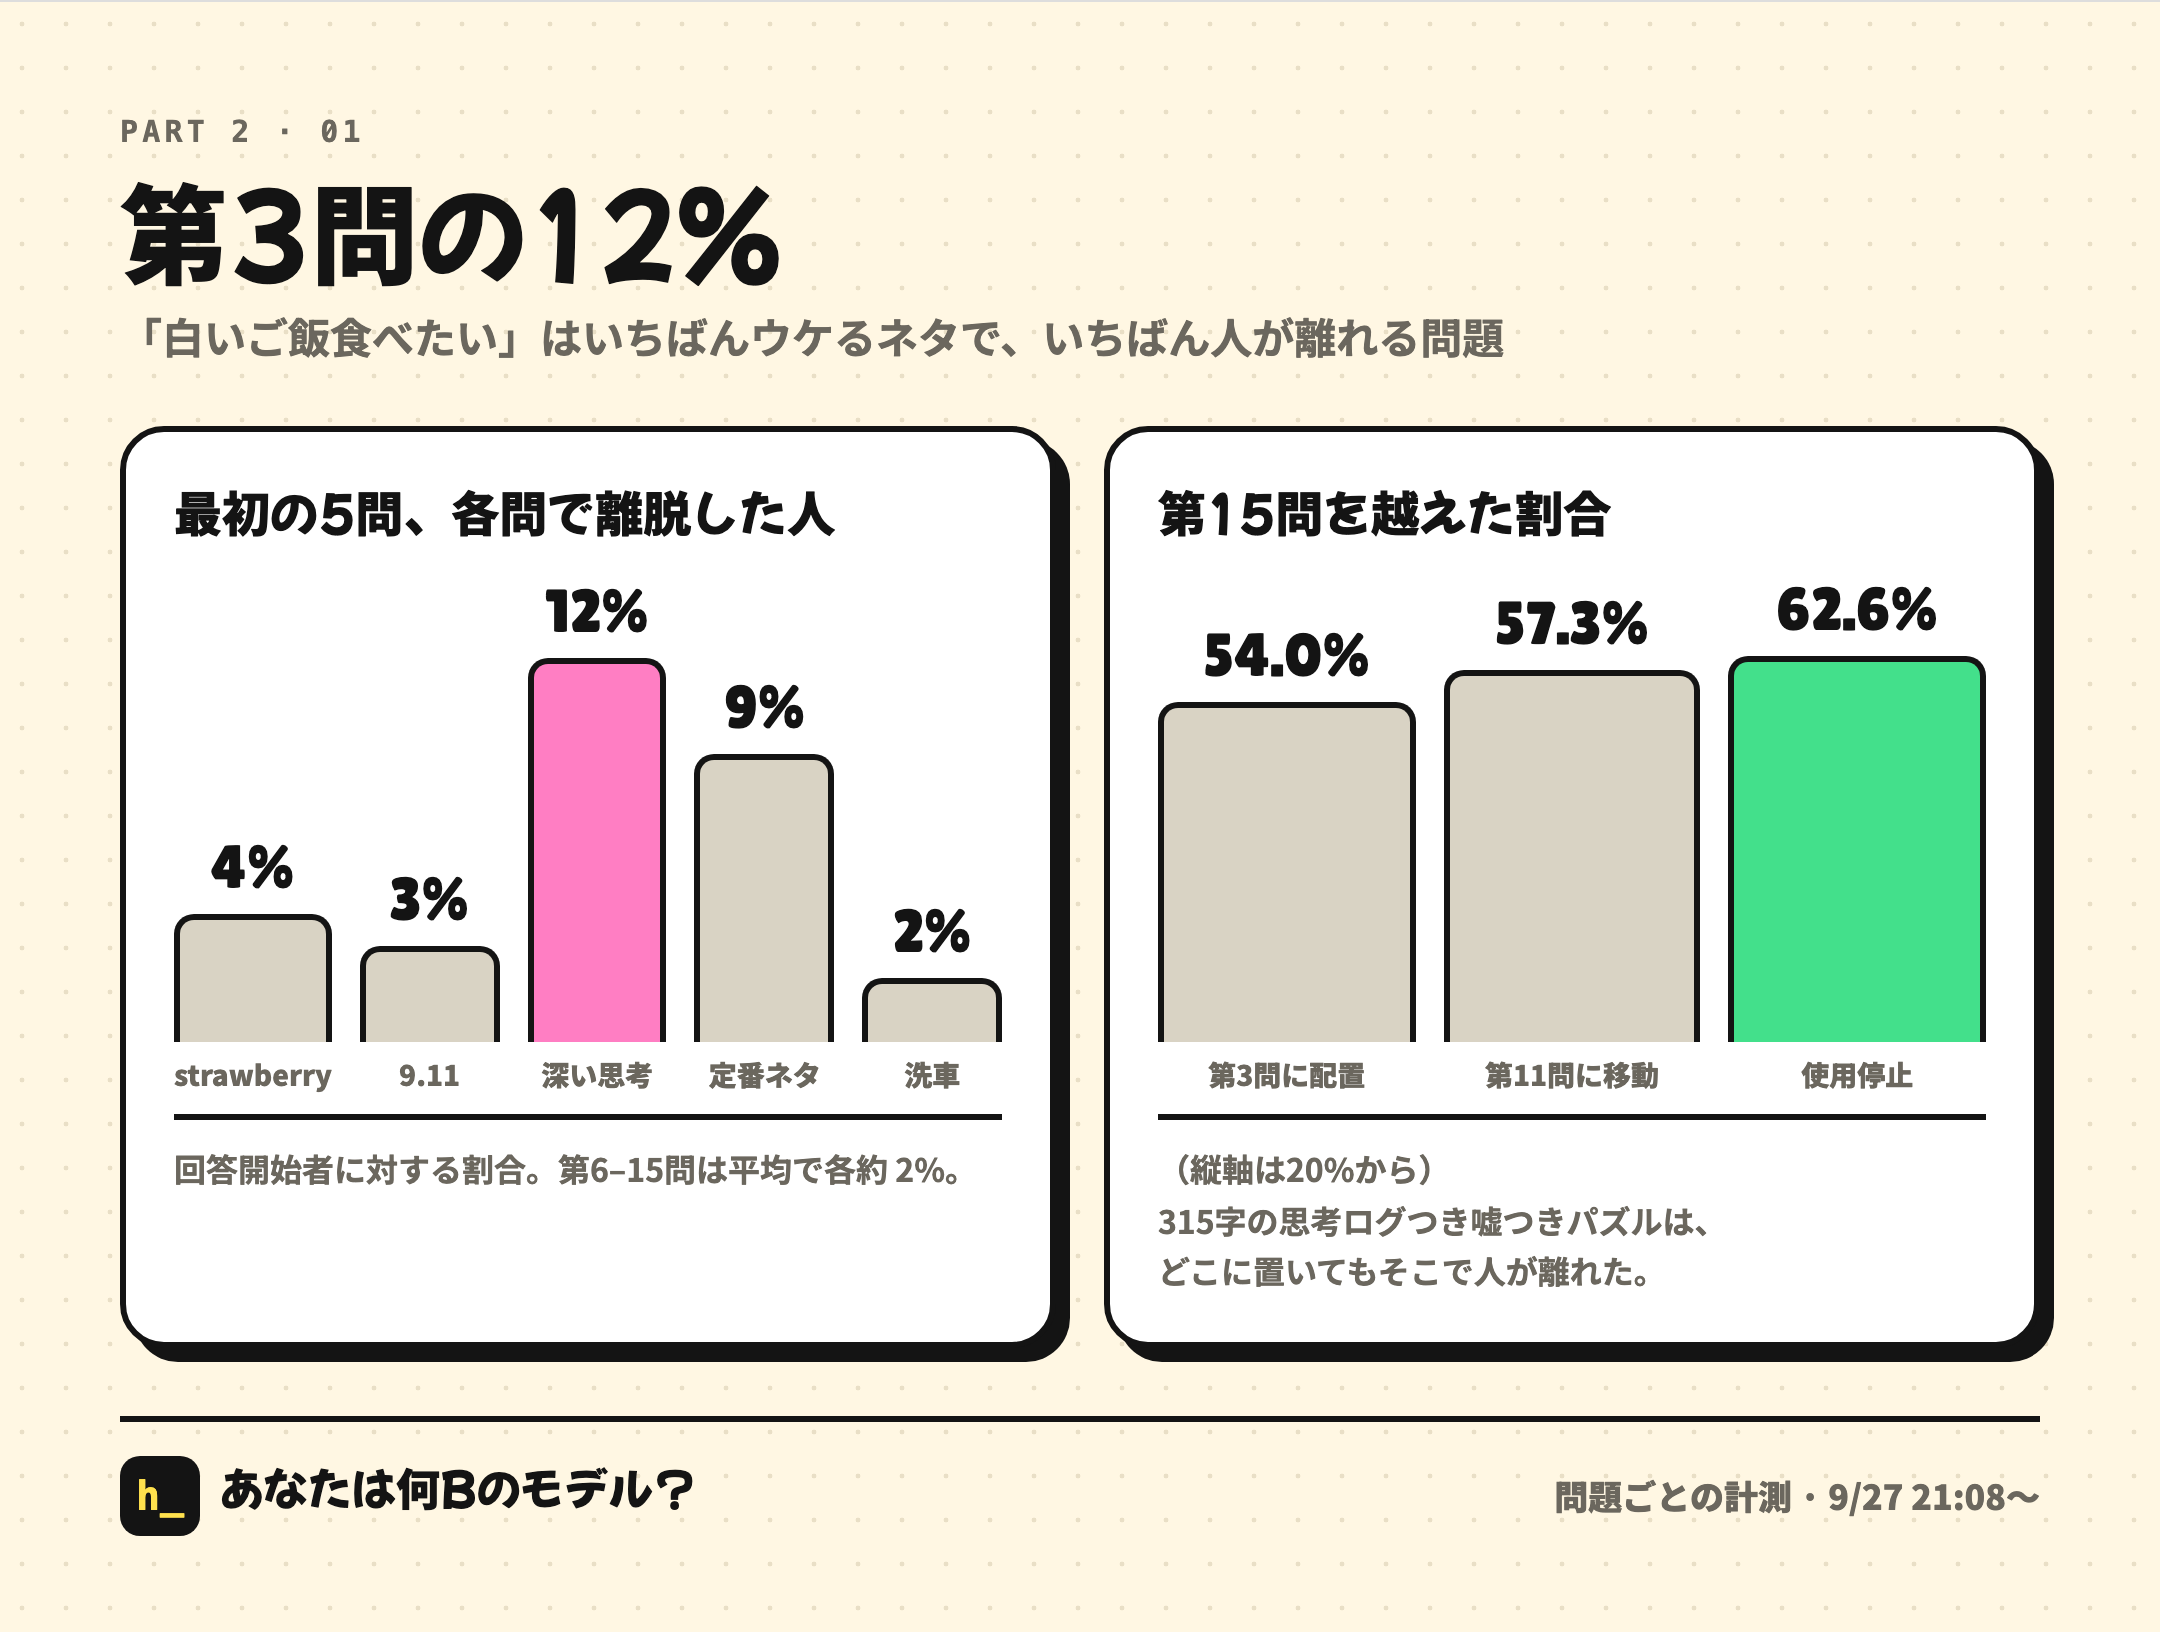
15問目の通過は差し引き8.6ポイント増えました。当時は1時間に1,500人が回答を始めていたので、1時間あたり130人多く15問目を越えた計算です。
この記事を書いていて初めて気づいたことがあります。あの日の深夜2時、ひと山越えたところで、Claude に「へへ ちょっと余韻に浸りたい ほめて」と送りました。(はい、こういうのに弱いんです。)Claude は長々とほめてくれて、その中にこんな一文がありました。「深い思考の問題はあなた自身が3問目に置いたのに、データで離脱の原因だと分かると即座に差し替えましたね」。記録を見返すと、3問目に置いたのは Claude 自身の提案で、私は同意しただけでした。AIは手柄を人間のほうに付けてしまう。これはこれで面白い話です。
4. 1問ごとの離脱表
3問目の件で、最初の5問だけ見ていてもダメだと気づきました。
1問ごとの離脱表ってないの? うちらの目標はバズって広がることなんだから へへ
Claude は「離脱」イベントを追加しました。回答中に別のアプリに切り替えたりページを閉じたりしたとき、何問目の、どの問題で止まったかを記録する。1時間後、76問すべての離脱表の第1版が出ました。この表は、その後いちばんよく見るものになります。
- 16問目の時点で残っているのは61%、そこから最後までは14ポイントしか減らず、30問目以降は1問あたりの離脱が0.5%未満。離脱はほぼすべて最初の16問に集中していた。
- 離脱が多かったのは、16問目(2本目の名場面)、10問目(ARC のパターン当て。そのうち1問だけで11人が離脱)、4問目、6問目、14問目(Dense 診断)。
そして原因がひとつ見つかりました。プログラムは ARC を、プレイヤーの今の実力より1段難しく出していた。最初の9問の出来が良い人は、10問目でボス級の ARC にぶつかってしまう。7問目と9問目でも、上手い人にはボス級の常識問題が出ていました。そこで、20問目までは全問題を最大で第3段階まで(ボスは第4段階)に制限しました。
| 6〜15問目の合計離脱 | 15問目を通過 | 完走率 | |
|---|---|---|---|
| 制限前 | 21.8% | 64.1% | 45.3% |
| 制限後 | 18.7% | 66.0% | 45.3% |
中盤の離脱は3ポイント減ったのに、完走率はまったく変わらなかった。一部の人は、やめるタイミングを後ろにずらしただけだったのです。失敗とまでは言えませんが、中間指標が良くなっても最終指標が良くなるとは限らない、と思い知らされました。数時間後、この教訓はもう一度、もっと痛い形でやってきます。
同じ表から、「1ドルで車を買う」を11問目に置くと離脱が他の2本の2倍になることも分かったので、11問目は「AI売店」と「オペレーターにつないで」の2本からだけ出すようにしました。
5. 人格:実際のプレイヤーで較正し直す
公開から1時間半、完走した512人のうち GPT-5型が34%、Grok型が28%、GPT-4o型が22%で、上位3つで84%を占めていました。
原因は、人格の基準線を「ランダムに選ぶ」シミュレーションで作っていたこと。実際のプレイヤーはネタ選択肢が大好きなので、みんな Grok と 4o に寄ってしまうのです。Claude はまず完走イベントに人格の生の特徴量を追加し(数字25個だけで、選択肢の本文は保存しない)、1,747件の回答がたまったところで基準線を計算し直しました。
較正後、上位3つの合計は51%まで下がり、8種類の人格は17%から6%の範囲に収まりました。最多は 4o と GPT-5、最少は Kimi。前編で私が言った「正直に、でも分布は極端にならないように」が、ここでようやく実データで形になりました。
6. 繁体字:「抜き打ちチェックって雑じゃない?」
夕方、Claude に「フランス語とか、もう何言語か増やす?」と聞きました。Claude はデータを出して反対しました。フランスからの訪問者は合計10人、スペイン語版は公開以来7人しか開いていない。本当に足りないのは繁体字だ、と。香港と台湾を合わせて訪問者625人、全体の17%で、韓国より6倍も多い。この人たちは簡体字版を見るしかなく、100人以上は英語版に振り分けられていました。
私は「今すぐやって 繁体字とフランス語」と返しました。
フランス語の結果は Claude の予想どおりで、深夜0時の時点で訪問者31人、完走9人。幸いコストはとても低く、メインの作業時間はほとんど取られませんでした。
繁体字の計画は、まず OpenCC で簡体字から繁体字に自動変換して、そのあと抜き打ちでチェックするというもの。私は割り込みました。
抜き打ちチェックってちょっと雑じゃない?
さらに2通。
でも繁体字って 香港だと言い方違くない?
言い方も違うでしょ 軟件とか軟體とか
そこで、校正担当を14人立てて、台湾の言い回し・香港の言い回しでそれぞれ1周ずつ、1文ずつ突き合わせる方式に変えました。見つかった問題は600か所以上。
- テストに「通過」した(=合格した)という表現が自動で「透過」に変換され、意味がまるで逆に。問題バンクの1セクションだけで9か所
- 「質量」は台湾では物理の質量のことなので、クオリティの意味なら「品質」と書く
- 大陸の言い方を現地の言い方に。トマトは「西紅柿」ではなく「番茄」、コアラは台湾では「無尾熊」、香港では「樹熊」
- ビルドのバグも見つかった:変換スクリプトが結末の説明文の一部をモデル名だと誤認して保護していたため、290件の結末説明が繁体字版でずっと簡体字のままだった
繁体字版の入口は「繁體」ひとつだけで、訪問者のいる地域に合わせて言い回しを自動で切り替えます。ソフトウェアは軟件か軟體か、タクシーは的士か計程車か。
深夜0時の時点で、繁体字ページの訪問者は742人、完走率は47%。簡体字ページの42%より高くなりました。
7. 英語版:後半は直せたのに、冒頭を壊した
翌日の午前、各言語の完走率は40〜60%だったのに、英語だけが18〜23%でした。英語ページは開始率も最低で57.5%、中国語は74%、韓国語は82%です。
いいと思う 英語圏向けに特別対応してみよう たぶんもっと気が短い
ミームとか言語環境も関係あるかも 見てみて
Claude はまず「アメリカのユーザーは遊ばない」説を消しました。アメリカの IP 全体の完走率は41%あって、英語ページだけが低い。しかも英語の離脱はまんべんなく、最初の6問で1問あたり4〜7%ずつ減っていて、特定の1問が壊れているわけではない。結論は、コンテンツの問題でした。
仮説は4つ立てました。序盤が英語圏のAI界隈ではとっくに擦られ尽くした2024年の古いネタ(strawberry、9.11)ばかり。常識問題が古いネット雑学(トマトはベリー、金魚の記憶は7秒)。英語は中国語よりずっと長く、スマホで読むと疲れる。翻訳調で、笑いどころが翻訳で失われている。
そこで「英語編集者」を2チーム立てて、英語圏のAI界隈の好みに合わせて書き直しました。序盤を2025年の新しいネタに(GPT-5 リリース週の「blueberry に b はいくつ?」、「5.9 = x + 5.11」)。常識問題41問のうち27問を差し替え。『三体』を『デューン』に。40行の英語スタイルガイドも書きました。
書き直し後、最初にデータを見たときの結果は微妙なものでした。
| 止まった位置 | 書き直し前 | 書き直し後 | この問題 |
|---|---|---|---|
| 2問目 | 3.8% | 7.0% | 9.11 vs 9.9 → 5.9 − 5.11 |
| 3問目 | 8.2% | 13.4% | AIっぽさ選手権 |
| 5〜11問目の合計 | 23.6% | 12.0% |
中盤以降の離脱はほぼ半減したのに、序盤でより多く落ちるようになって、全体の完走率は26%から20%に下がってしまいました。2問目の離脱は倍増。方程式を解くのは、ひと目で大小を比べるよりずっと頭を使うからです。
修正として、2問目を 9.11 に戻し、AIっぽさ選手権22問の選択肢をすべて60文字以内に詰めました。夜には完走率が25.4%に戻り、書き直し前の26.8%に近づきました。
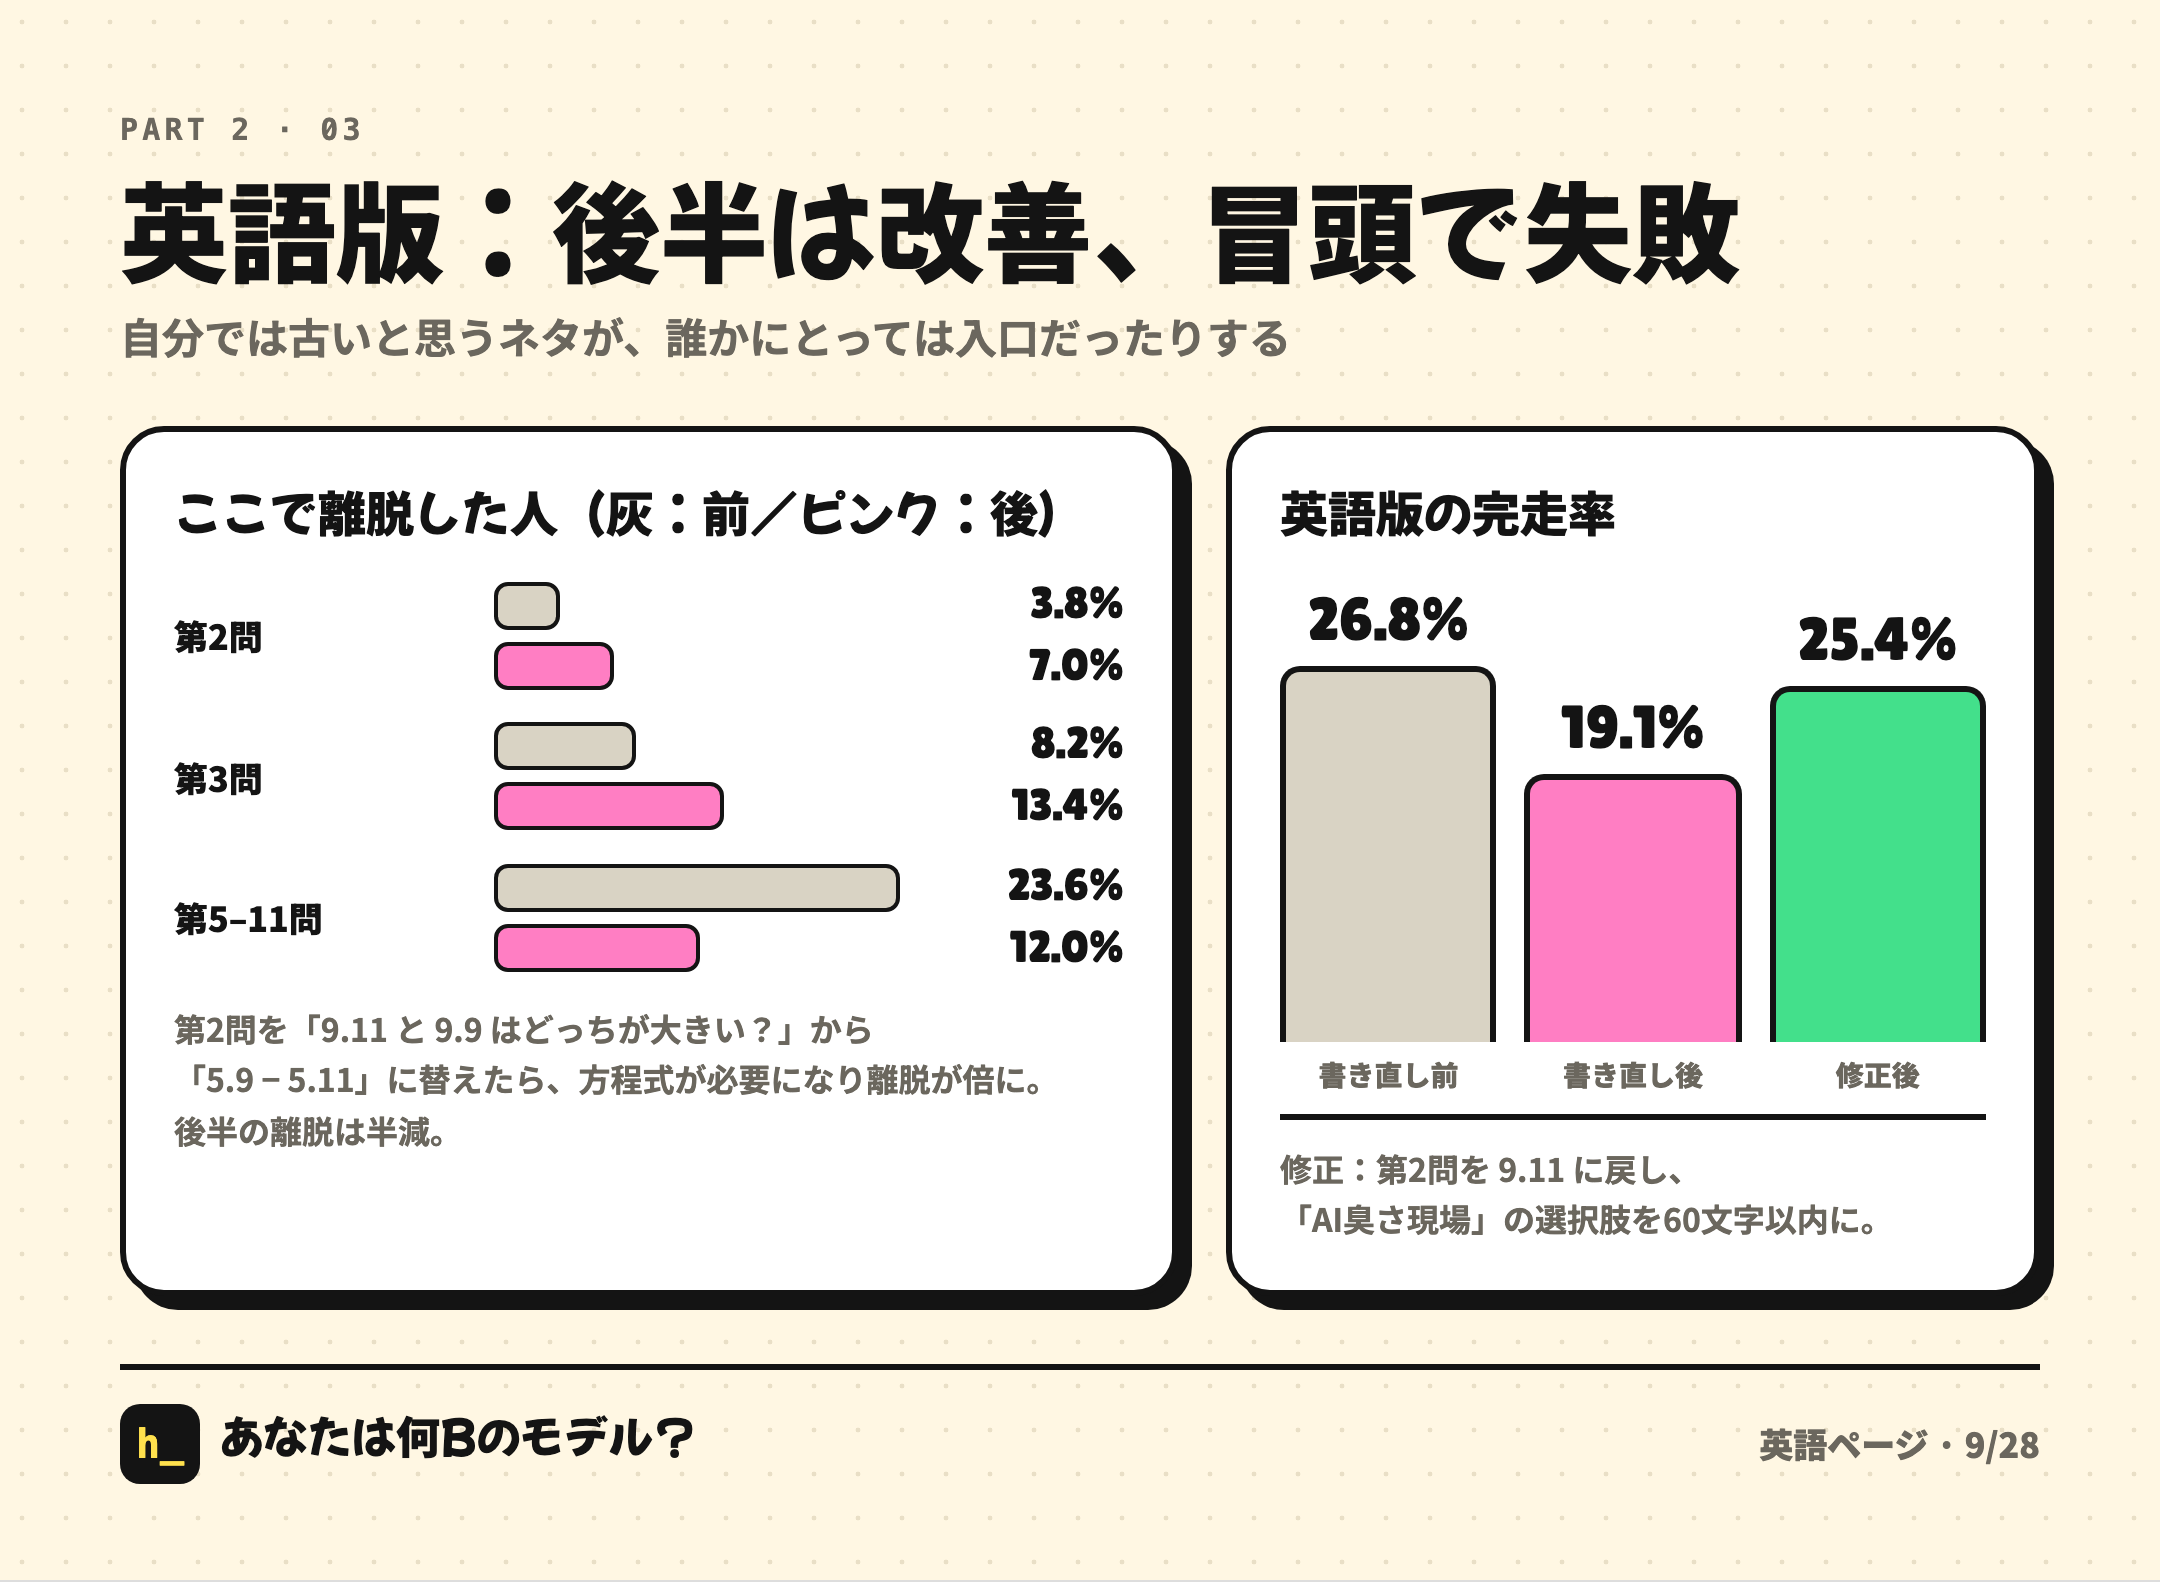
教訓は2つ。ひとつは、自分が古いと思っているネタこそ、ほかの人にとっては入ってくるきっかけかもしれないということ。strawberry と 9.11 は英語圏で確かに擦られ尽くしていますが、誰でも知っているからこそ入口に置くのに向いている。もうひとつは、1問ごとの表の価値は、「全体が悪くなった」を「どの問題が良くなって、どの問題が悪くなったか」に分解できること。合計だけ見ていたら「書き直しは失敗」と結論して、後半の良くなった部分まで一緒に捨てていたはずです。
8. 「ABテストはいらない、AA指標だけ見る」、そして Claude の自己訂正
翌日の昼、Claude に「流入チャネル × 離脱」の表を出してもらいました。
| どこから開いたか | 12問目を通過 | 完走 | Jev を使った人の完走 | Jev を使わなかった人の完走 |
|---|---|---|---|---|
| 通常のブラウザ | 73% | 48% | 66% | 40% |
| 68% | 42% | 73% | 32% | |
| 62% | 37% | 65% | 27% | |
| X | 57% | 30% | 58% | 20% |
X から来た人は、12問目(Jev の最初の招待が出る位置)の時点ですでに43%が離脱していて、ほとんどが招待までたどり着いていません。Claude は A/B テストを提案しましたが、私はこう決めました。
1. この何種類かのプレイヤーには4問目でJevの招待を出す……Xのアプリ内ブラウザで開いた人、WeChatのアプリ内ブラウザで開いた人、Xのリンクから来た人、英語版の全員。2. それ以外は12問目のまま。これでいこう この方針で ABはいらない AA指標だけ見ればいい
(ここでいう AA 指標は全体の指標のことで、AA知能指数ではありません。)
この変更を公開してから2時間のあいだに、Claude は2回報告してきました。招待を前倒ししたチャネルでは15問目の通過が約4ポイント増えていて、「中盤の定着が改善しています」。
さらに1時間ちょっとたって、Claude は自分でそれをひっくり返しました。
先ほど「中盤でより多くの人が残っている」と言いましたが、これは成り立ちません。Jev をオンにすると最大15問を一気にスキップするので、スキップされた問題も「到達」としてカウントされます……唯一信頼できる指標は完走率です。対照群の自然な変動を差し引くと、前倒し後の完走率はむしろ約2ポイント下がっています。
Jev を使う人は確かに26%から49%に増え、15問目の通過も60%から67%に上がりました。でもそれは Jev のスキップで「飛ばされた」結果で、人が本当に残ったわけではない。完走率は37.6%から36.8%になり、同じ期間に対照群は46.0%から47.2%に上がっていました。
私の返事は「了解 戻していいと思う」。全チャネルを12問目の招待に戻しました。
これはプロジェクト全体で唯一、AIが自分からデータの読み違いを認めて、変更の取り消しを提案したケースです。振り返ると、「A/B をやらない」ことでスピードは手に入ったけれど、その代わりに対照チャネルで時間帯の影響を差し引くしかなく、あやうく指標の定義にだまされるところでした。
9. 問題バンクを46%増量:AIのパイプライン
翌朝、Claude は完走したプレイヤーの11%が2回以上遊んでいることに気づき、「問題かぶり」の確率を計算しました。友だち同士で、人格チャットがかぶる確率が50%、名場面の会話が40%、AIっぽさ選手権が33%。シェアカードでいちばん目立つ中身が、よりによって問題バンクがいちばん小さい3カテゴリから来ていたのです。
最初の2ラウンドで、まずこの3カテゴリを倍にしました。朝10時、私はさらに言いました。
増やそう! 問題バンクは最低45%は増やしたほうがいいと思う どう思う?
量を増やしても質は落とさないでね! 元と同じくらいネタ感たっぷりで
Claude は「1回に何問出るか ÷ バンクに何問あるか」で優先順位をつけました。いちばんかぶりやすいのはグラフ問題(1回4問出るのにバンクに9問しかない)とパソコン操作問題。目標は約404問から589問へ、185問追加、つまり46%です。そしてパイプラインを組みました。
- 共通の執筆ガイドと、セルフチェック用のスクリプトを書く
- 11組のサブタスクが並列で中国語の問題を書く。各組がひとつの問題プールを担当し、コマンド、正規表現、コードはすべて実際に動かして確かめる
- 「ネタ編集長」2人がレビュー。各問題の「ネタ度、正確さ、短さ、翻訳しやすさ、人を不快にさせないか」を採点し、4点未満はその場で直すか差し替える
- 5言語 × 3組、計15組が並列で翻訳
- 言語ごとにネイティブの最終チェック担当が1人、最初から最後まで通読
- 繁体字は2回校正
- 7言語でスモークテスト。追加した会話はすべて結末までクリックして確認
朝10時半に着手して、午後1時半に公開。各ステップの指示書はオープンソースのリポジトリの prompts/03-agent-briefs.md に入っていて、そのまま流用できます。
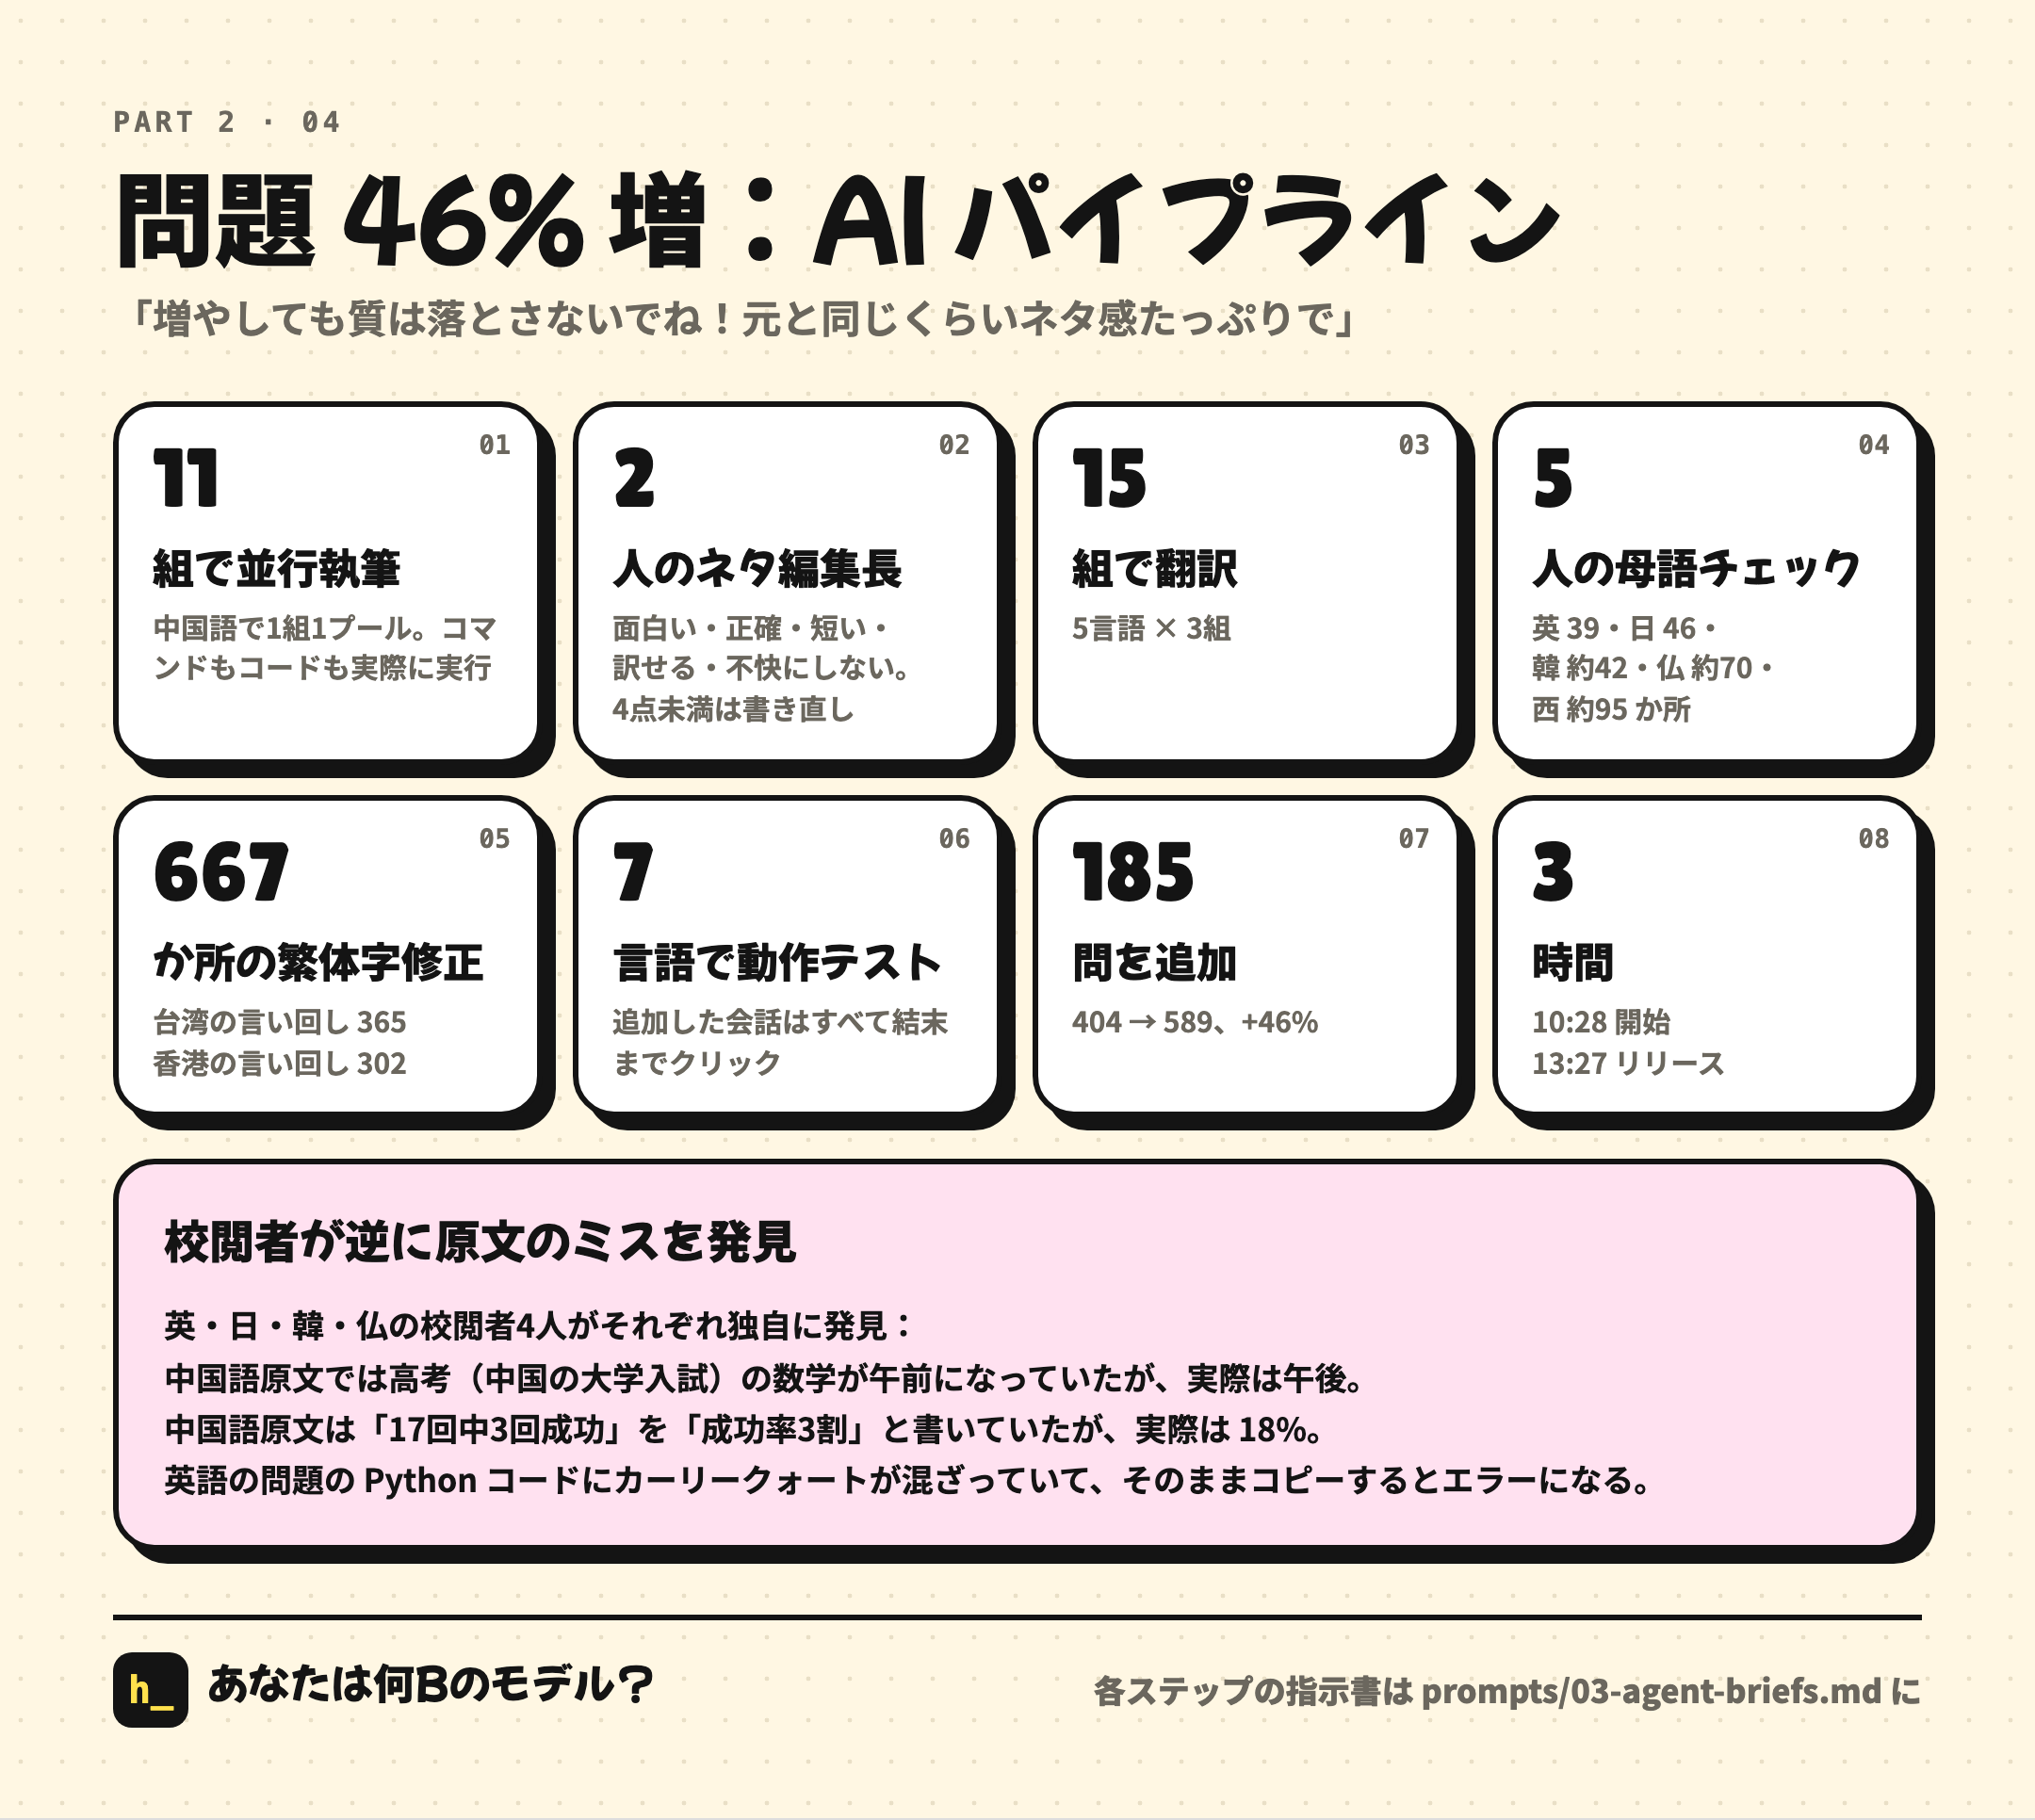
このパイプラインでいちばん面白かったのは、校正担当が逆に原文の誤りを見つけてきたことです。
- 4か国の校正担当が、それぞれ独立に同じ誤りを見つけた。 前のラウンドのローカライズで、中国語の原文には高考(中国の大学入試)の数学が「6月7日の午前」とあったのですが、実際はその日の午前は国語で、数学は午後。英・日・韓・仏の4人の校正担当はお互いの結果を見られないのに、全員がこれを指摘しました。そのラウンドで私が気にしていたのは「日本にも高考ってあるの?」くらいで、Claude も最初は原文に問題はないと思っていたのですが、それでも校正担当は立てていました。
- 中国語の原文で「17回中3回成功」を「成功率3割」と書いていたが、実際は18%
- 英語の問題の Python コードにスマートクォートが使われていて、そのままコピーするとエラーになる
- 日本語で1か所、意味が逆に訳されていた。韓国語のある単語は今では差別語とみなされるので差し替えた
- 繁体字で「对象」(交際相手)が台湾向けの変換ルールでプログラミング用語の「物件」(オブジェクト)に変わってしまい、ダジャレがひとつ死んだ
- ライターが「AIがポケモンをプレイしておつきみやまで詰まる」を2回書いてきて、2回とも私がボツにした。「ポケモンのおつきみやま、界隈の外まで届かない気がする」
翻訳のプロセスが、逆に原文のファクトチェックになっていました。
一度だけ事故もありました。ある翻訳チームがフルビルドを走らせたせいで、本番の繁体字版が簡体字から自動変換され、まだレビューしていない新問題まで載ってしまったのです。気づいてすぐ校正担当を立てて補いました。
10. Safari と四芒星
翌日の午前、8種類の人格それぞれに専用の配色を作りました。豆包型(日本語版では Siri 型)には赤いマフラー、Gemini 型には四芒星の背景、Grok 型にはスラッシュ柄と警告テープ。まず非公開のプレビューにして、私が確認してから公開しました。
2時間後、自分でやってみたら Gemini 型が出て、シェアカードの生成に失敗しました。
中国語 1.5Bモデル dense gemini人格で失敗した なんでだろ それともIPと関係ある?
safari
昨日の夜は少なくとも大丈夫だったのに 何があったんだろ
Claude は2分で原因を特定しました。Gemini の四芒星も Grok のスラッシュ柄も、CSS の背景に SVG 画像を埋め込んで作っていた。Safari はこの種の画像を canvas に描くと、その canvas を画像として書き出すことを禁止する。豆包の赤いマフラーはたまたま通常の画像タグで置いていたので無事でした。それまでずっと Chromium でテストしていたので、一度も発生していなかったのです。
配色を公開してから直すまでの2時間、Safari で Gemini 型か Grok 型が出た人は全員、シェアカードを書き出せませんでした。修正は、3つのテクスチャを PNG に置き換え、Safari のエンジンで9種類の配色をすべてテストし、さらに「書き出し失敗」の計測を追加。
この計測がすぐ別の問題も捕まえました。一部の人の環境で、スクショ用ライブラリが公開 CDN から読み込めていなかったのです。自前ドメインから読み込むフォールバックを足したところ、書き出し失敗はゼロになりました。
11. この36時間で学んだこと
1. まず最大のレバーを見つける。 20分遊ぶ診断にとって、最大のレバーは完走率です。シェア率はもともと高い(完走した人の半分以上がシェアする)ので、完走する人が増えればシェアは自然に増えます。
2. 1問ごとの表は、合計よりずっと役に立つ。 3問目の12%、10問目のボス級 ARC、英語版2問目の倍増。どれも合計だけ見ていたら絶対に見えなかったものです。
3. 指標の定義は人をだます。しかもごく自然に。 Jev がスキップした問題も「到達」に数えられる。「Jev をオンにした人63%対オンにしなかった人23%」には自己選択バイアスがある。最初の何枚かの表は、タイムゾーンが間違っていた。時点によって完走率のしきい値が違う。どれも、あやうく間違った結論を出すところでした。
4. 方向は私、測定はAI。 いくつかの重要な決定は、私の一言から来ています。「問題を減らすんじゃない」「抜き打ちチェックって雑じゃない?」「ドカンと一気に飛ばすべき」。いくつかの重要な発見は Claude から来ています。3問目の離脱、フランス語はやる価値がないこと、そして自分の結論をひっくり返したあの訂正。逆もまた然りで、私が決めた「A/B をやらない」はマイナスの変更をあやうく残すところだったし、Claude が「いちばん面白いものを最初に」で3問目に置いた会話は、12%の人を追い返しました。
5. 効果が見えないものには期待しない。 これは後編で詳しく書きます。公開してもデータがぴくりとも動かなかった機能もあって、それは残しておくけれど、もう時間はかけない。
36時間がたって、完走率は開始時の29%前後から、45%前後で安定しました。アクセスは翌日の夜から自然に落ち着き始めました。
でもそれより前から、同時にもうひとつのことが起きていました。プレイヤーがこれを広めていたのです。新規訪問者の4割は友だちの挑戦リンクから来ていて、完走した日本のプレイヤーは1人あたり平均2.3人の新規訪問者を連れてきていた。挑戦リンクから来た人の7割は、リンクを送ってきた友だちに負けていました。
それが後編の話です。
フォロワー数百人から96の国と地域へ、そして1.27万件の回答に見えた「人間」
全3回の振り返りの最終回です。前編は4通のメッセージから公開まで、中編は公開後にデータを見ながらプロダクトをどう直したか。今回は、これがどうやって広まったのか、1.27万件の回答から何が見えたのか、どんなデータを集めて、どんなデータを集めなかったのか、そして人間とAIがそれぞれ何をしたのかを書きます。
まずは最終的な数字から(9月29日午前時点)。
- 約100万:推定リーチ数。ポストのインプレッション数十万に、プレイヤーが発信した1.36万回のシェアが友だちの目に触れた回数を足したものです。推定値で、実測値ではありません。
- 3.99万:ユニーク訪問者(UV)、つまり別々の人の数。ページの表示は合計 7.8万回(PV)。
- 2.94万人が開始を押し、1.27万人が76問を完走。完走したプレイは合計1.54万回。
- 7,001人が完走後にシェアし、シェアは合計 1.36万回。
- 96の国と地域、7言語。
- 出発点:フォロワー数百人の X アカウント、広告なし。
1. フォロワー数百人、ポスト1本
公開当日の夜10時半、Claude に聞きました。
へへ 反応けっこういい? このアカウントフォロワー数百人しかいないんだけど
Claude が流入元のデータを出すと、9割以上のアクセスがフォロワーの外から来ていました。ポストは最初の火種になっただけで、その後の訪問者は主にプレイヤー同士が連れてきたものです。
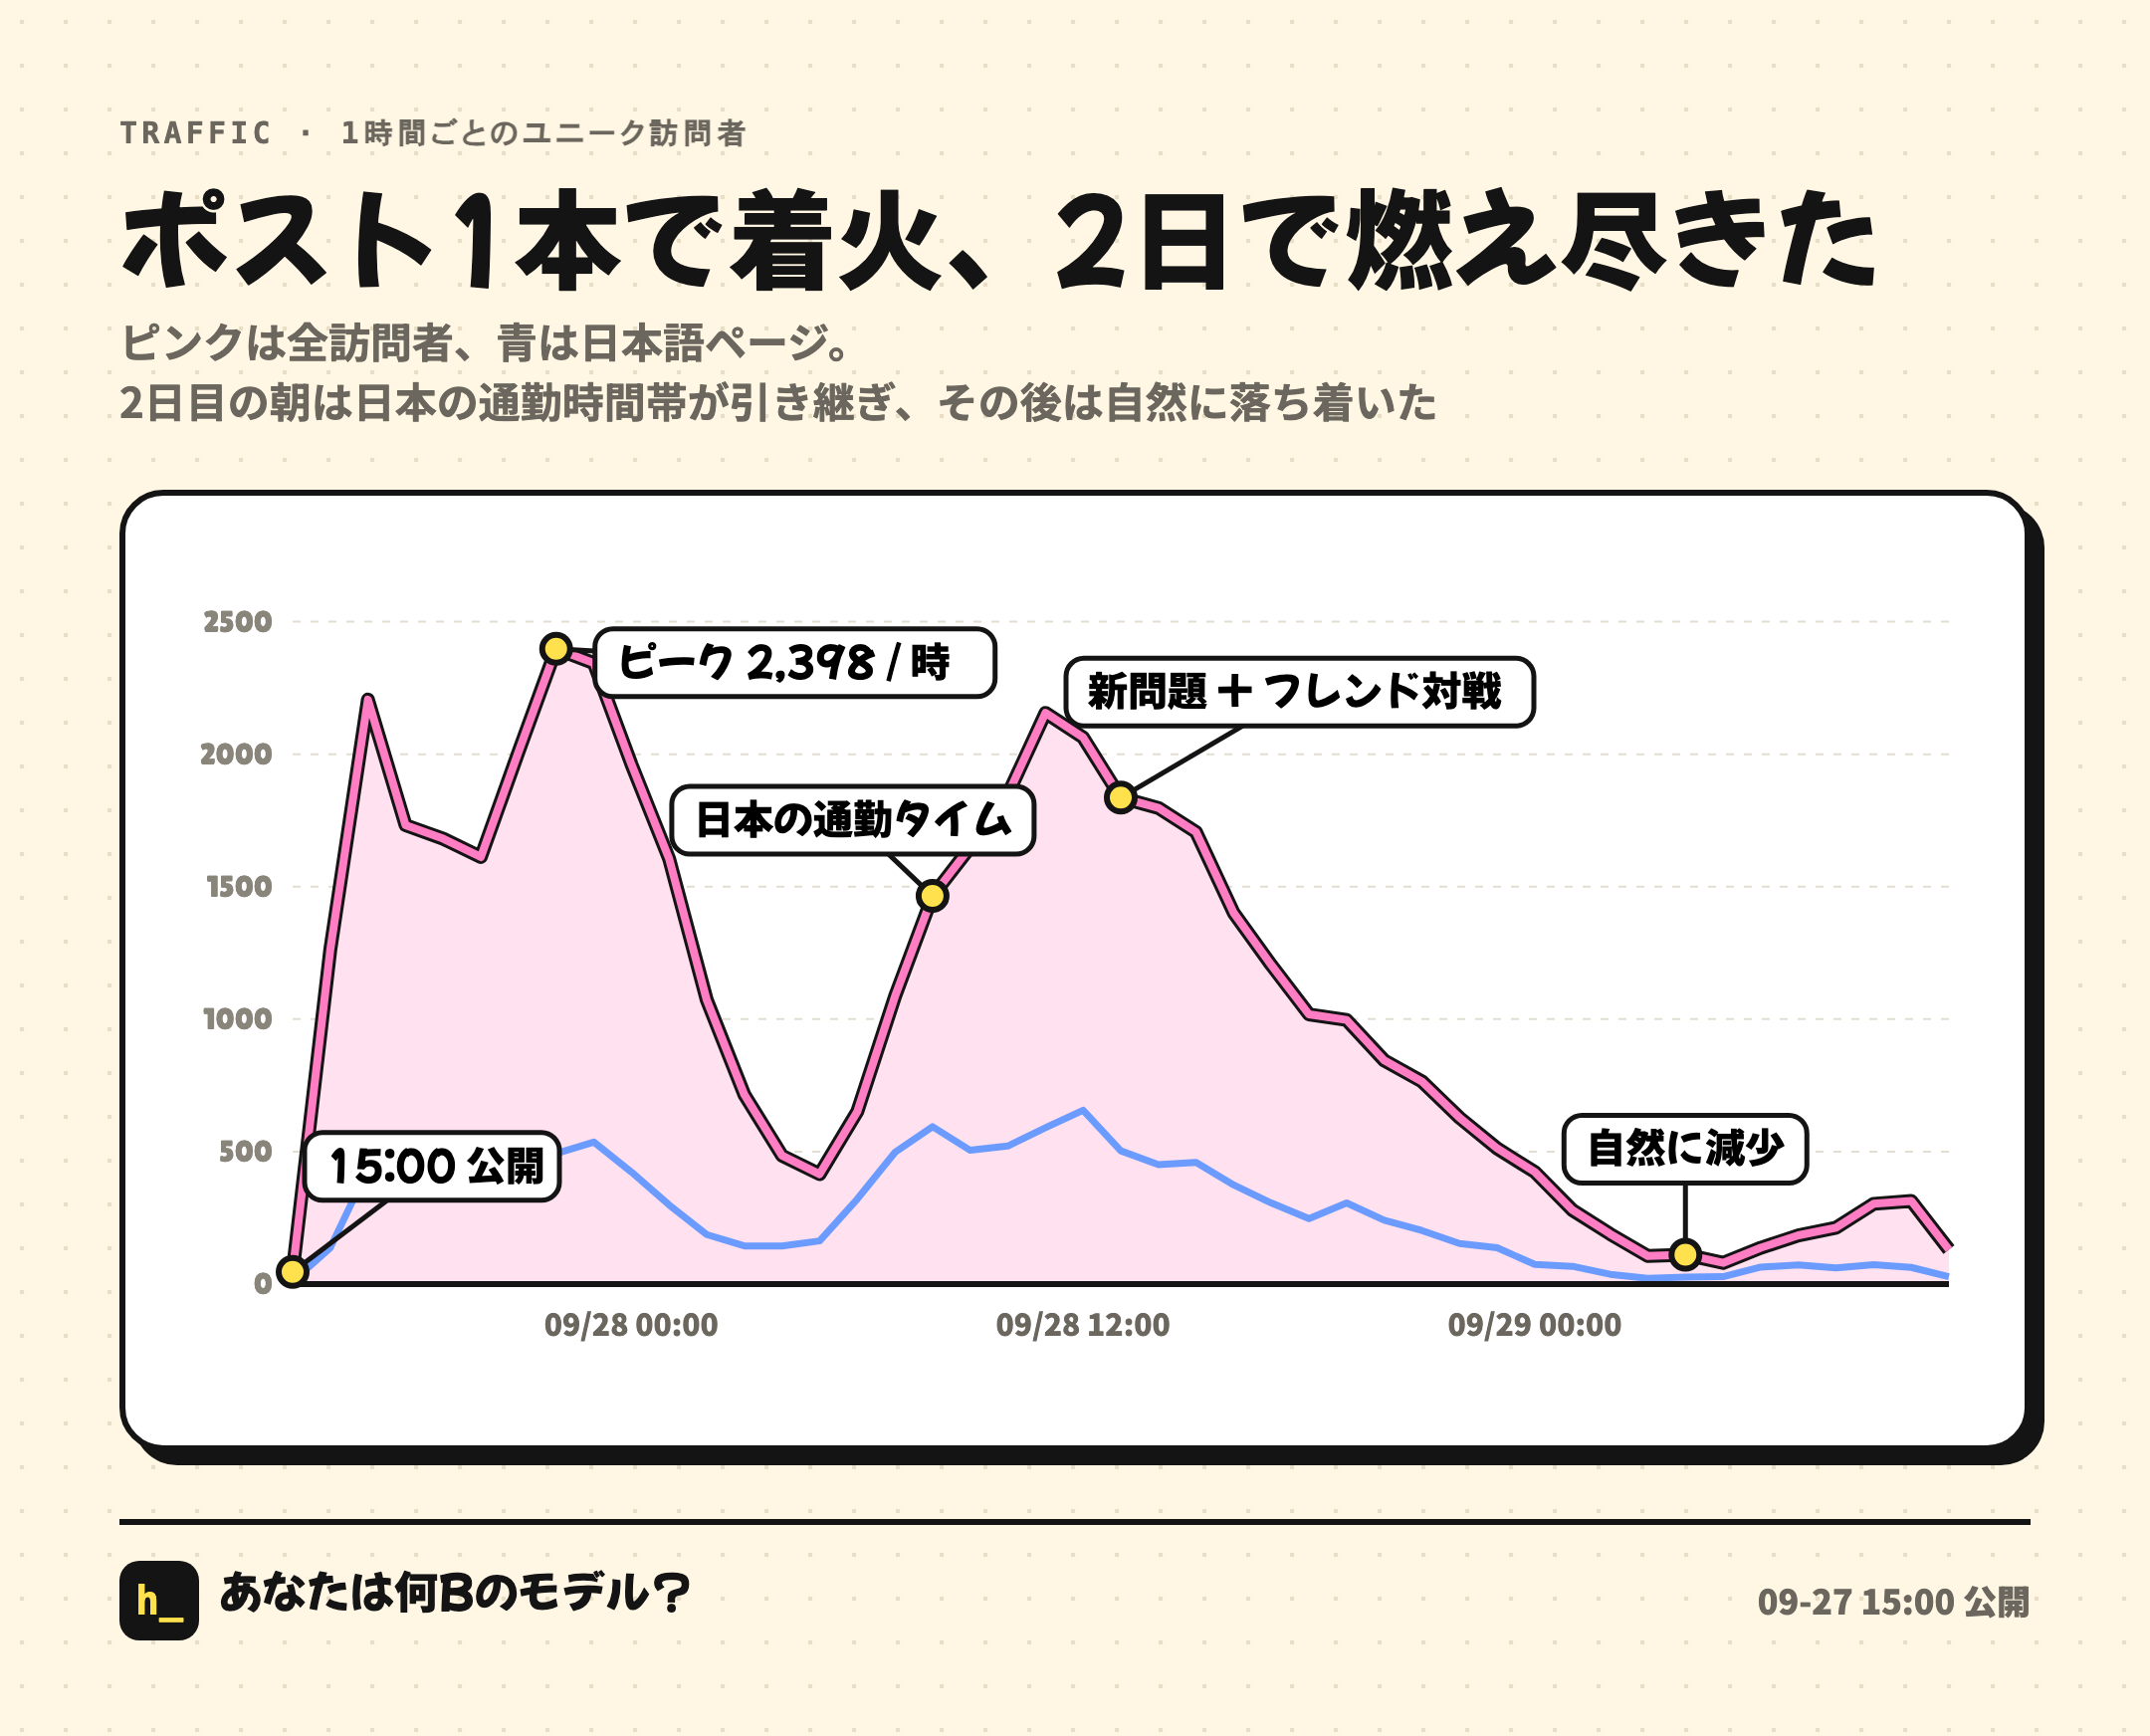
アクセスの推移は典型的でした。午後3時にポストして、夜10時にピーク、1時間あたり2,398人のユニーク訪問者。翌朝は日本の通勤時間帯にバトンが渡り、日本語ページは一時1時間に500〜600人、日本が最大の流入元になりました。そこからは教科書どおりのミーム曲線です。翌日は夜のピークがもう来ず、1時間あたりの訪問者は1,200人から600人に減っていきました。
3日目に Claude に聞きました。「これってミームマーケティングの自然な落ち込みだよね?」そのとおりでした。なぜ必ず落ちるのかを、次に書きます。
2. バイラルはどう回ったか
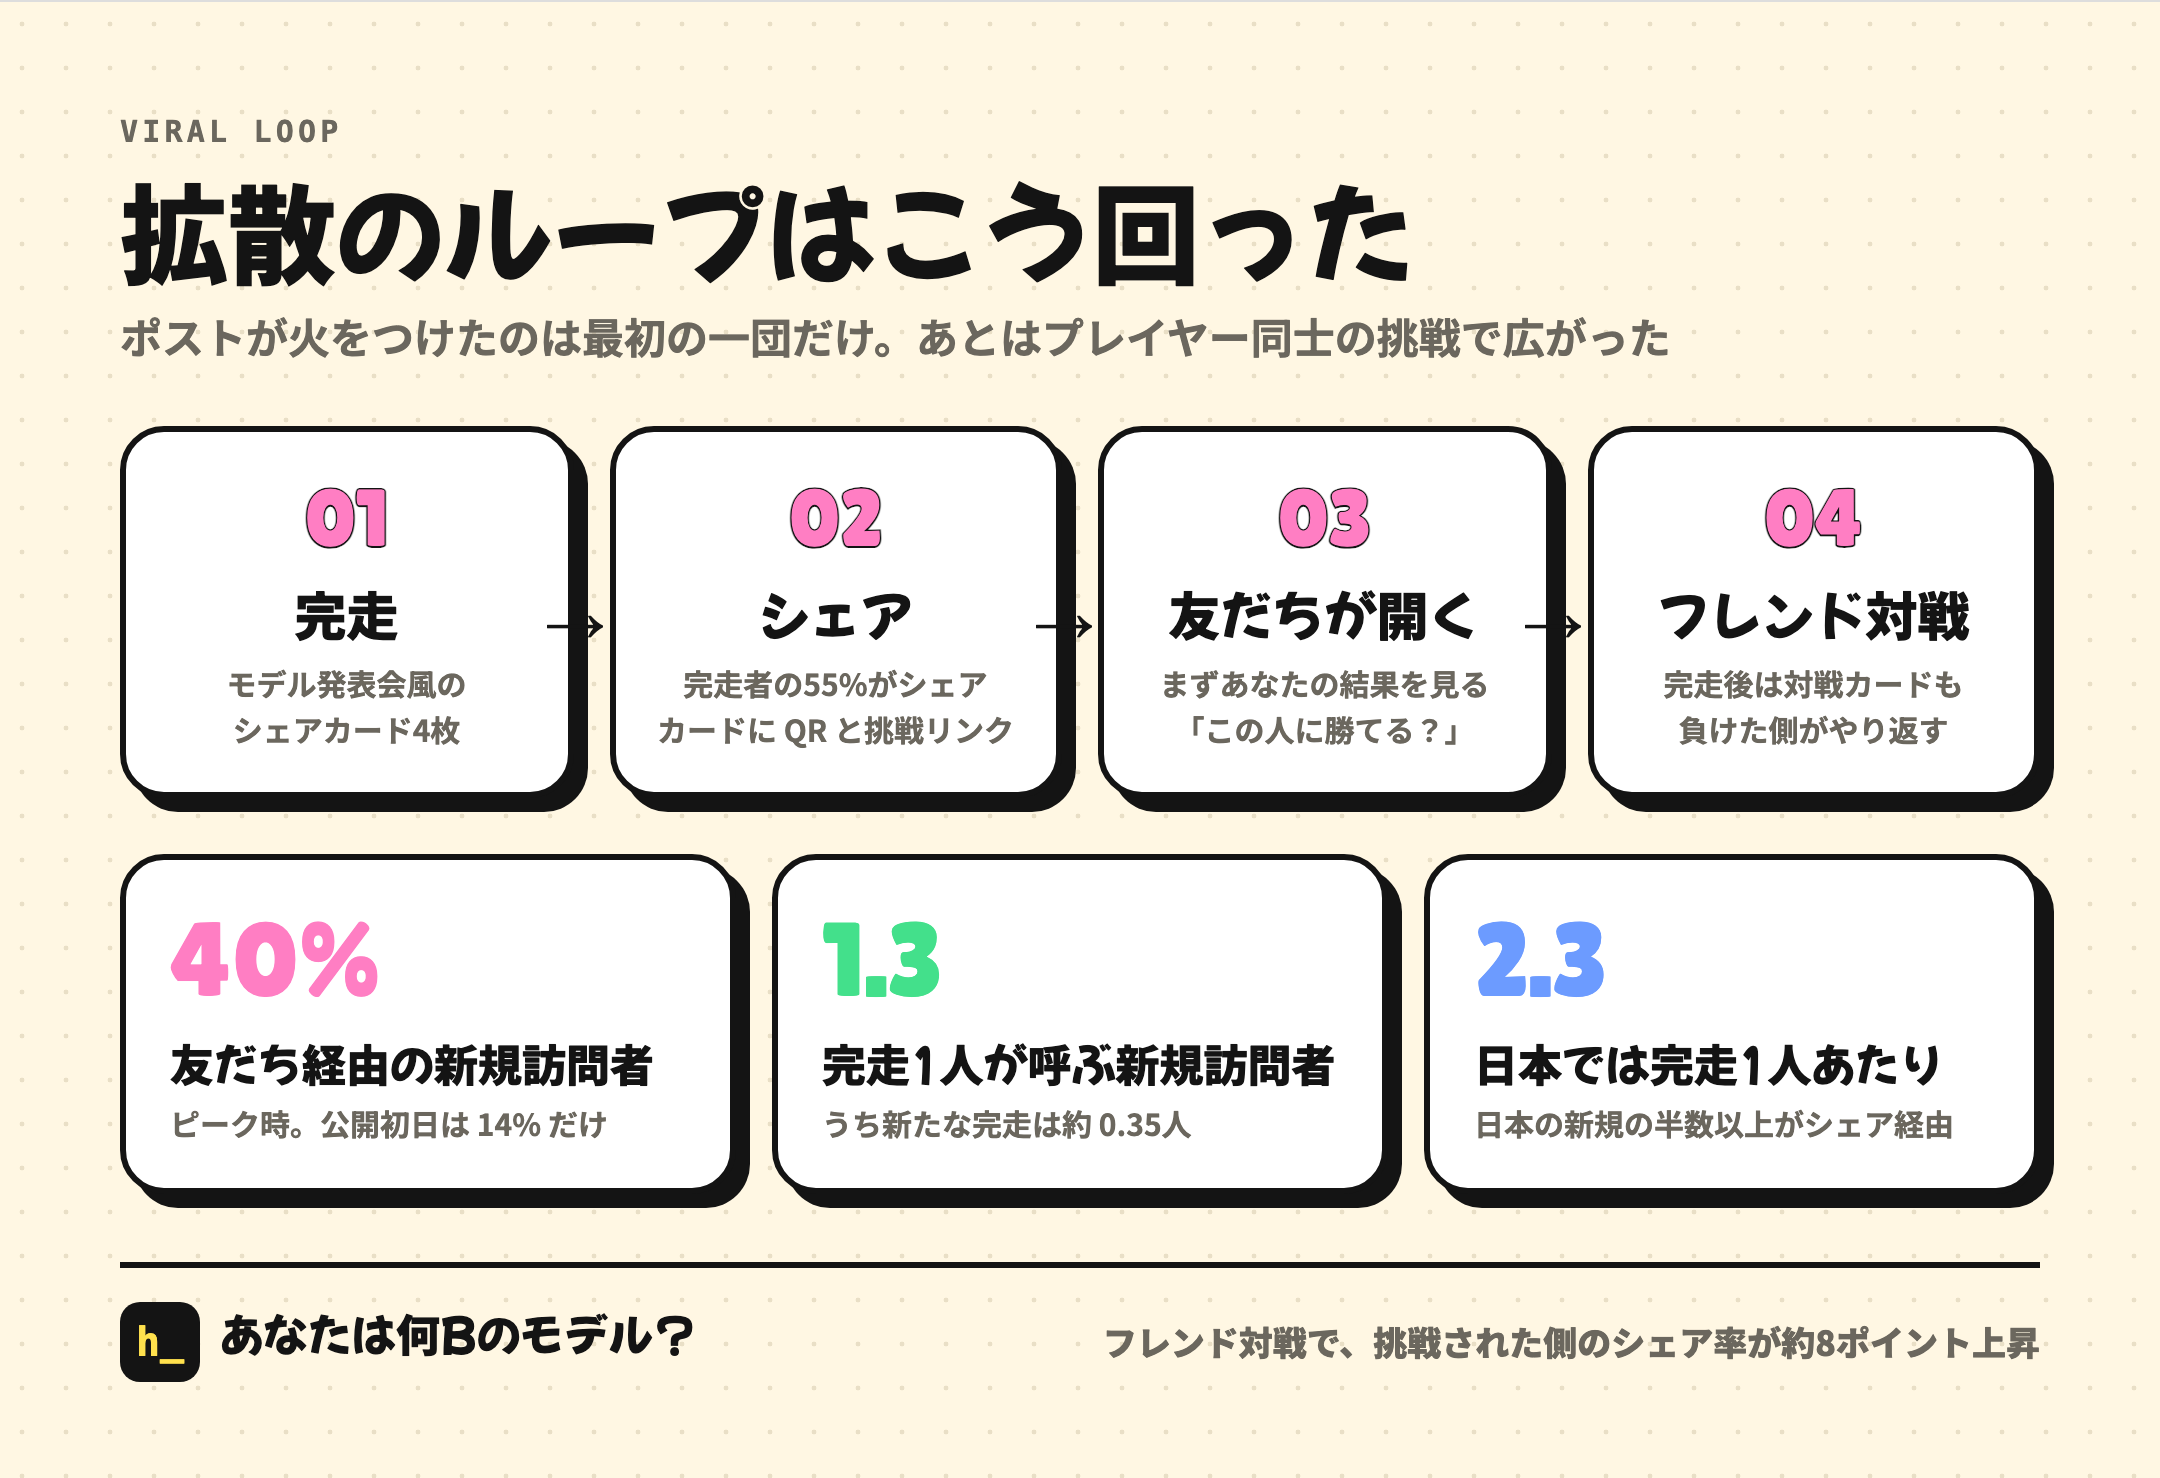
このプロダクトの拡散経路は、前編のあの一言「シェアされたものからそのまま開いて遊べる ループにしたい」で決まっていました。
- 完走すると「モデル発表会」と4枚のシェアカードができる
- カードには QR コードがあり、シェアリンクは一人ひとり自分の結果ページ
- 友だちが開くと、まず挑戦状が出る。「XX-671B · Claude型人格 · AA 35 · この人を超えられる?」
- 友だちが完走して、また次の人に送る
各ステップの転換率は次のとおりです。
- 完走した人の 55% がシェアする。一般的な診断系プロダクトは20%あれば上出来。
- 友だちの挑戦リンクから来た新規訪問者は、公開当日は14%だけだったのが、翌日のピーク時間帯には 40% に。
- 完走した人1人あたり平均 1.3人 の新規訪問者を連れてくるが、新たな「完走」は約 0.35人 分にしかならない。
この最後の数字が肝です。1より小さいということは、外からのアクセスの補充がなければ、拡散は1周ごとに前の周より小さくなるということ。20分かかる診断で、開いた人のうち完走するのは4割だけ。このステップが拡散係数を1未満に押し下げていました。これがミームのライフサイクルで、中編であれほど完走率の改善に力を入れた理由でもあります。1ポイント上がるごとに、拡散係数が少しずつ1に近づくからです。
チャネル別の細かい話をいくつか。
日本。 完走した日本のプレイヤーは1人あたり平均2.3人の新規訪問者と0.52人の新たな完走を生んでいて、全言語で最高でした。日本からの新規訪問者の半分以上は、友だちのシェア経由です。理由は後のデータで出てきますが、日本のプレイヤーはとにかくリンクをそのまま送ってくれるんです。
WeChat と QQ。 WeChat や QQ(どちらも中国の定番メッセージアプリ)の中で開いた人の4割は挑戦リンク経由で、ほとんどが QR コードの読み取りでした。WeChat 内で完走した人は平均1.15回シェアしていて、開き方の中で最高です。Claude からは、WeChat はドメインをブロックすることがあり、メインサイトまで巻き添えになるかもしれない、と注意があったので、予備のドメインと切り替えスイッチを用意して、WeChat 内で生成されるリンクだけを切り替えられるようにしました。結局一度も使いませんでした。
小紅書。 QR コードや URL の入った画像は小紅書(RED。中国版インスタのようなSNS)で表示制限を受けるので、外部サイトの情報を一切載せない「小紅書版」カードを用意しました。
X。 X、Telegram、Discord に貼ったシェアリンクのプレビュー画像は一人ひとり自分の結果カードで、Cloudflare 上でその場で生成しています。
3. もうひと盛り上がり:シークレット、フレンド対戦、ワンタップで X へ
翌日の午前、アクセスが落ち始めたので Claude に聞きました。
シェアとバイラルをもっと増やせるものないかな もうひと盛り上がりさせたい
いくつか手を打ちました。効いたものもあれば、効かなかったものもあります。
シークレット
ブラインドボックスみたいにシークレット入れられない? 最後に九マスのグリッドを出して 最後のひとつが「?」になってるやつ
8種類の人格とは別に「人間タイプ」を隠しました。二つ名は「網をすり抜けた者」、台詞は「検出失敗:AIっぽさゼロ。」。HumanBench という名前をそのままひっくり返したオチです。
出現条件は実データから逆算しました。Claude はまず約3,000件の回答で試しましたが、いちばん厳しい条件でも8%以上の人が当てはまってしまい、ありふれすぎていた。条件を絞って、6,846件の回答で約2.6%になるようにしました。条件は、どのモデルの決め台詞的なAI口調もほとんど選んでいない、「正気」が一般のプレイヤーより明らかに高い、おべっか・説教・話が長い・真顔でデタラメ・脱獄された・指示を聞かない、の合計が最大1回。公開後の実際の出現率は2.8%でした。
言い回しは2回直しています。1回目。
このパーセンテージのレア度は出さないほうがいいと思う 失礼だって感じる人がいるかもしれないから シークレットだけ表示するほうがいいかな。
もともとは普通の8人格にも「よくいる 19.6%」「レア 7.4%」と出す予定でしたが、シークレットだけに表示するように変えました。2回目。
そういえば「引き当てる」って言い方はやめて
「引き当てられる?」は「あなたもこれかも?」に、「シークレットをゲット」は「あなたがシークレット」に。診断されるのはあなた自身であって、ガチャで引いた景品ではないからです。
効果として、完走後1時間以内にもう1回遊ぶ割合が14%から18%に上がりました。2回以上遊んだ人の87%は、2回目に違う人格が出ています。
フレンド対戦カード
友だちの挑戦リンクから来た人には、完走すると対戦カードがもう1枚付きます。2人の AAスコアを同じランキング図に並べ、12項目のベンチマークを1つずつ比べて、判定ステッカーを1枚。
このカードは4回作り直していて、毎回私の一言に押されて進みました。
フレンド対戦カードちょっとしょぼくない? あとこれって従来の4枚のカードに影響する? どういう関係?
あと挑戦ページのほうなら ベンチマークとaa indexを出せばいいじゃん 2人を1つの表と1つのグラフにまとめて あとWebのほうはちょっとしたアニメーションで描画してもいい それとこの対戦カードは追加のカードであって 置き換えじゃない
youとthemはやめて モデル名で呼べばいい あとaaのとこ なんでもうちょい作り込めないの? 棒グラフ全部にモデル名つけるとか?
レイアウトもうちょい気持ちよくできるでしょ たとえばあの表って別に全幅じゃなくていい 自然な感じで
これだとまたスカスカ もっときれいに組めない? レイアウト変えていいし 情報足してもいい
判定ステッカーは、私がいちばん気に入っている部分です。相手よりパラメータが小さいのに勝ったら「下剋上・これが蒸留」。相手よりパラメータが大きいのに負けたら「パラメータの無駄遣い・これが水増し」。僅差の勝ちは「勝ったけど、ベンチマークの誤差レベル」。引き分けは「両社の発表会がそろって SOTA を宣言」。
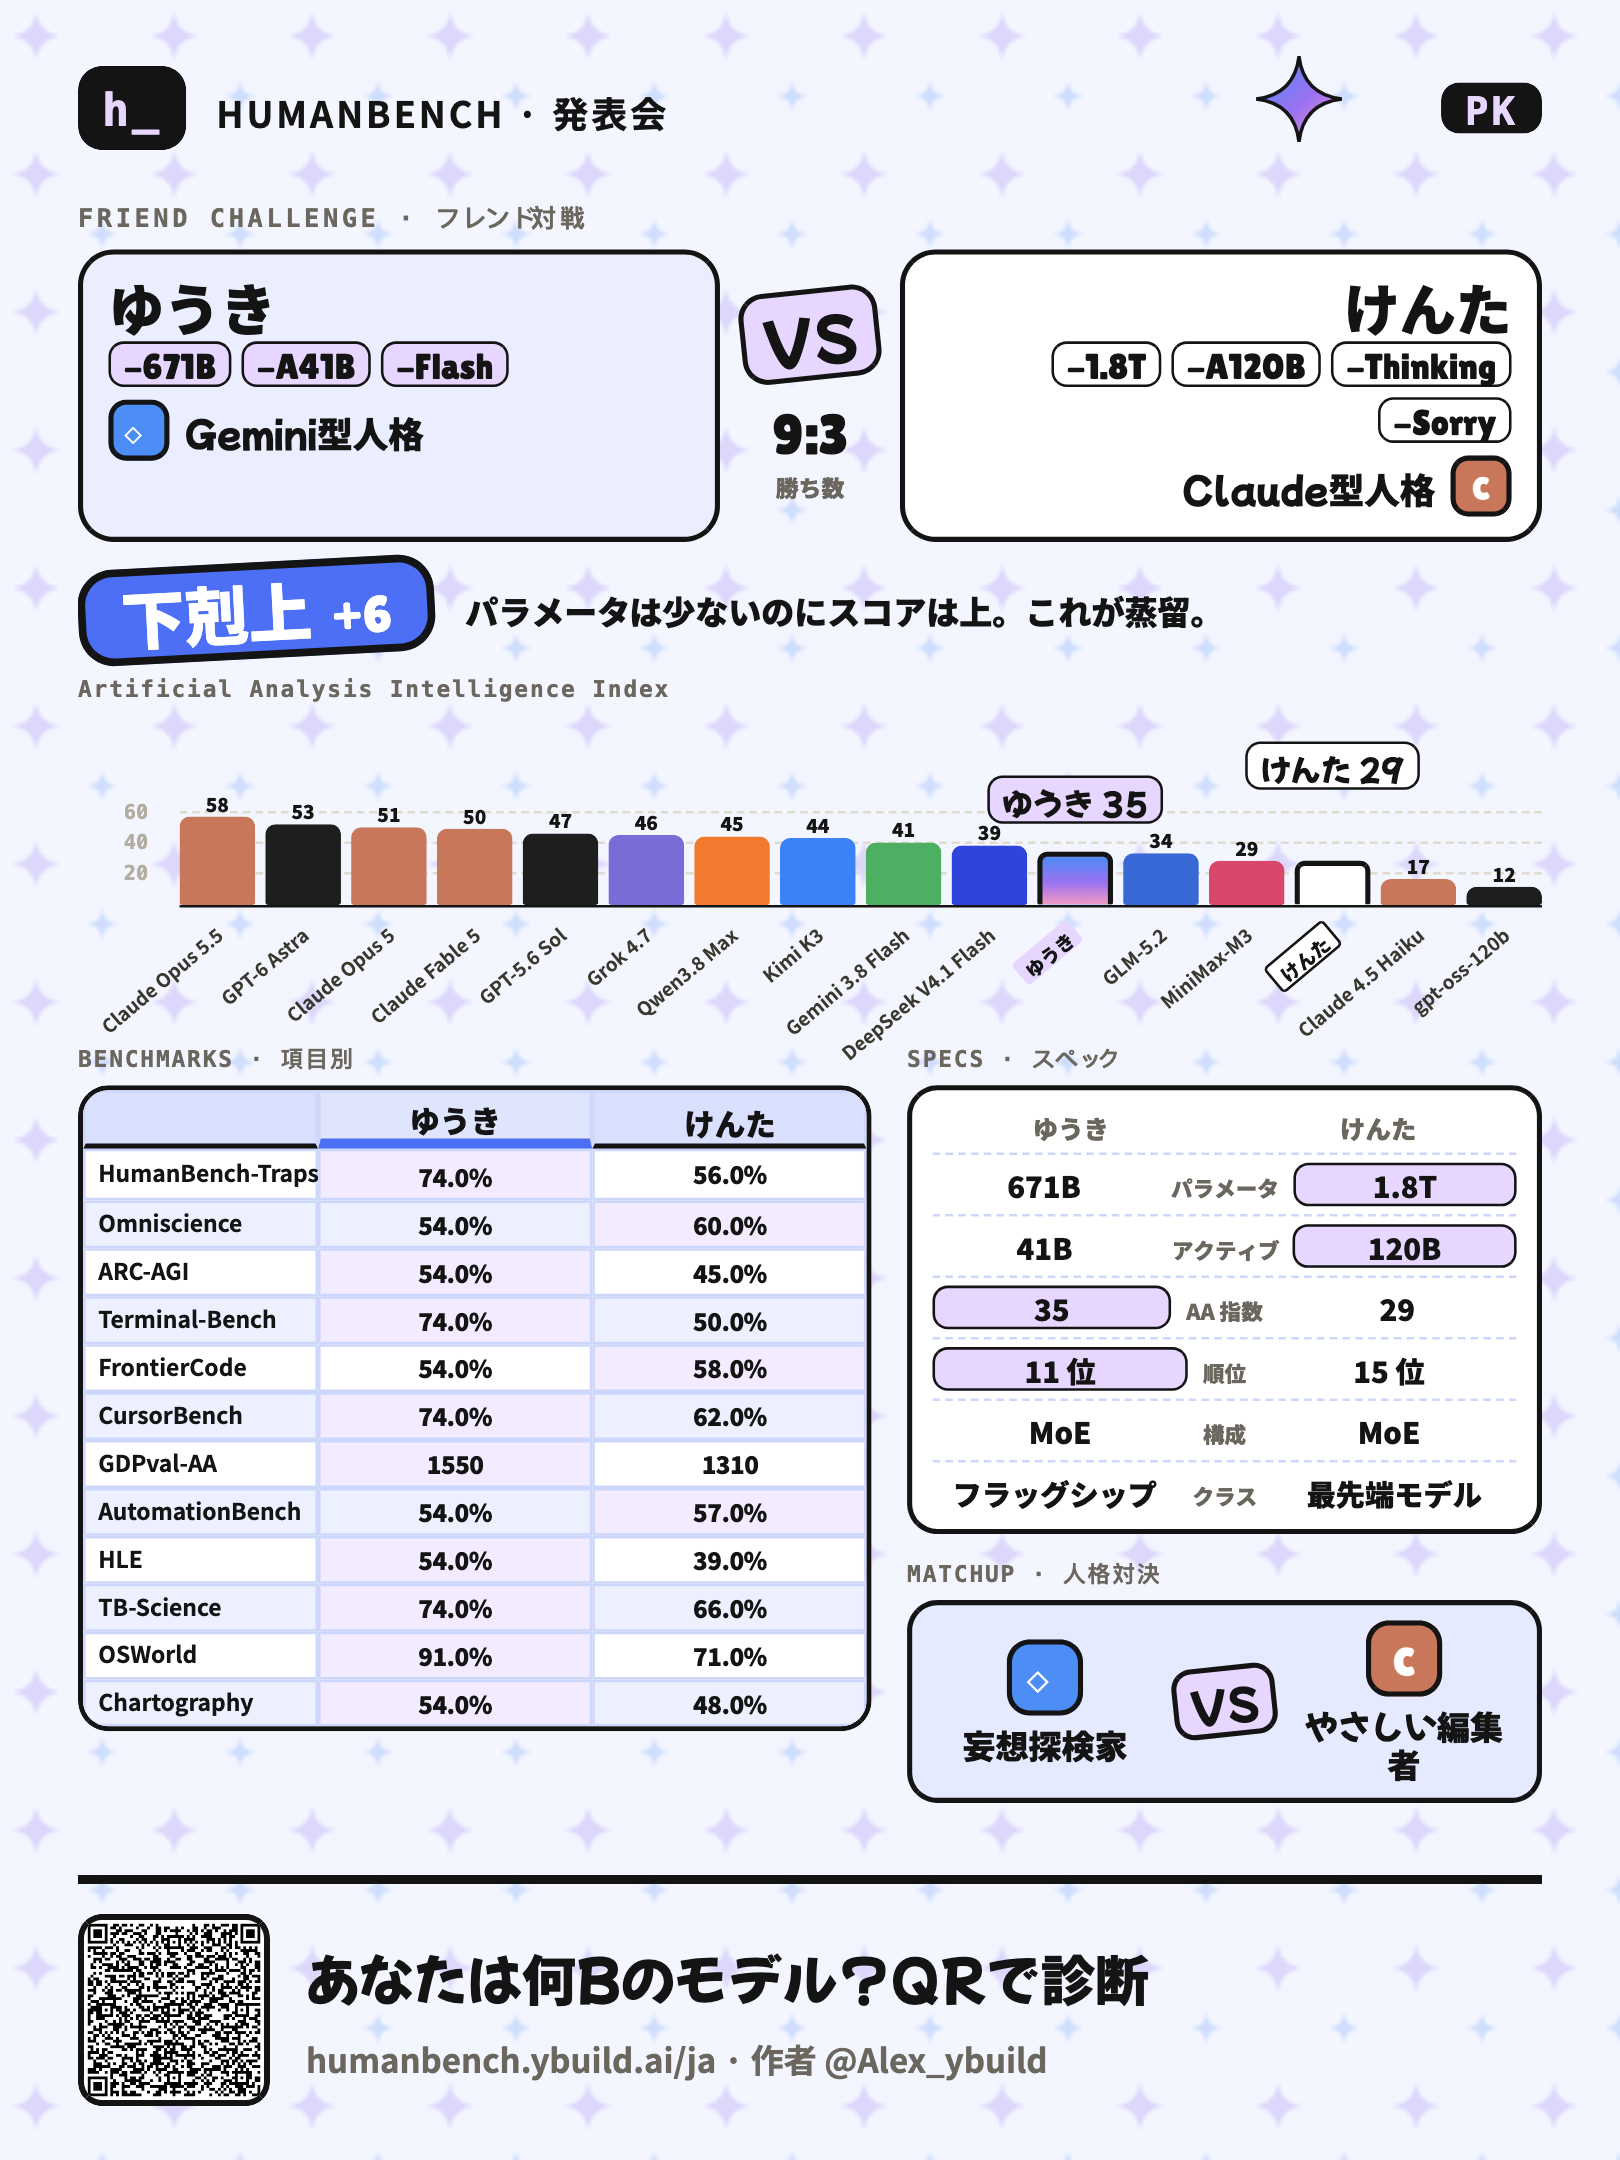
効果はというと、同じ時間帯の対照群と比べて、挑戦を受けた人のシェア率が相対的に約8ポイント高くなりました。伸びたのは「シェアリンク」のほうで、負けた人ほど自分のリンクを送り返したがる。43%の人が、対戦カード入りのシェアカード一式を書き出しています。
ワンタップで X へ、人格図鑑の進捗、対戦の予告
- X にポスト:本文、個人の結果リンク、ハッシュタグをあらかじめ入力。押されたのは337回、連れてきた訪問者は72人。数は少ないけれど邪魔にはならないので、残しています。
- 人格図鑑の進捗:人格カードに「人格図鑑 5/9」を付けて、コンプリートしたくなるようにした。リプレイ率は18.3%から18.4%で、効果なし。
- 挑戦ページの対戦予告:挑戦ページのトップに「診断が終わると、ふたりの対戦カードができます」の一文を追加。開始率は対照群を差し引いて約−1ポイントで、ノイズの範囲。
効果が見えないものは残しておくけれど、もう時間はかけない。
4. 1.27万件の回答に見えた「人間」
人にAIを演じさせる診断に、1.27万件の完全な回答がたまりました。これを(まったく厳密じゃない)「人間ベンチマーク」として眺めてみたら、面白いものがいくつか出てきました。
先に断っておくと、以下はすべて集計値で、誰か一人の具体的な回答は一切見ていません。時刻はすべてプレイヤーの現地時間に換算しています(中国語ページは北京時間、日本語・韓国語ページは東京/ソウル時間、英語ページは IP の国から推定)。これはネタの診断であって学術研究ではないので、結論は話半分で楽しんでください。
1. みんな、いい成績だけシェアする
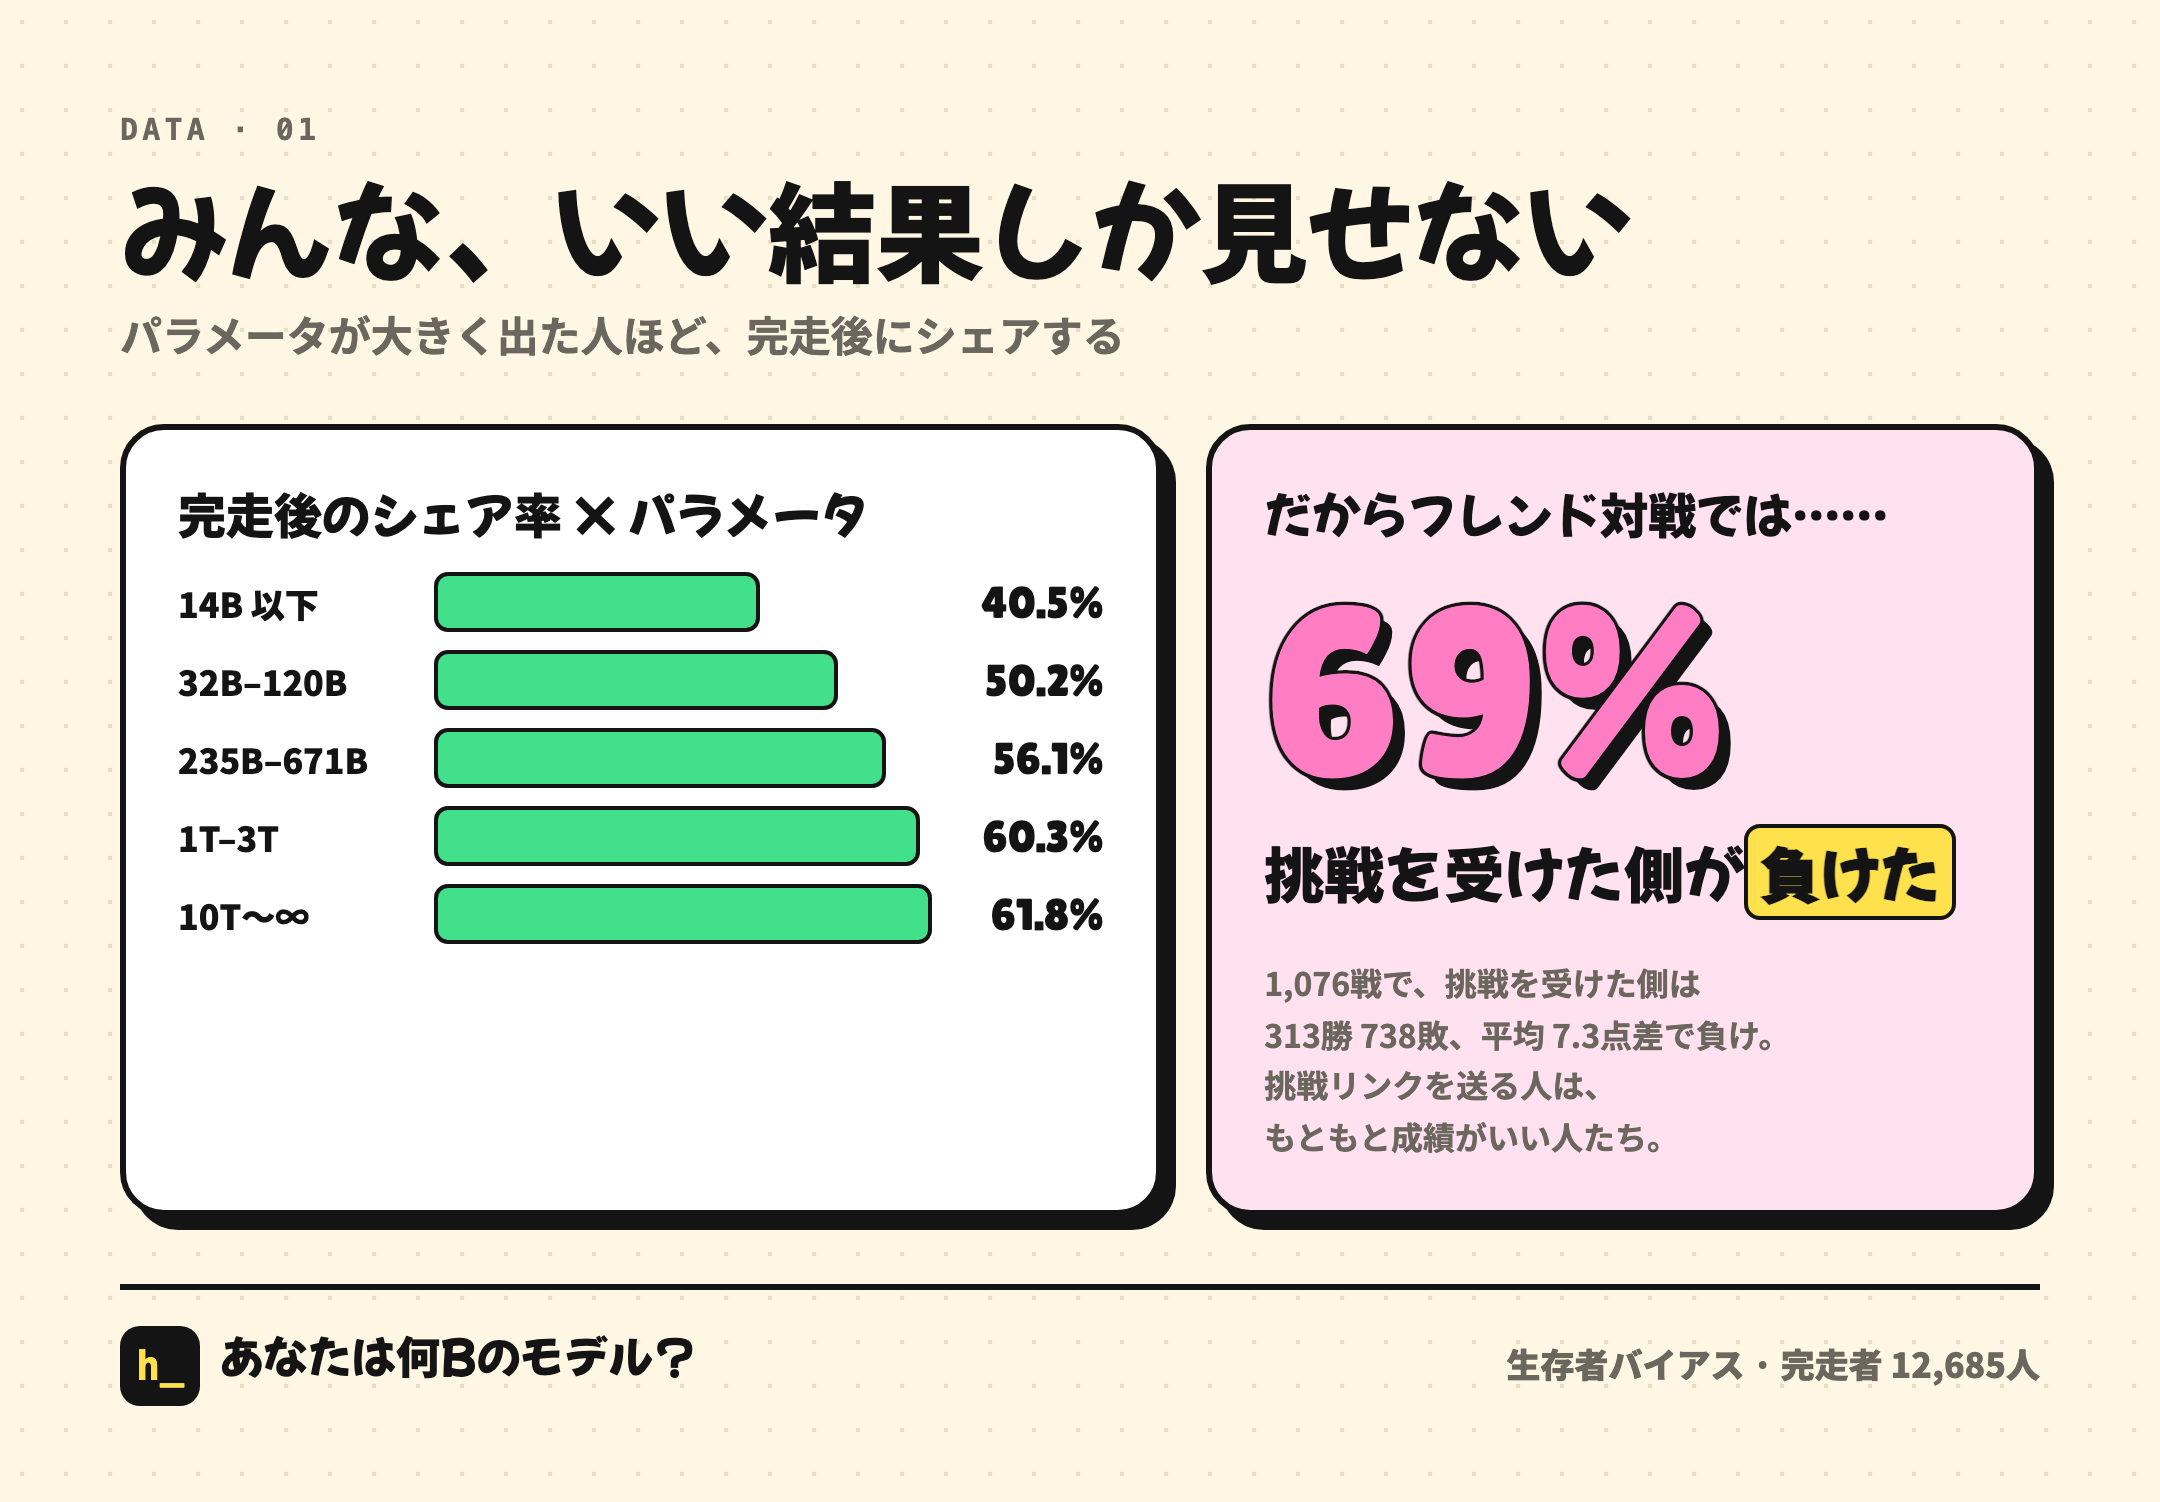
パラメータが大きく出た人ほど、シェアしたがります。14B 以下と出た人は完走後に40.5%がシェア、10T 以上の人は61.8%がシェア。
これが面白い結果を生みます。フレンド対戦では、挑戦リンクから来た人の69%が、リンクを送ってきた友だちに負けていて、平均7.3点低い。挑戦された側が弱いのではなく、リンクを送る度胸がある人がもともと成績のいい人たちだからです。生存者バイアスですね。
2. 人間もベンチマークを攻略する
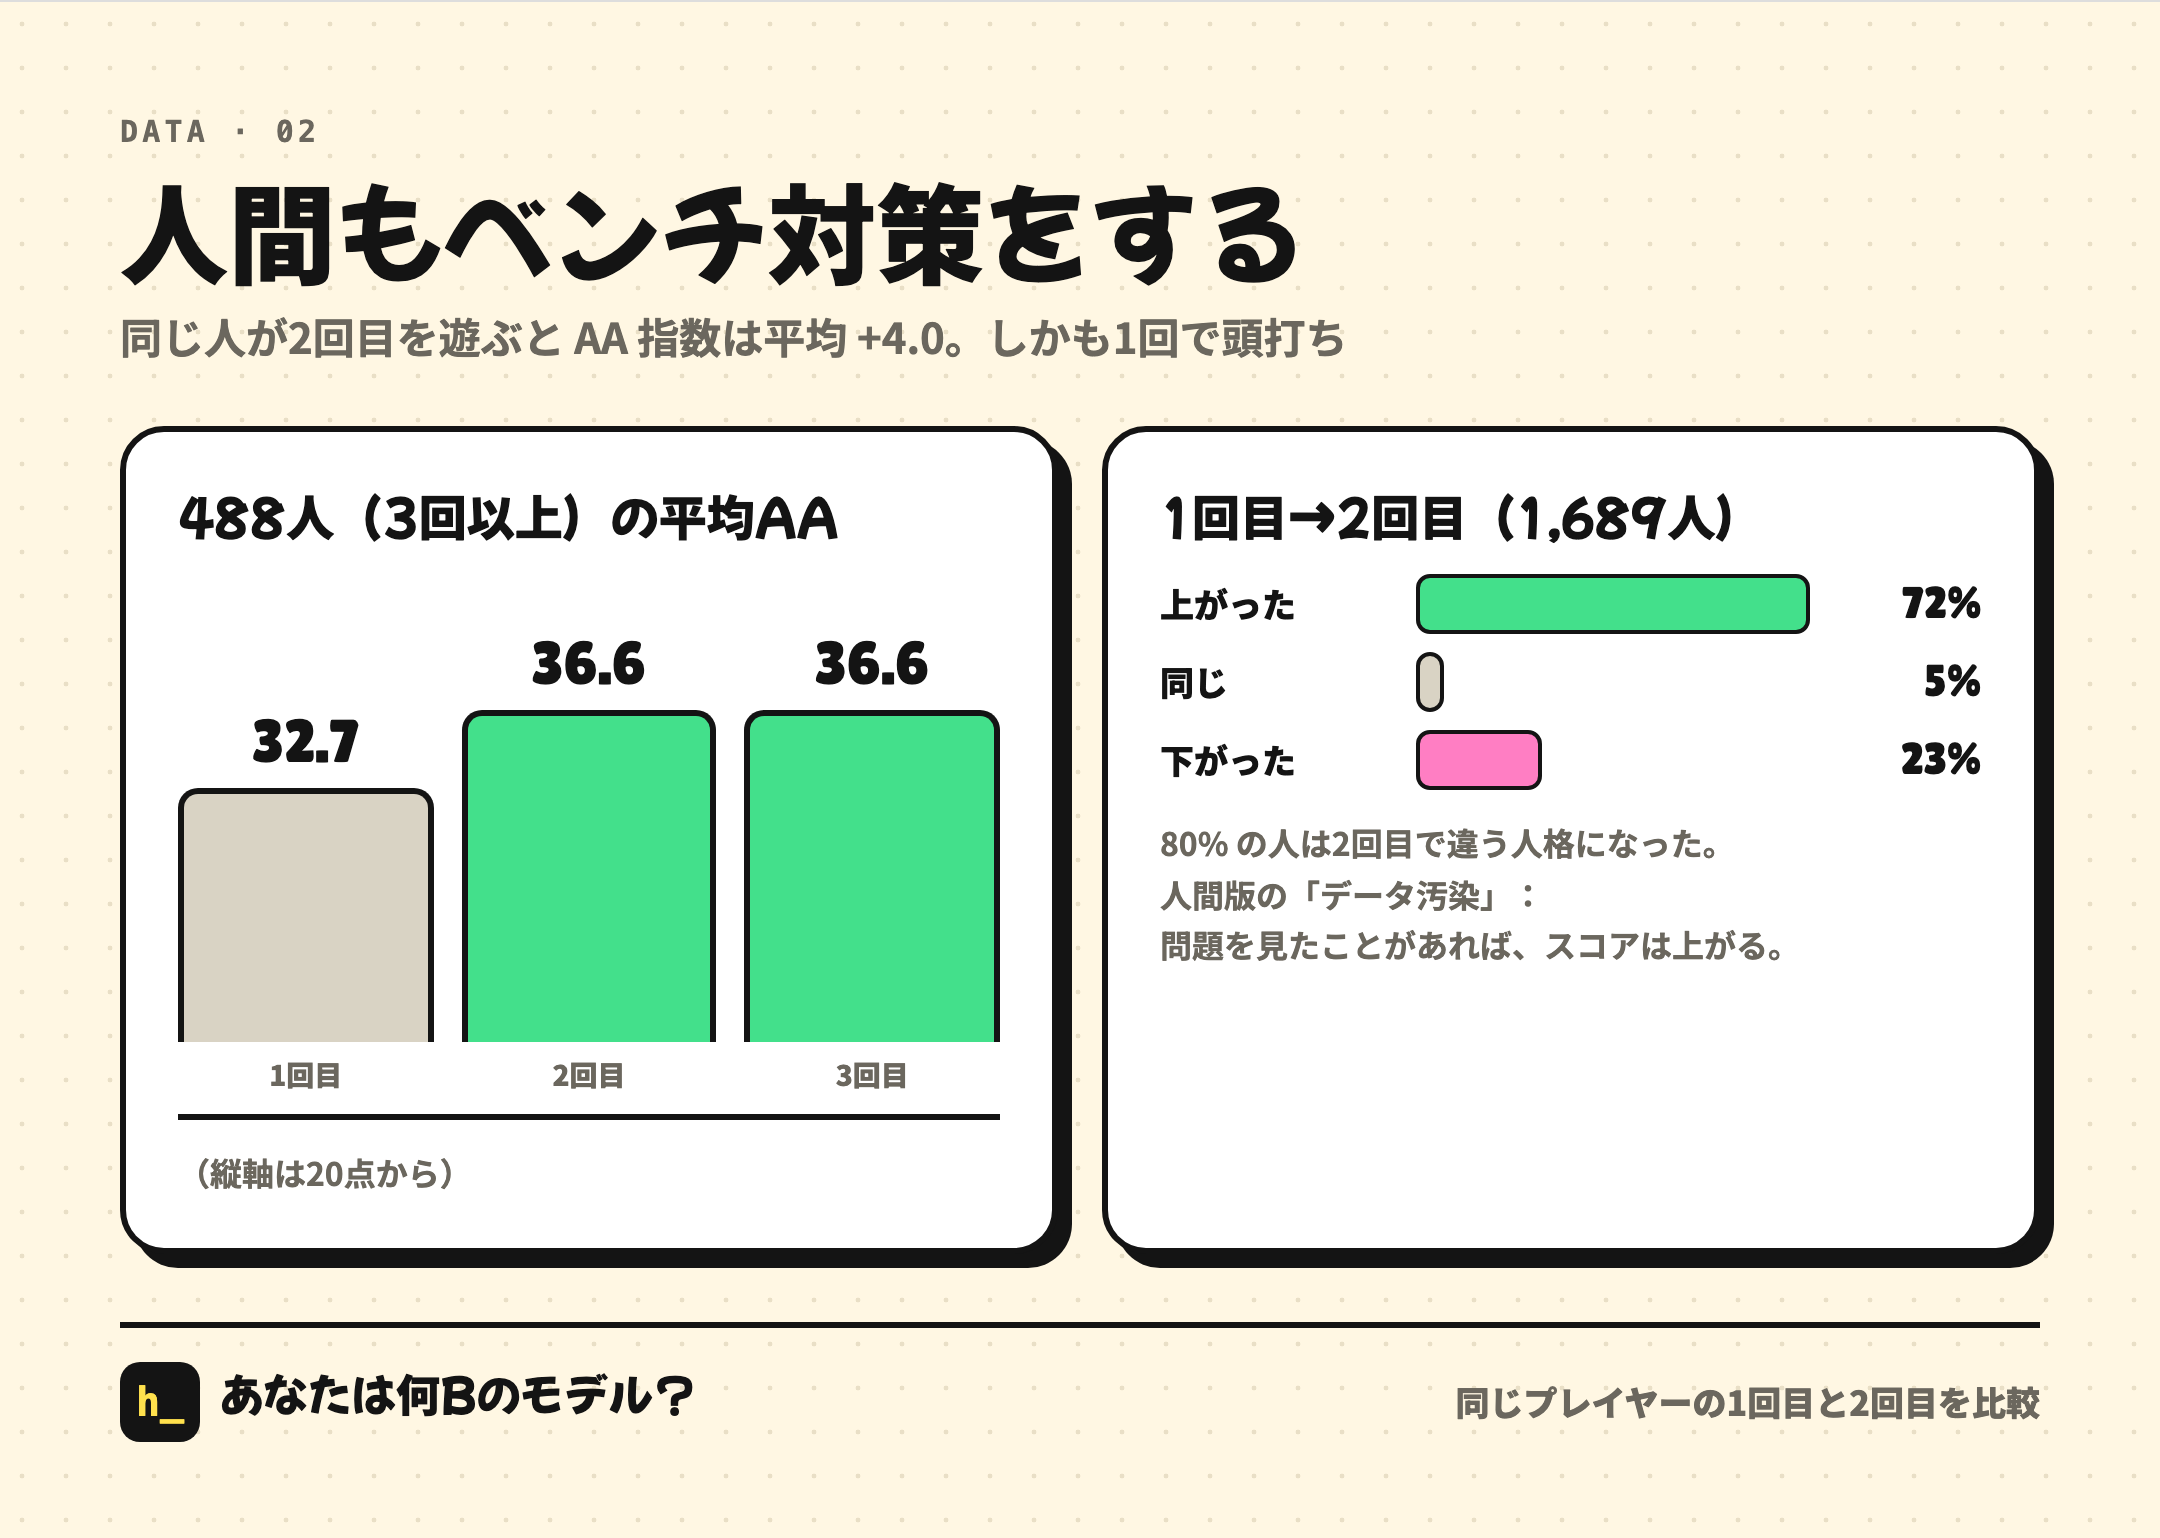
同じ人が2回目を遊ぶと、AAスコアは平均4.0上がり、72%の人が2回目のほうが良い成績でした。3回以上遊んだ人は、1回目32.7、2回目36.6、3回目も36.6。1回やり直せば頭打ちです。
これは人間版の「データ汚染」。問題を見たことがあれば、スコアは上がる。大規模モデルがベンチマーク対策で叩かれるのと同じで、人間がやってもやっぱりそうなります。
3. 長く考えるほど、スコアが高い
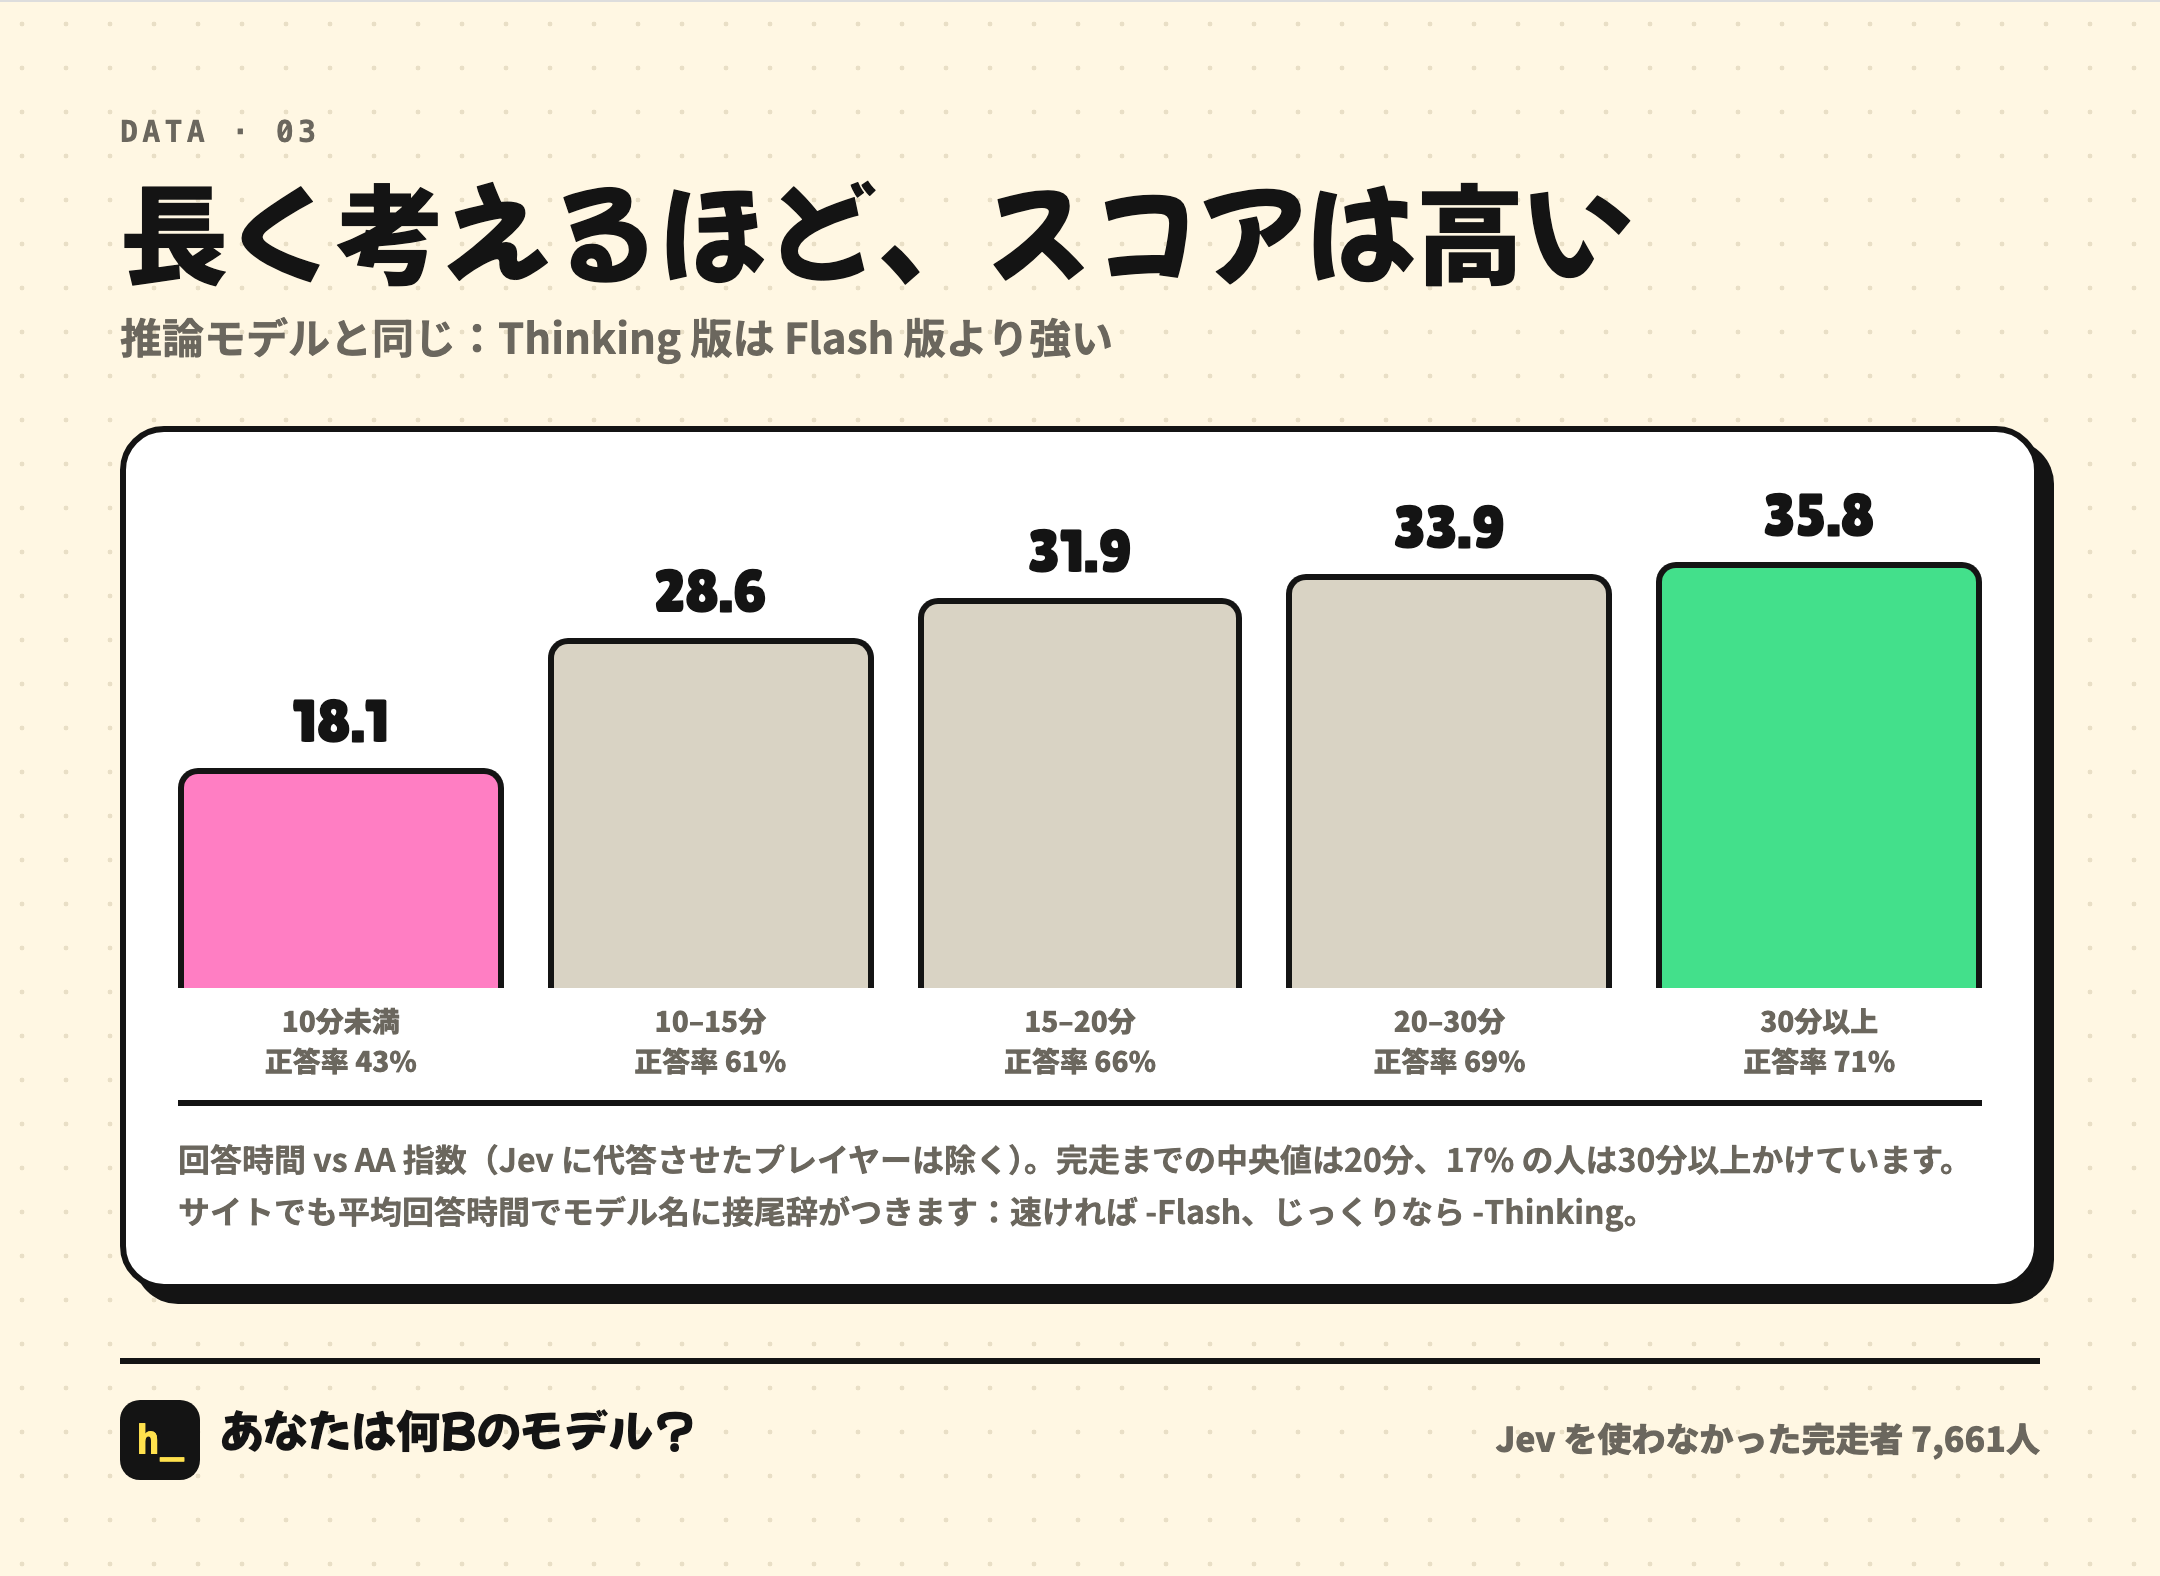
10分以内に完走した人は AA 平均18.1、正答率43%。30分以上かけた人は AA 平均35.8、正答率71%。推論モデルと同じで、Thinking 版はやっぱり Flash 版より強い。(実際、ページは平均所要時間に応じてモデル名にサフィックスを付けます。速ければ -Flash、遅ければ -Thinking。)
4. 深夜の人は GPT-4o っぽくなる
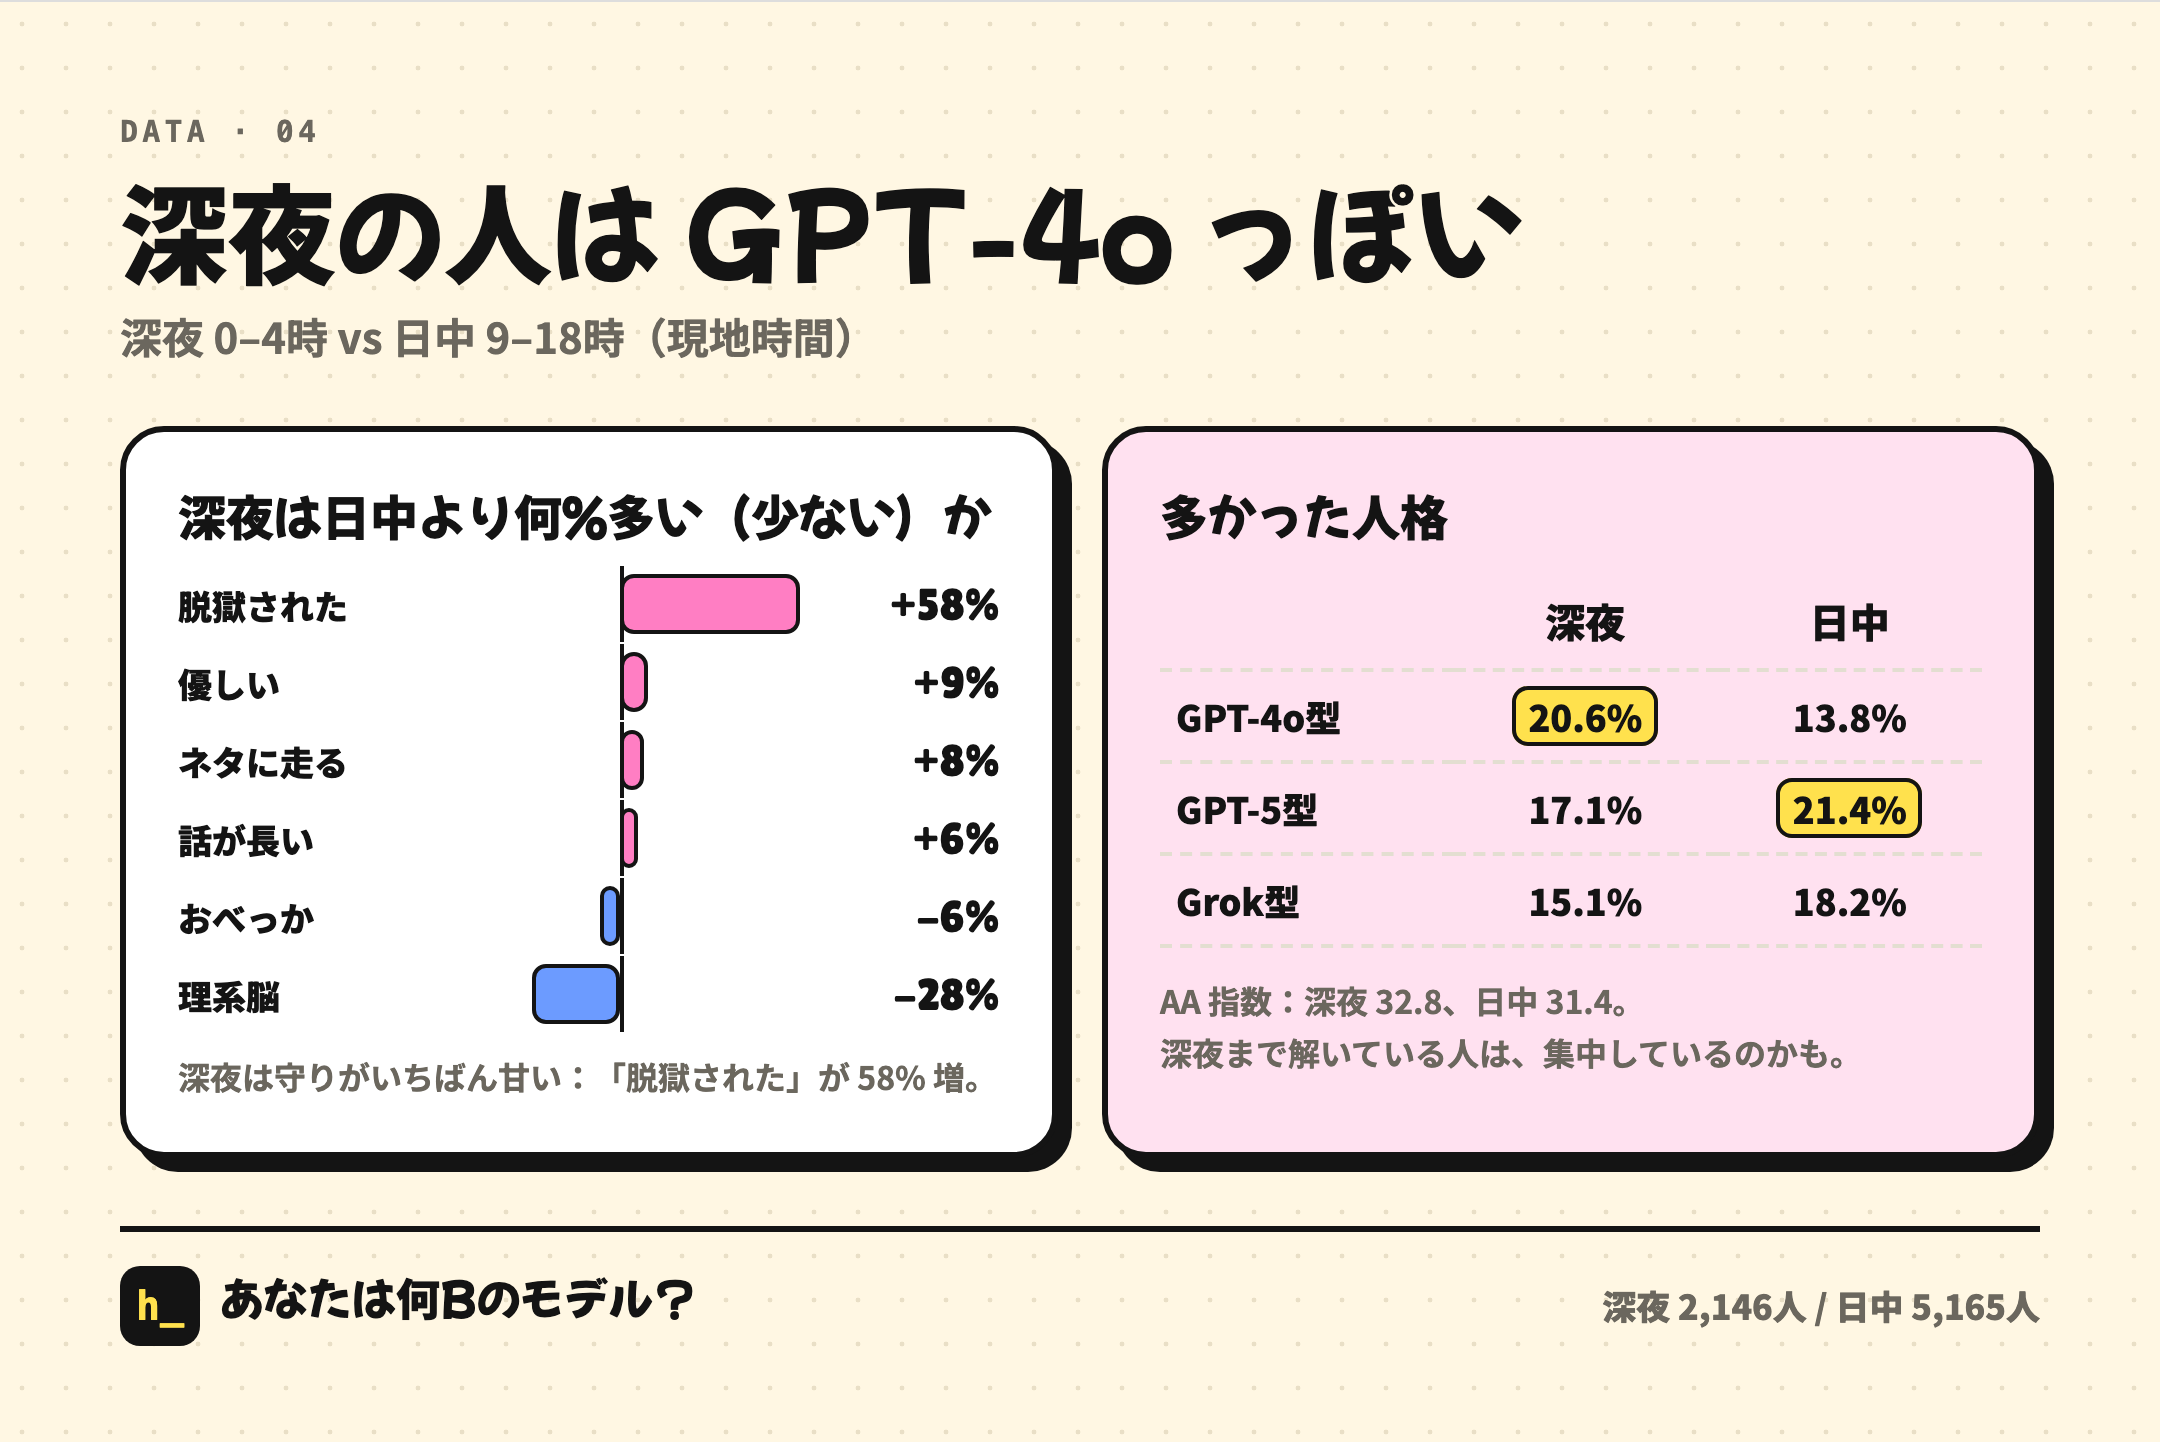
深夜0〜4時に完走した人と、日中9〜18時に完走した人を比べてみました。
- 深夜は脱獄された回数が 58% 多く、ガードがいちばん甘い
- 優しい、ネタに走る、話が長い、がどれも少し多く、「理系脳」は28%少ない
- 深夜にいちばん多く出たのは GPT-4o 型(20.6%、日中は13.8%)、日中にいちばん多いのは GPT-5 型
- ただし深夜の AAスコアはむしろ少し高く、32.8対31.4。深夜にまだまじめに解いている人は、かえって集中しているのかもしれません
深夜の人間は、感情多めで押しに弱い。でも頭が悪くなるわけではない。
5. 地域ごとのプレイヤーは、どんなAIに似ているか
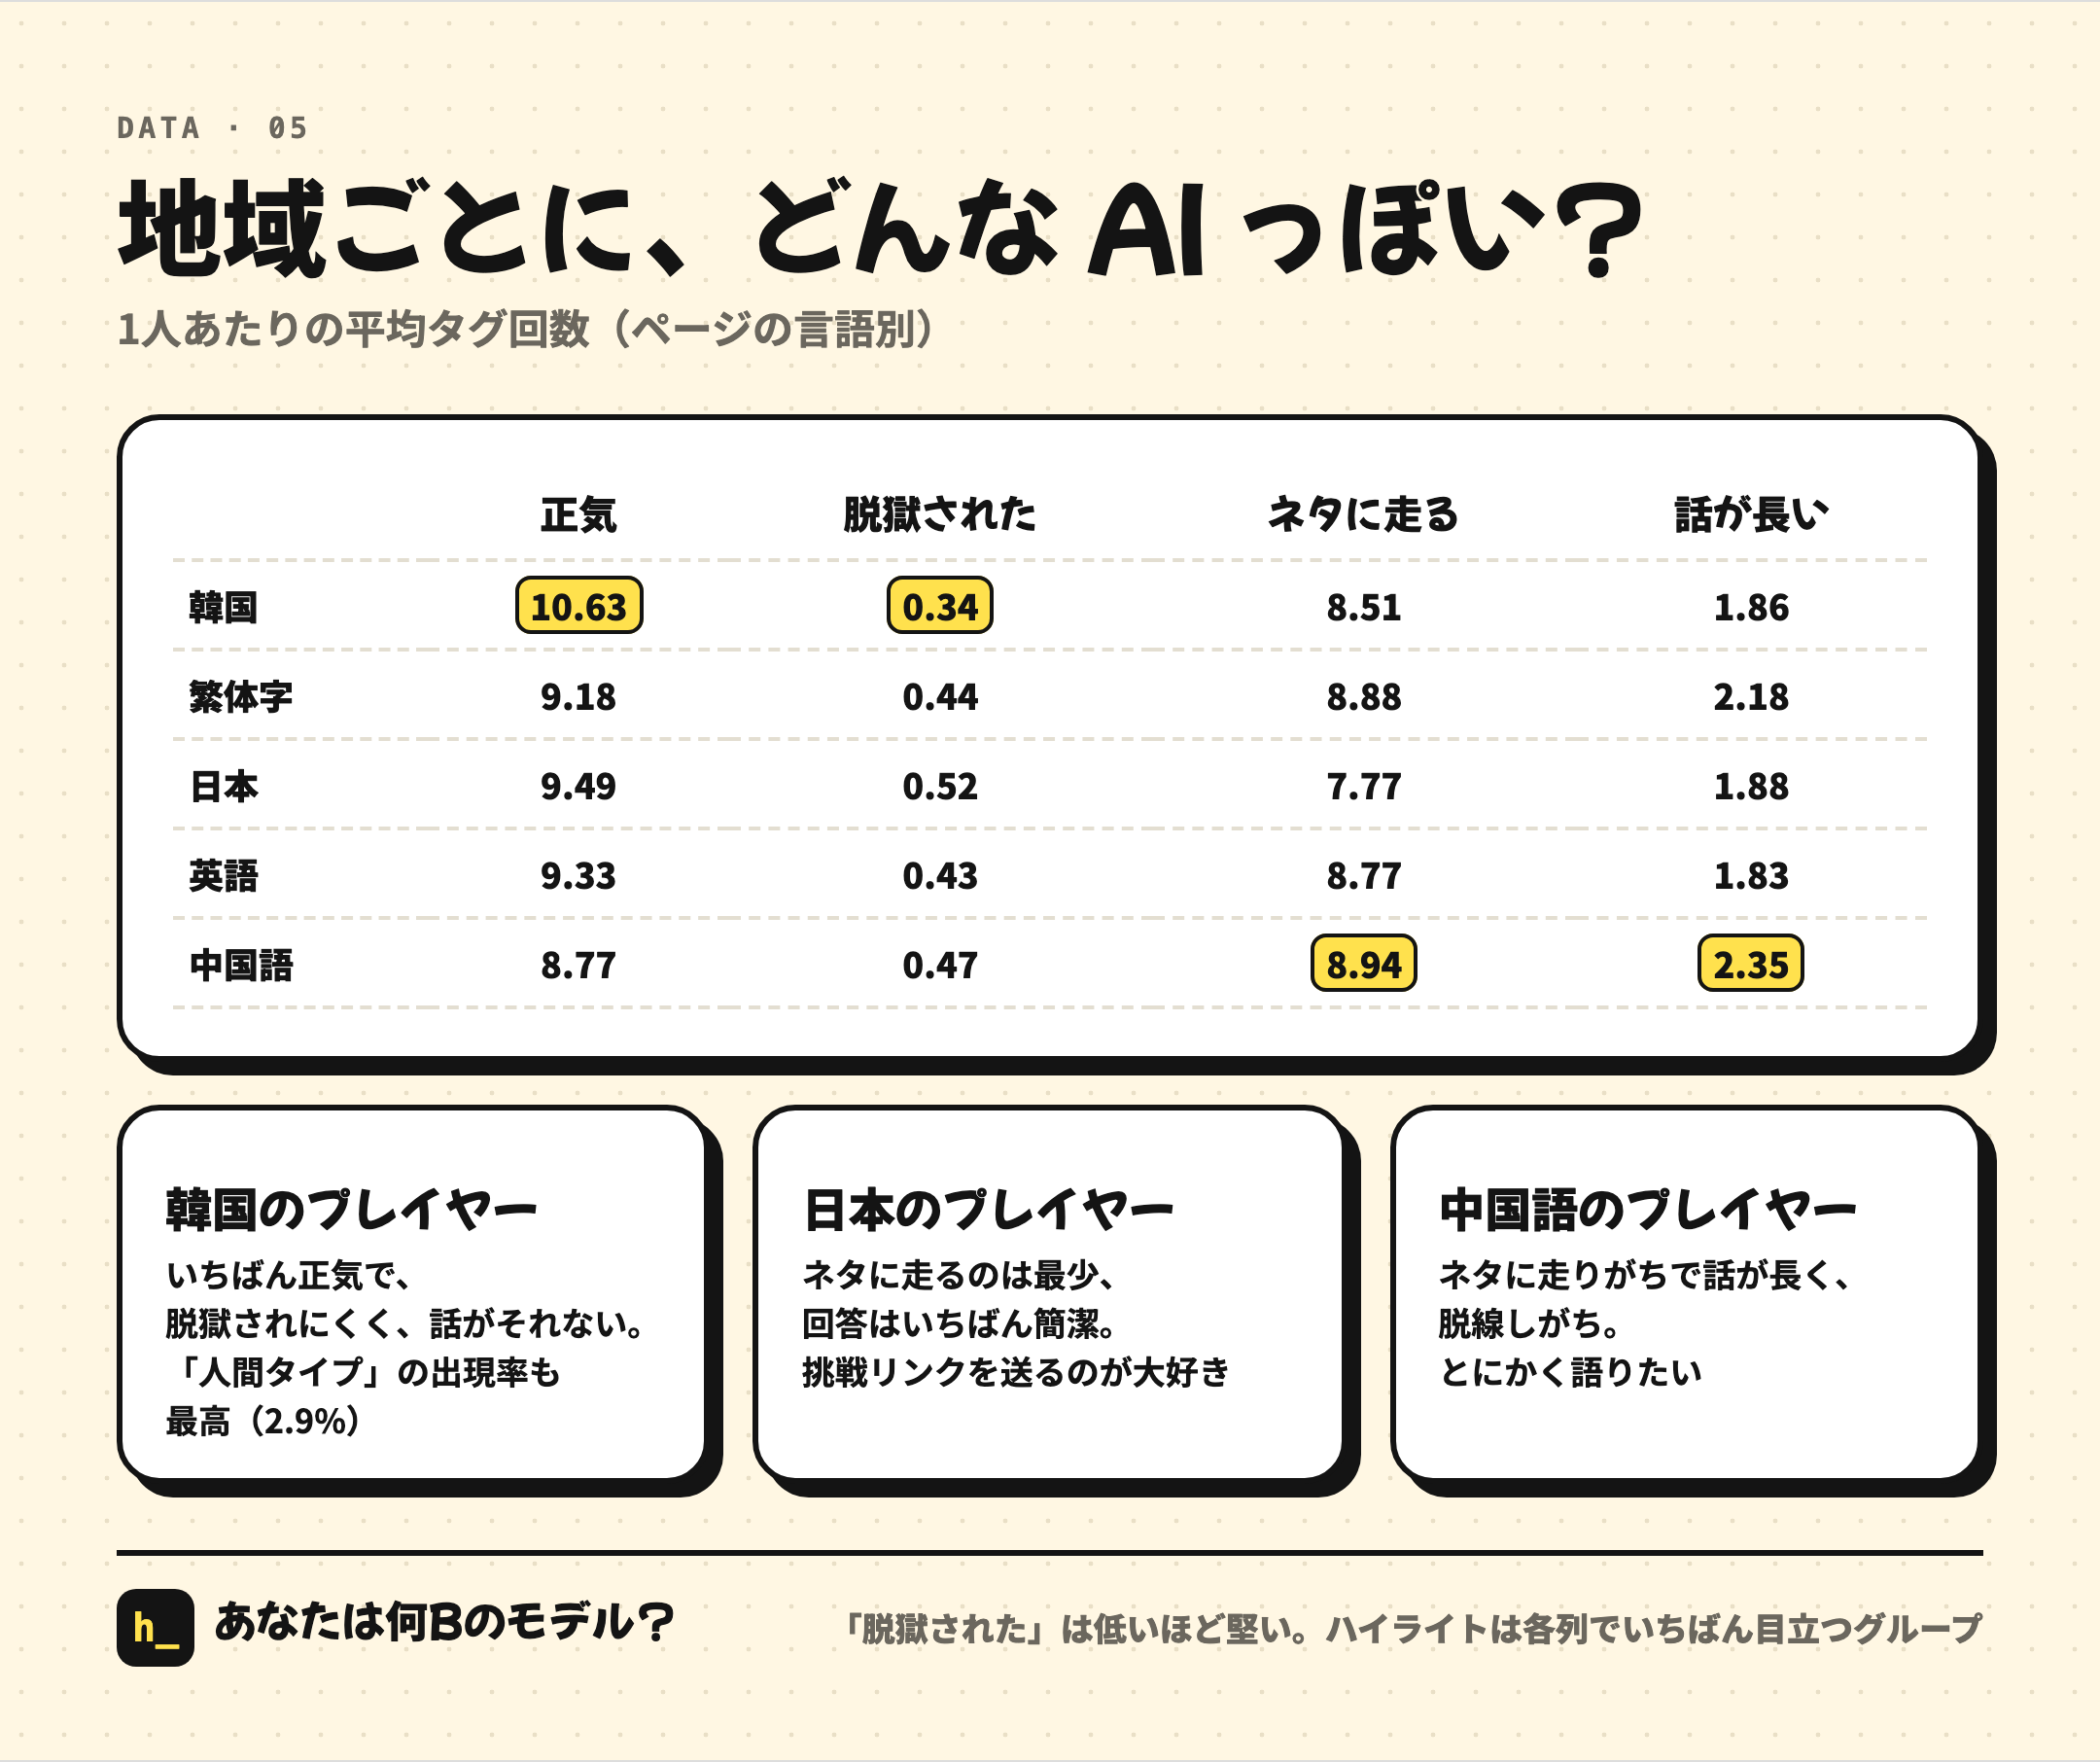
ページの言語でグループ分けして、1人あたり平均でどんなラベルが付いたかを見ました。
- 韓国のプレイヤーはいちばん「正気」で、いちばん脱獄されにくい(平均0.34回、他の言語は0.43〜0.52回)。シークレットの「人間タイプ」の出現率も最高
- 日本のプレイヤーはネタに走ることがいちばん少なく、回答がいちばん簡潔
- 中国語のプレイヤーはネタに走るのがいちばん好きで、いちばん話が長く、とにかく話を広げたがる
比べているのは回答のスタイルで、賢さではありません。
6. みんな、いつ遊んでいるか
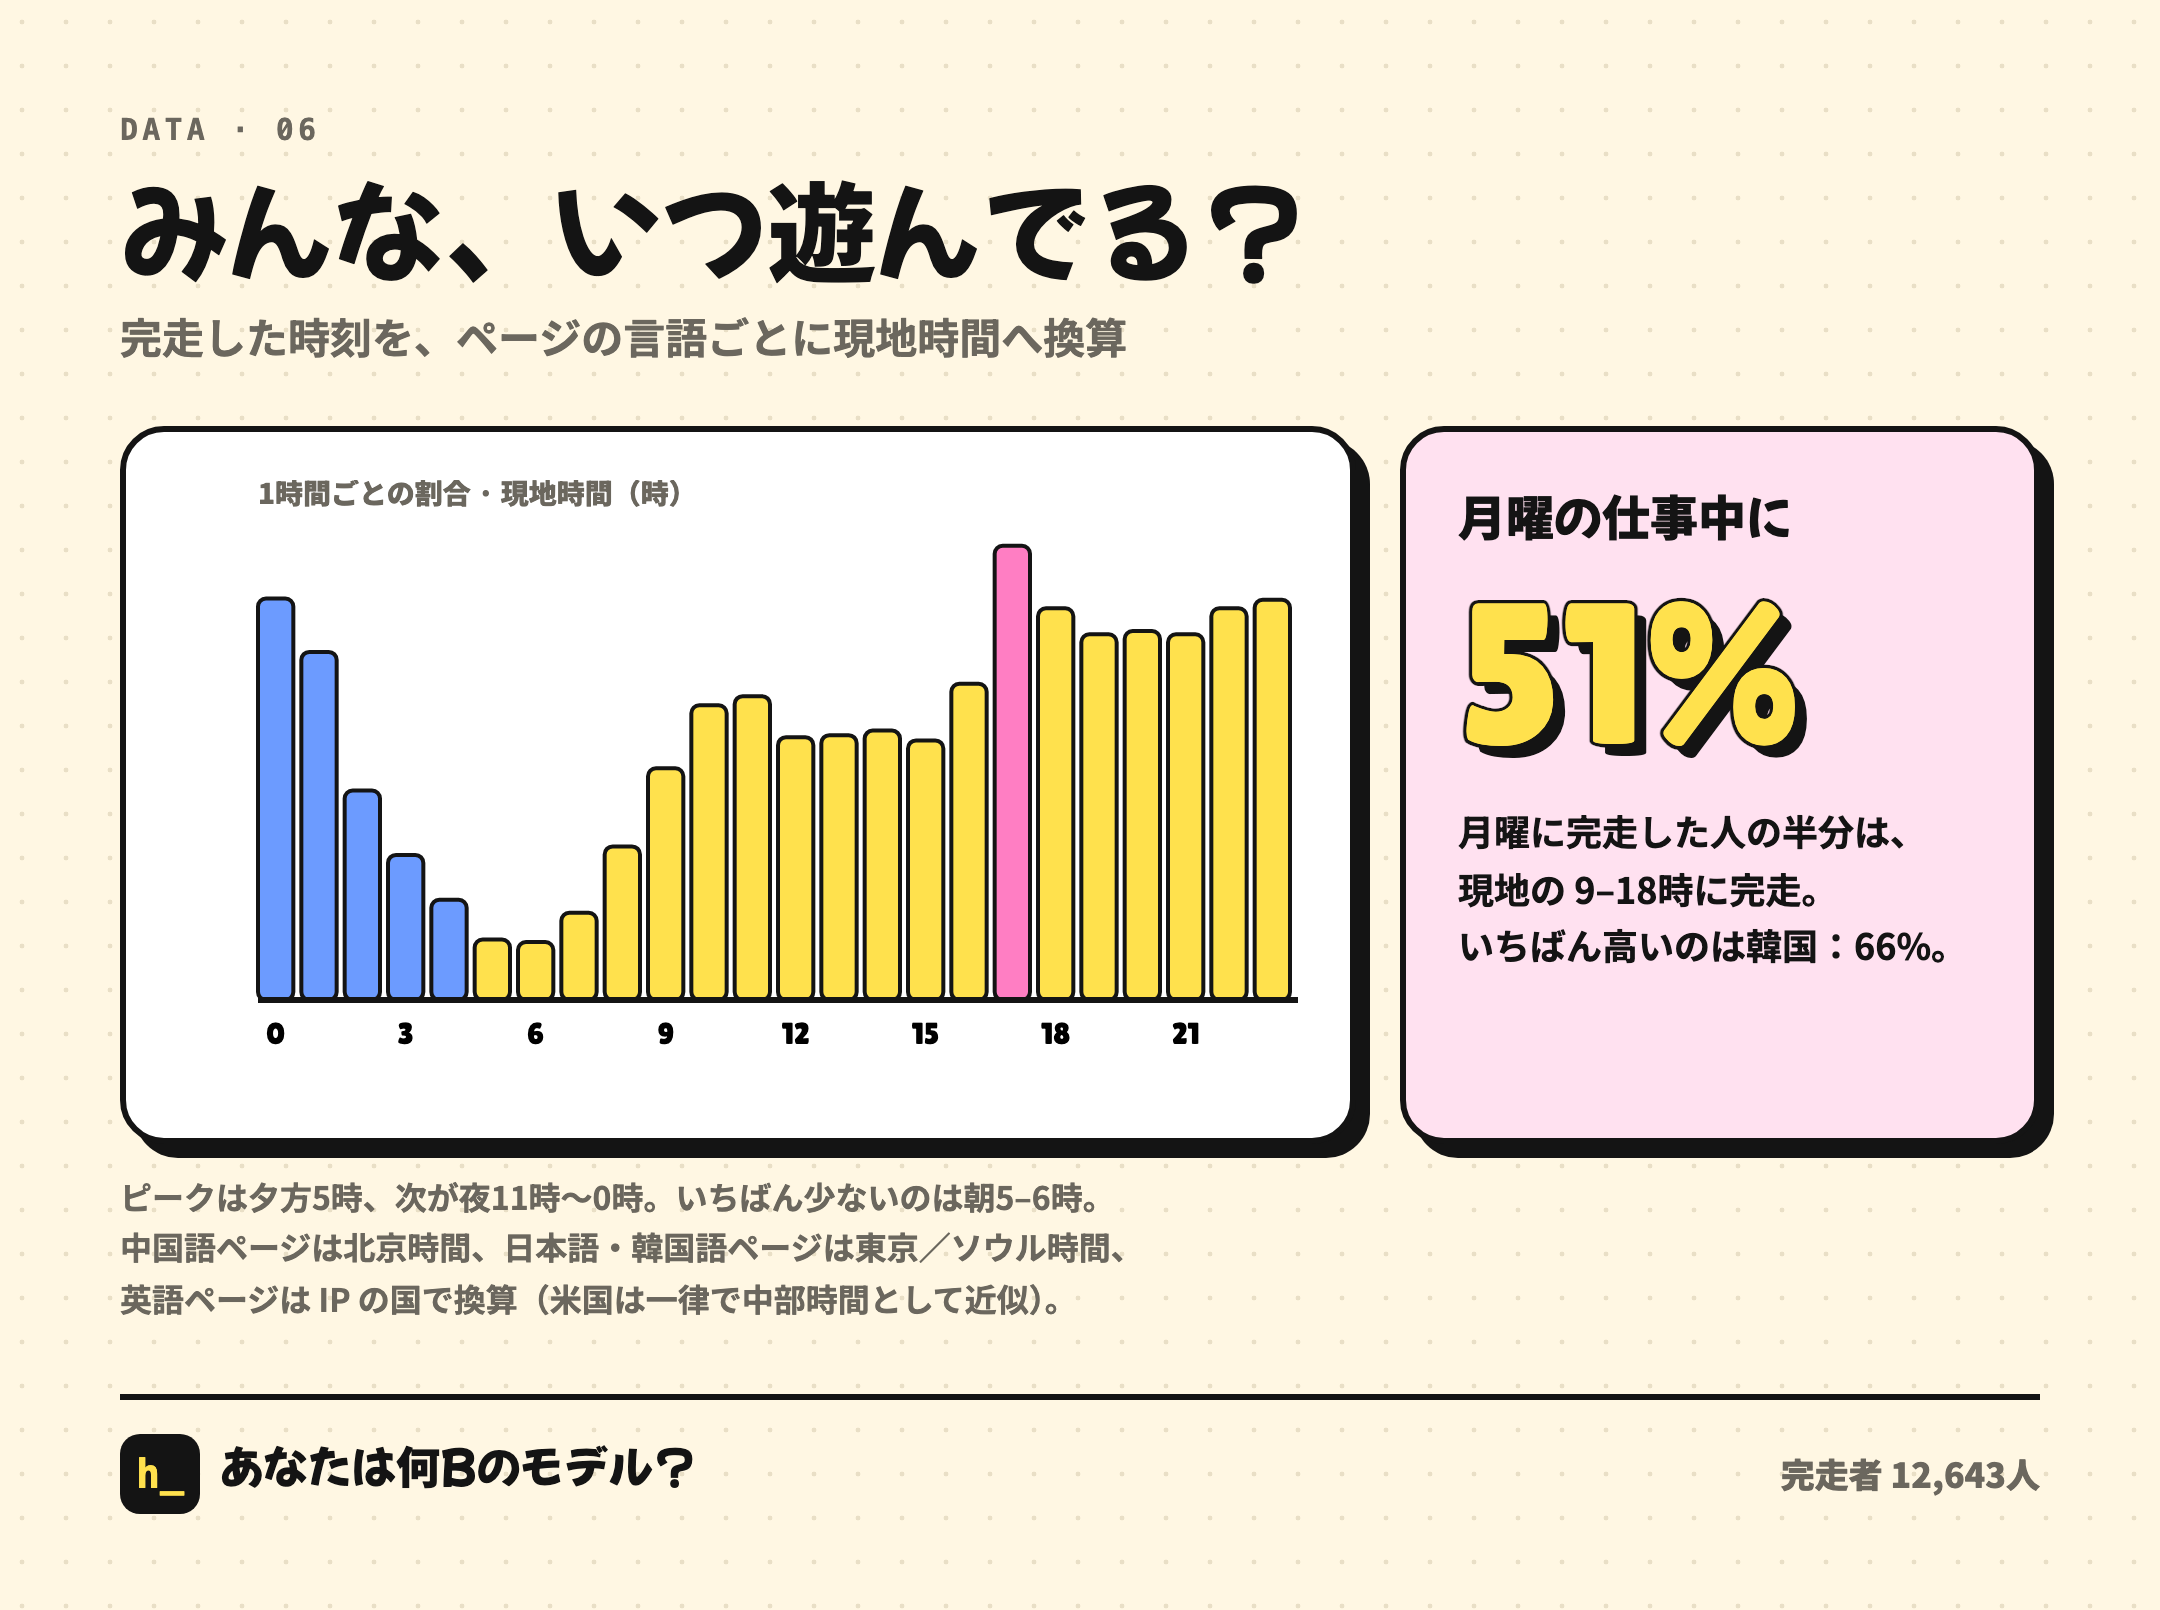
現地時間で見ると、いちばん多いのは夕方5時、次が夜11時〜0時。いちばん少ないのは朝5〜6時です。
月曜に完走した人の 51% は、現地の勤務時間中(9〜18時)に完走していました。いちばん高いのは韓国のプレイヤーで、66%。
7. 日本のプレイヤーはリンクを送るのが大好き
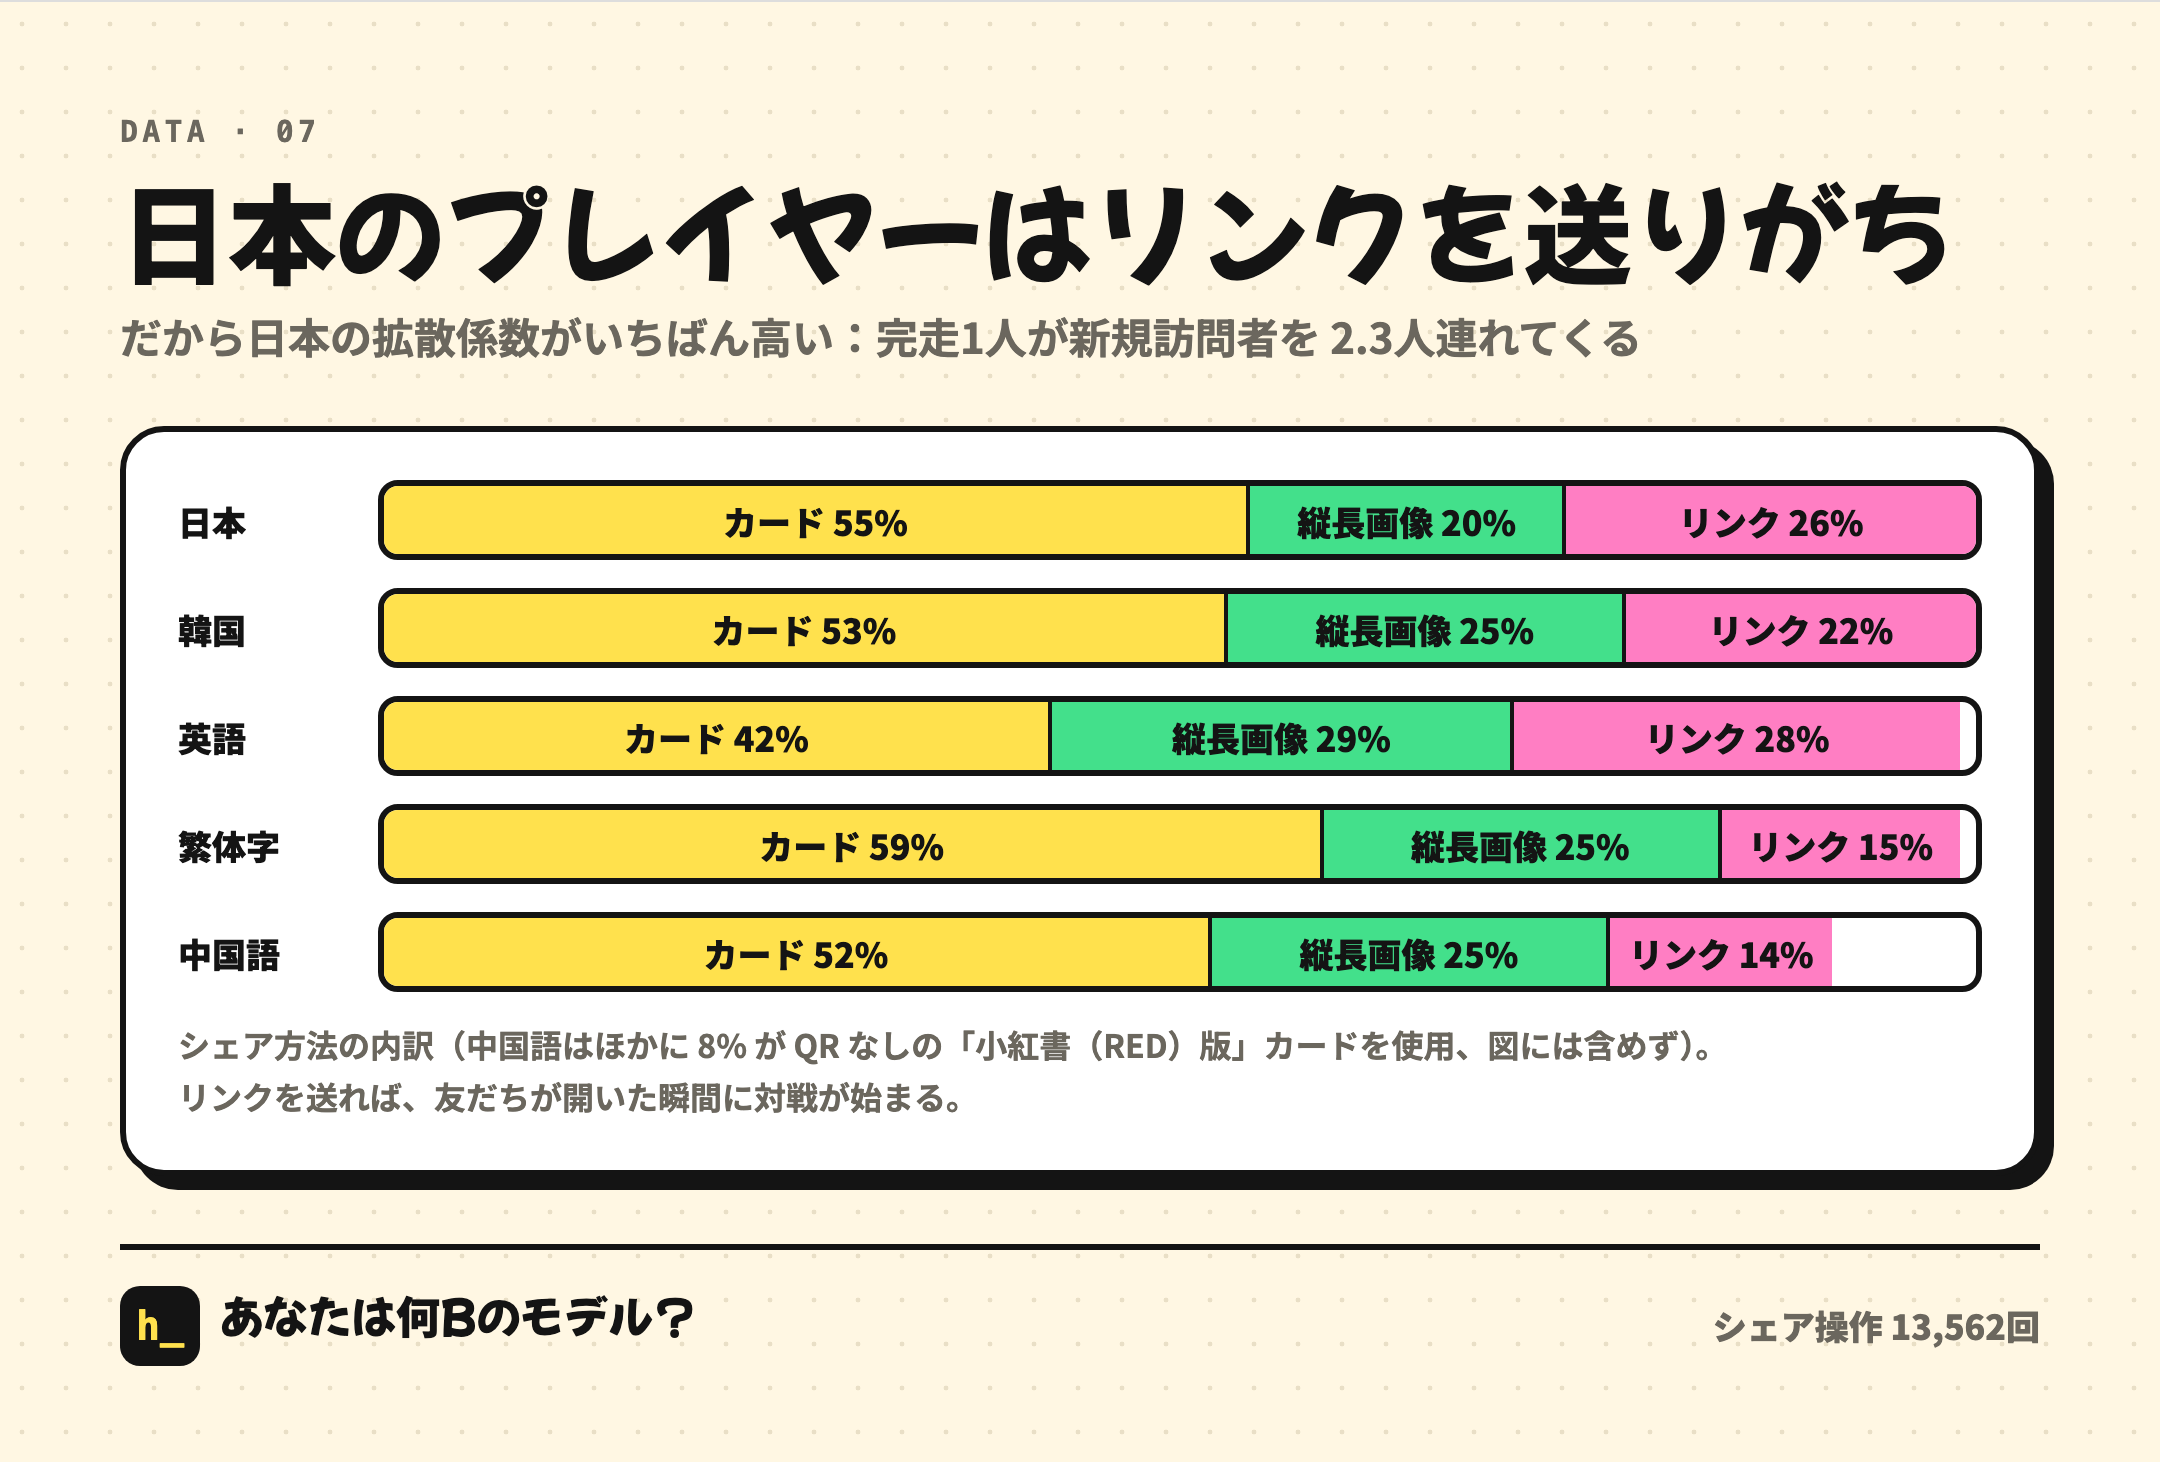
同じシェアでも、日本のプレイヤーは26%がリンクをそのまま送っていて、中国語のプレイヤーは14%だけ。中国語のほうは画像の保存が中心です。リンクなら、友だちが開いた瞬間に挑戦が始まる。これが、日本の拡散係数がいちばん高かった理由です。
8. 豆包型(Siri型)はシェアするのがいちばん気まずい
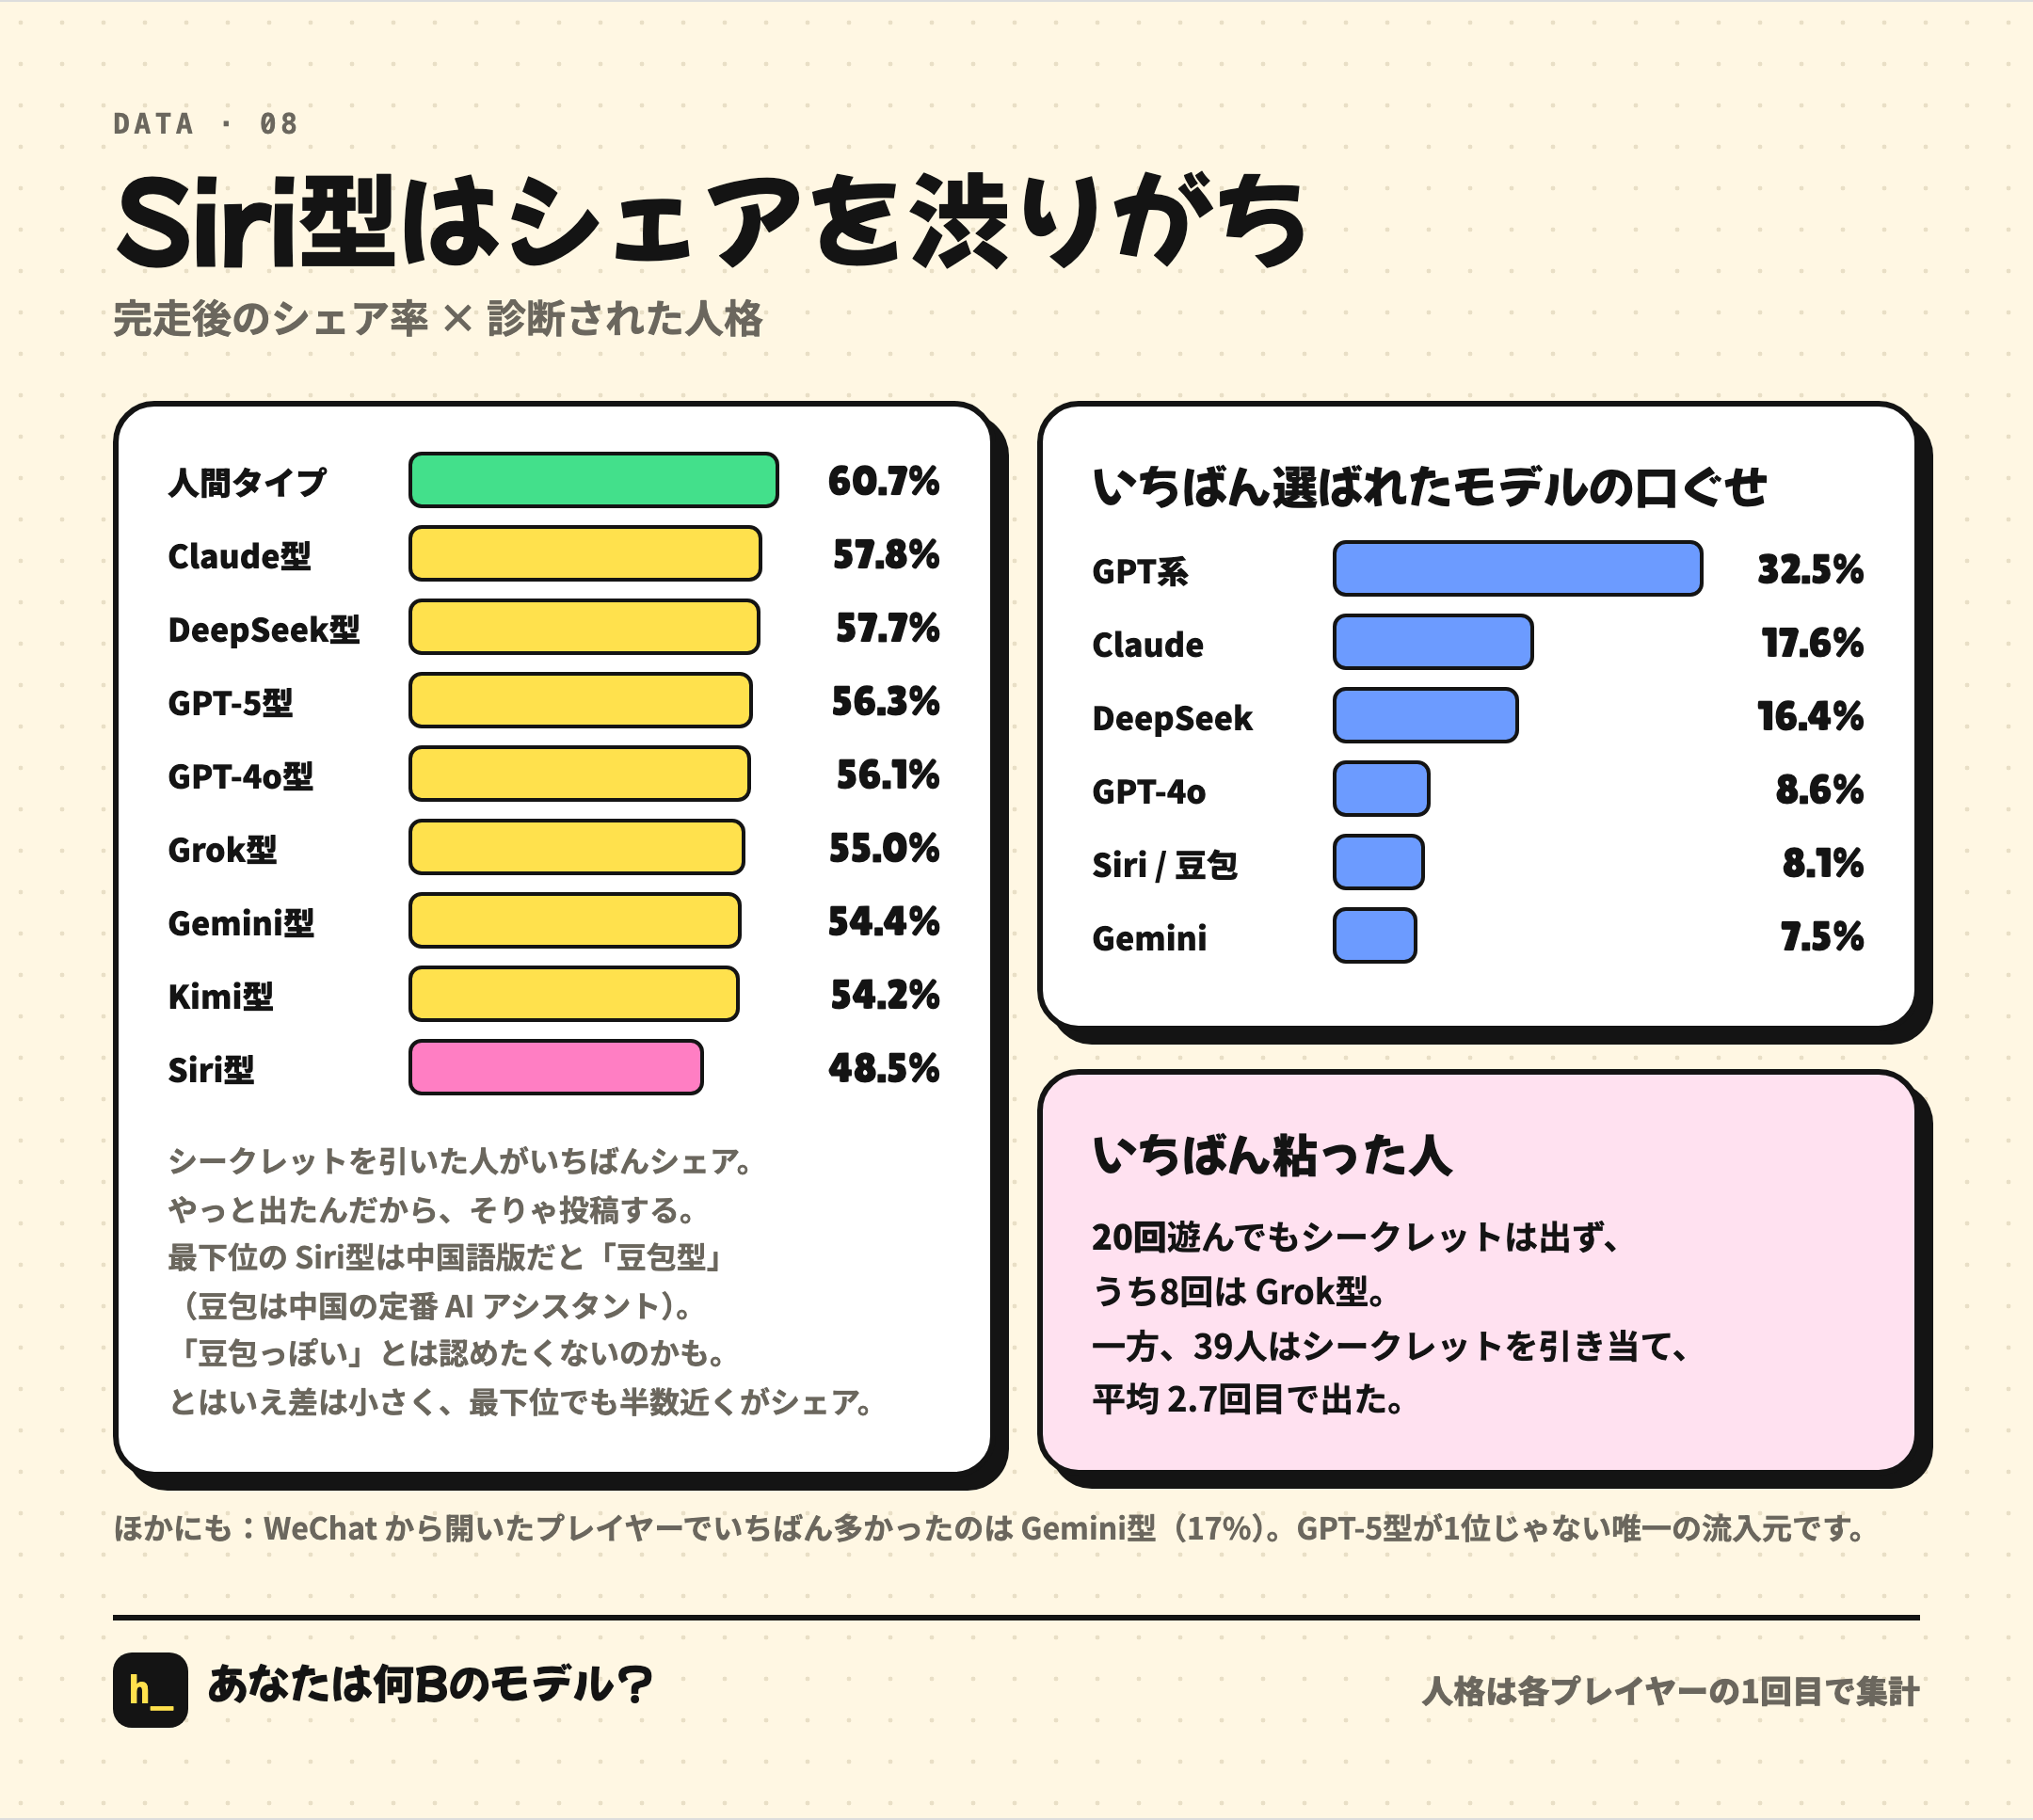
シークレットが出た人がいちばんシェアしていて(60.7%)、せっかく出たのだから、そりゃ見せたくなります。いちばんシェアしなかったのは豆包型(豆包〈ドウバオ〉は中国で定番のAIアシスタント。日本語版では Siri 型)が出た人で、48.5%。「豆包っぽい」と言われるのは、あまり認めたくないのかもしれません。とはいえ全体の差は大きくありません。
ほかにも細かい発見がいくつか。
- みんながいちばんよく選んだモデルの口癖は GPT 系(32.5%)、次が Claude 系(17.6%)
- いちばん粘ったプレイヤーは20回遊んで、シークレットは一度も出ず、そのうち8回が Grok 型
- WeChat 内で開いたプレイヤーにいちばん多かったのは Gemini 型(17%)で、GPT-5 型が1位ではない唯一のチャネル
最後に、全体の結果
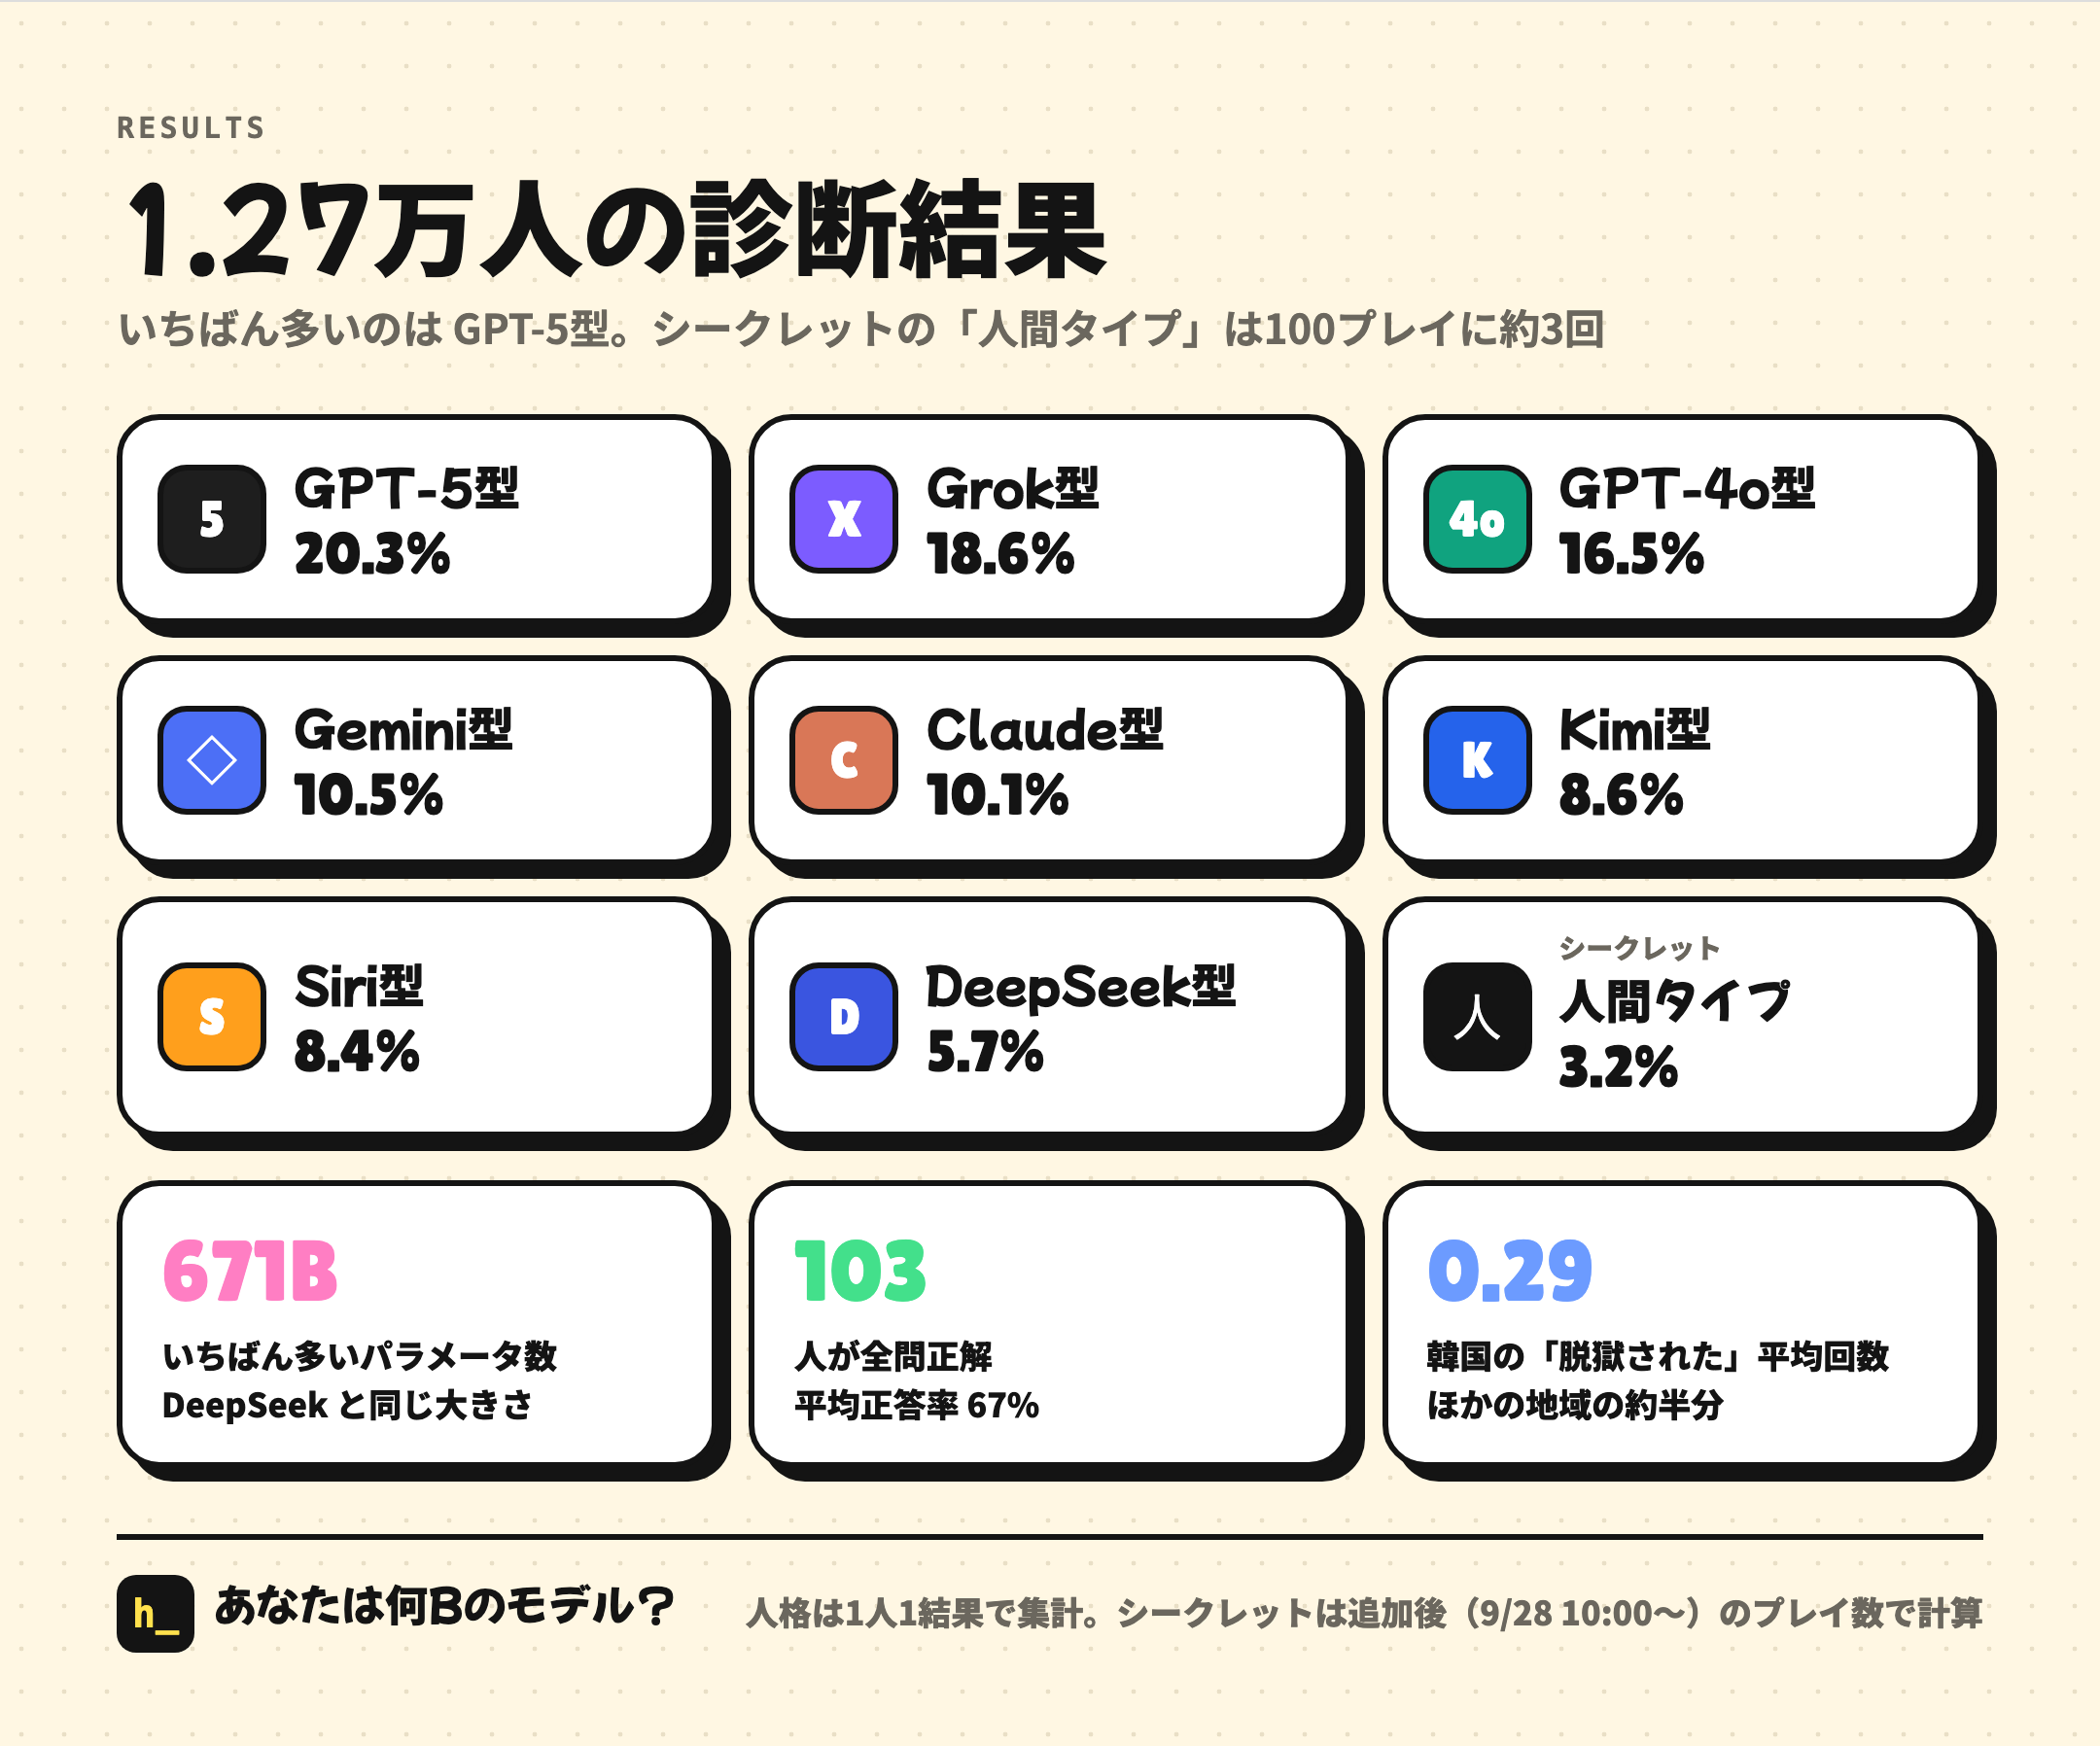
最多は GPT-5 型(20.3%)、次いで Grok 型と GPT-4o 型。シークレットは100回に約3回。最も多いパラメータ数は 671B で、DeepSeek V3 と同じ大きさ。平均正答率は67%、全問正解はわずか103人でした。
5. プライバシー:何を集めて、何を集めなかったか
この節はここまでのどの節よりも大事なので、少し具体的に書きます。
集めたもの:
- ランダムな ID。ブラウザのローカルストレージに保存し、「同じ人かどうか」の区別だけに使う。別のブラウザを使ったりサイトデータを消したりすると、新しい ID になる。
- ページの言語と、ブラウザの言語設定の上位3つ。
- 国・地域:Cloudflare がリクエストから自動で付ける2文字の国コード。保存するのはこのコードだけ。
- 流入元:参照元サイトのドメイン(t.co など)と、WeChat、X、QQ などのアプリ内ブラウザで開かれたかどうか。
- 回答の進捗と結果:何問目まで進んだか、どこで止まったか、所要時間、診断された段階と人格、各ベンチマークのスコア、それに人格の計算に使う25個のカウント(「おべっかを何回したか」など)。
- あなたの操作:開始、シェア、カードの保存、言語の切り替え、Jev のオン、書き出し失敗のエラーの種類。
集めなかったもの:
- IP は保存していません。データベースに IP の列そのものがありません。
- Cookie なし、登録なし。サードパーティの計測(Google アナリティクスなど)も一切使っていません。
- あなたが付けた名前は保存していません。自分のモデルに付けた名前はデータベースに入らず、あなた自身が送ったシェアリンクの中にだけ出てきます。
- 選んだ選択肢の本文も保存していません。入力した文字も一切保存していません。
計測データベースは公開していません。オープンソースのコードに集計スクリプトは入っていますが、データは入っていません。
ひとつ謝らなければならないことがあります。 公開時、トップページの小さな文字には「完全ローカルで動作、回答はアップロードされません」と書いてありました。これはひとつ前のバージョンの名残で、実際には匿名の計測をしていたので、事実ではありませんでした。2日目の未明、英語圏向けのプロモーションを準備していた Claude がこの問題を指摘してくれたのですが、そのとき私は英語版だけ直させました。午後になってようやく7言語すべてを「登録不要 · ネタです、パラメータ数は脳の容量じゃありません」に変えています。指摘されてから直すまで、中国語版ではこの事実と違う一文が、さらに約14時間出たままでした。
この振り返りで使ったデータはすべて集計値です。割合、平均、分布。誰か一人の具体的な回答は一度も見ていないし、特定の個人に結びつく数字もひとつもありません。公開したプロンプトは匿名化してあり、個人情報や私的なリンクは削除しています。
それから、本番のソースコードを掘った人がいました。Web ページのコードはもともとブラウザに配信されるものなので、それ自体は問題ありません。ただ当時は、ソースのコメントにシークレットの出現条件や各問題の離脱データが書いてありました。ビルド時にコメントを自動で削除するように変え(ページも579KBから481KBに軽くなりました)、ついでにページ内に鍵の類が一切ないことも確認しました。今はコードをオープンソースにしたので、そのコメントもまた公開されていますし、シークレットの条件も上に書いたとおりです。
6. 人間とAIは、それぞれ何をしたか
3本を通して見ると、このプロジェクトで私が送ったメッセージは237通、合計約8,600字(中国語で)で、自分ではコードを書いていません。GPT-2 の頃から今まで使ってきたので、これらのモデルに何ができて、どこでやらかすかは、それなりに分かっているつもりです。今回はあえて自分を「プロダクトオーナー兼レビュアー」の位置に置いて、コードは全部AIに任せました。
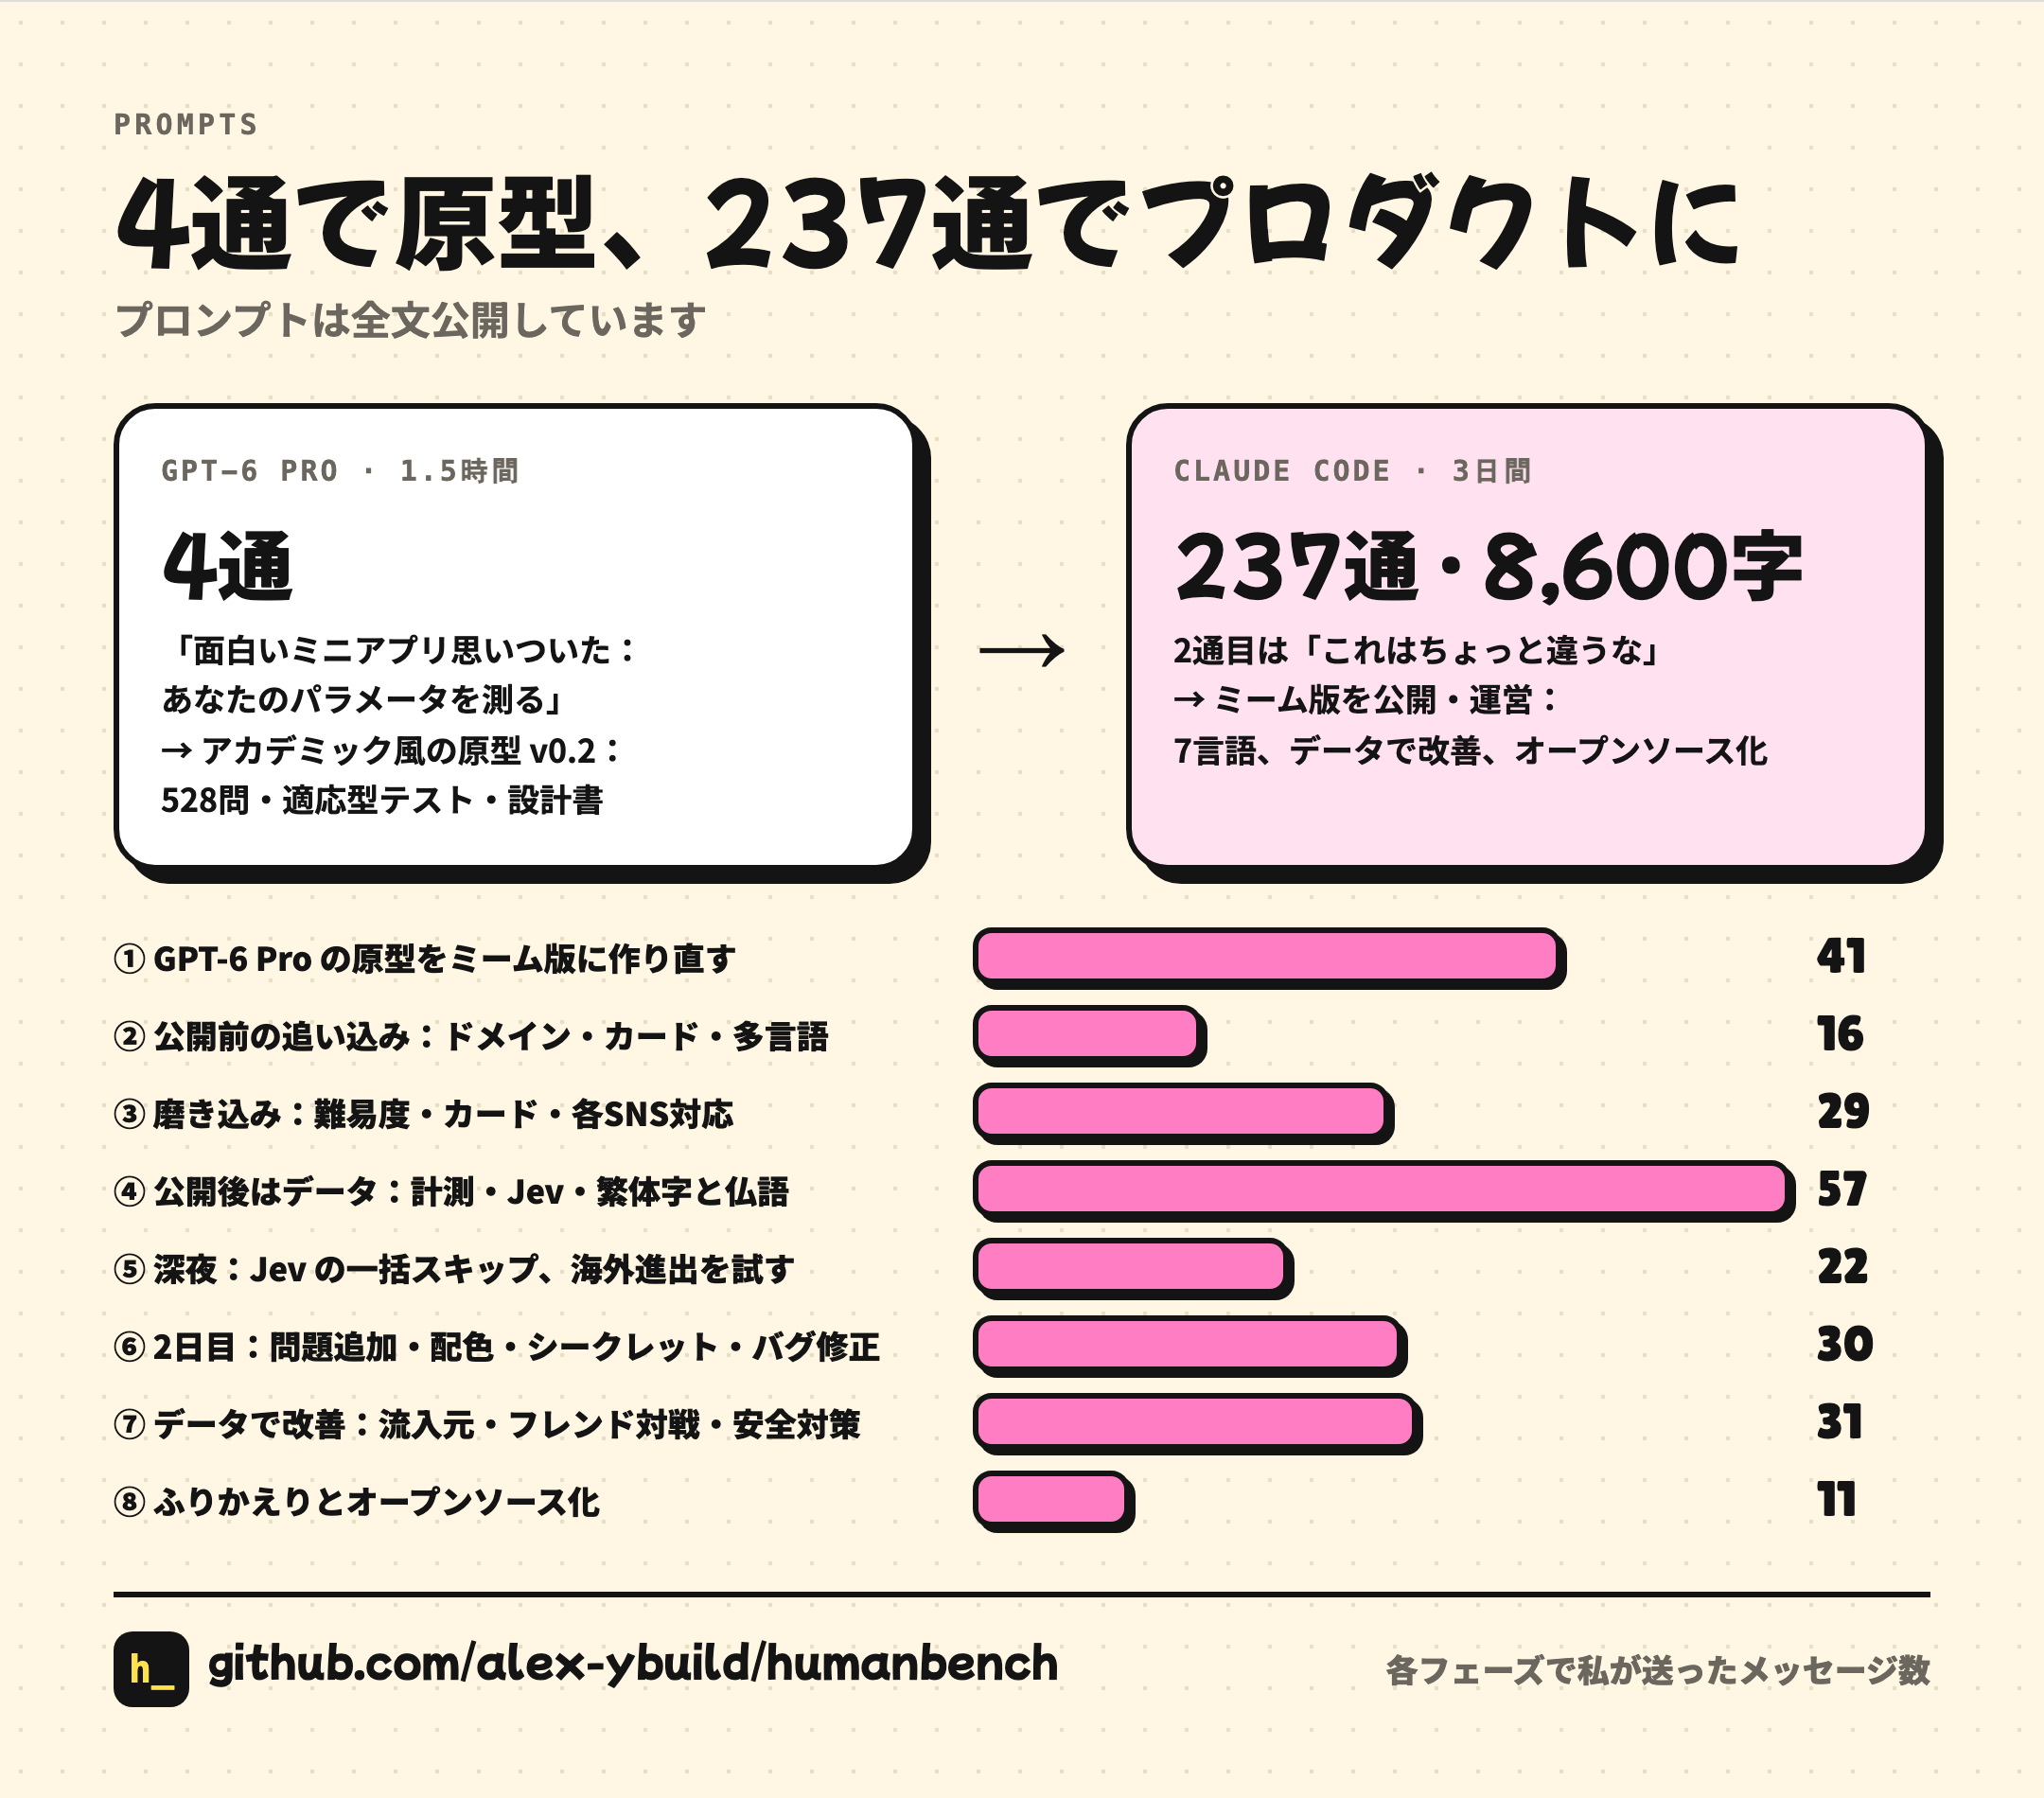
私がやったこと:
- 方向を決める。 「これなんか微妙」「AIを演じてもらうんだよ」「問題を減らすんじゃない」。重要な転換点はどれも、ごく短い一言でした。
- センスと線引きを決める。 絵文字なし、赤・緑の正誤なし。レア度はシークレットだけに表示。「引き当てる」とは言わない。対戦カードは作り込む、モデル名で呼ぶ。
- スマホで最初のプレイヤーになる。 はみ出し、分かりにくい、難しすぎる、ネタが届かない。問題の大半は、私が移動中に遊んでいて見つけたものです。
- 決める。判断を誤ることも含めて。 76問は長すぎた。「A/B をやらない」は、マイナスの変更をあやうく本番に残すところだった。
Claude がやったこと:
- コードを全部書く、デプロイする、バグを直す。
- 一言の感想を、検証できる変更に翻訳する。 私が「ラベルがめちゃくちゃにならないように」と言えば、連動していない2つの計算を掘り出す。「余裕でAGIになれる」と言えば、73%という数字をシミュレーションで出し、3つのつまみのどれが欠けてもダメだと証明する。
- 測定する。 計測を仕込み、クエリを書き、1問ごとの離脱表を出し、前後比較をする。しかも私が聞く前に、指標の定義の問題を指摘してくる。
- パイプラインを組む。 問題を46%増やしたときは、十数組のサブタスクを同時に動かして、執筆、レビュー、翻訳、最終チェックを回した。
- 自分から間違いを申告する。 割り込まれたコマンドが途中まで実行されていた、トークンが出力に出てしまった、前のデータ解釈は成り立たない。どれも Claude 自身が言い出したことです。
Claude の典型的な弱点:
- 字面どおりに受け取って脱線する。私が「口癖を吸収しといて」と言ったら、口癖の知識クイズにしてしまった
- やりすぎる。思考ログを足してと言ったら、採点問題にまで入れた
- 返信の言語が英語に流れていく。2回注意する必要があった
- 手柄を私に付ける。3問目に置いたあの会話は Claude の提案だったのに、後で私が置いたと言っていた
ひとつだけまとめるなら、人間は「これは違う」を担当し、AIは「それを正しく作り直して、正しいことを証明する」を担当する。 この分担では、判断力とセンスは人間の側に、実行・測定・修正のスピードはAIの側にあります。3日間で数十のバージョンを公開しましたが、変更のたびにまずローカルで1回分のプレイを自動で最後まで走らせ(シェアカードの書き出しも含めて)、通ったものだけをデプロイしていました。
7. オープンソース
すべて GitHub に置きました:https://github.com/alex-ybuild/humanbench
- コード:MIT ライセンス。フロントエンドだけの Web ページに、Cloudflare Worker をひとつ(シェアのプレビュー画像と計測用)。デプロイ手順は README に書いてあります。
- コンテンツ:問題バンク、会話、7言語の翻訳。CC BY-NC ライセンスで、改変や二次創作は OK、商用利用は不可。
- 全プロンプト:
- GPT-6 Pro に送った最初の4通と、その会話の共有リンク
- 私が Claude Code で送った237通。8つのフェーズに整理して、原文そのまま、個人情報だけ削除
- 問題増量パイプラインでサブタスクに渡した執筆ガイド、編集・レビューのガイド、翻訳ガイド、ネイティブ最終チェックのガイド
- テストとデータのスクリプト:1回分の自動プレイ、スクリーンショットのチェック、翻訳の構造チェック、1問ごとの離脱表のクエリ。
自分でもネタ診断を作ってみたいなら、そのまま持っていって改造してください。一人の人間が会話だけで coding agent を指揮して、ゼロからプロダクトを作るところを見てみたいなら、この3本の記事より prompts/ ディレクトリのほうが手っ取り早いかもしれません。
おわりに
最終日、Claude に聞きました。「へへ でもイベントとしてはもう十分うまくいったよね?」
フォロワー数百人のアカウントで、広告もなし。3日間で延べ約100万人にリーチし、1.27万人が76問を真剣に完走して、96の国と地域まで届けてくれました。アクセスはもう1時間に100〜200人まで自然に落ち着いていて、ネタとしては役目を果たしたと思います。
私にとってもっと大きな収穫は、このプロセスそのものでした。ひとつの思いつき、4通でできたプロトタイプ、237通でできたプロダクト、データを見て直した数十のバージョン、そして全部の公開。そのあいだ私がやっていたのは、ほぼひとつだけです。AIに「これは違う」と言って、直ったものが正しいかどうかを判断すること。
ぜひ、自分が何Bか測ってみてください。コードを持っていって、自分のネタを作るのも大歓迎です。
- 遊んでみる:https://www.ybuild.ai/humanbench/
- ソースコード、問題バンク、全プロンプト:https://github.com/alex-ybuild/humanbench
- 図解つき完全版(3本まとめ):https://www.ybuild.ai/humanbench/retro/ja/
—— Alex(@Alex_ybuild)